聚类分析:不知道样本有几类 去划分
判别分析:已经知道种类去划分
注意:
判别分析中:加入了协方差,两个总体X Y 给定A点,需要考虑协方差,虽然a可能距离X近,但是从标准差的角度来看,可能距离Y更近,偏离均值的程度sigma更小
基本思想:a到X的距离 - a到Y的距离, 如果大于0 则为Y
各判别变量之间具有多元正态分布,即每个变量对于其他变量的固定值有正态分布。当多元正态分布假设满足时,可以使用参数方法,
每一个判别变量都不能是其他判别变量的线性组合。当一个判别变量与另外一个判别变量高度相关时,虽然能求解,但是误差将会很大。
贝叶斯判别
先验概率 p1 p2 来自总体的先验概率
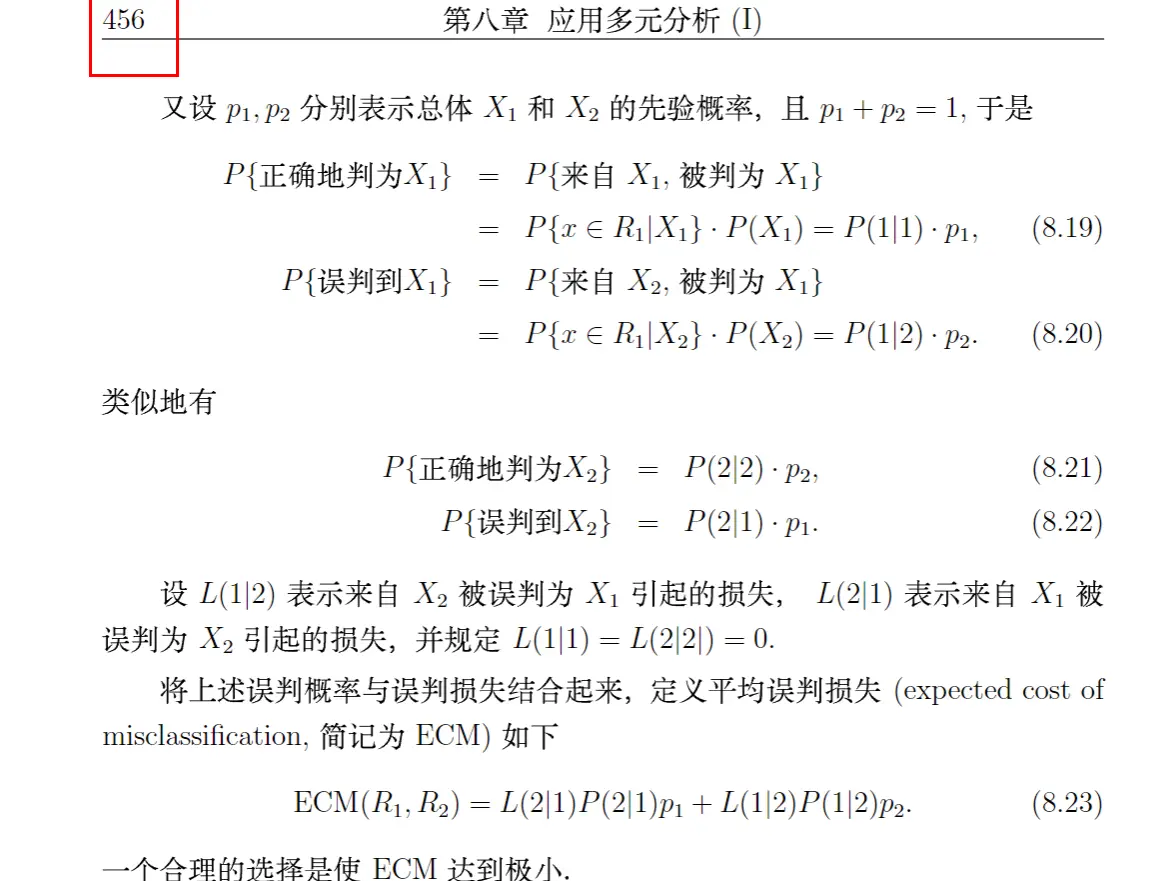
思想:加入了判别损失
函数,损失最小
距离判别
假设: 满足多元正态分布总体
缺点:
- 没有考虑总体分布的大小。 也就是总体各个取值范围的不同,
- 马氏距离是基于数据点之间的协方差矩阵和均值之间的差异计算的,它在考虑了特征之间的相关性和尺度差异后衡量了样本之间的距离。但是,它并没有直接纳入考虑总体分布的大小。
总体分布的大小指的是样本的数目或者在某个特定区间内的数据密度。在一些情况下,样本量的大小或者不同类别之间的数据分布的不均衡可能会影响距离判别分析的效果。例如,如果某个类别的样本量远远大于其他类别**,距离判别可能会更倾向于那个样本量大的类别**。
为什么总体分布越大 导致距离判别方法更加偏向于样本量较大的类别?
总体分布越大(样本量越多),对总体估计越准确,可以理解为数据波动越小, 因为马氏距离最后是均值除协方差。波动越小,越容易归类
在判别分析中,当提到总体分布大小时,通常指的是不同类别之间的样本量差异。这涉及到各个类别中样本数量的相对大小。
总体分布大小在判别分析中可以影响模型的训练和决策边界的确定。当一个类别的样本量远远大于另一个类别时,模型可能更偏向于以样本量较大的类别的统计量(如均值和协方差)来进行分类。
FISHER 判别
将k维数据投影到某一个方向,使得投影后类间的差异最大。在判定类间差异的问题上,Fisher借鉴了一元方差的基本思想。由于Fisher判别法对总体的分布没有任何要求,因此该判别法也被称为典型判别法。
1,经过矩阵转换后的数据在某个投影方向上类别间差异最大化
,它们之间的区别都不是很显著(在实际计算中,可以通过不同类别间均值差异来衡量区分效果)。可是如果将坐标旋转至X’Y’方向,将样本沿着X’方向投影于Y’轴上,可以看出,投影后类别间的区分效果就比较好了。
把上述过程推广到多维的情形。在多维的情形下,好的投影是使得变换(即几何上的旋转坐标轴)后同类别的点尽可能在一起,不同类别的样本点尽可能的分离。Fisher判别法的实质是在寻找一个最能反映类与类之间差异的投影方向**,即线性判别函数。**一个好的线形判别函数U(X)=C’X,在k个总体G1, G2, …, Gk中去求均值,所得到的k个值,应当有较大的离差,这就是Fisher准则。这里,离差的意义如下:
其中,为来自k个总体的样本(即来自这些总体的一维或多维随机向量);Ei和Di表示在第i个总体中的均值和方差。
当确定线形判别函数U(X)之后,计算U(X)到各个总体的距离,判定为来自距离最小
总体1 总体2有共同的协方差矩阵什么意思?是说总体1各个随机变量之间的协方差矩阵和总体2各个随机变量之间的协方差矩阵一样吗
是的,您理解得正确。当说总体1和总体2具有共同的协方差矩阵时,指的是总体1中各个随机变量之间的协方差矩阵和总体2中各个随机变量之间的协方差矩阵是相同的。
LDA SSbetween/SSwithin的值最大,找到一个加权系数,线性的判别方式