典型相关分析CCA是能够**揭示出两组变量之间的内在联系。考察两个整体之间的关系,将整体表示成为两组变量各自特征的线性组合.求解目标:降维后两个数据集转化为两个指标,要求相关性最大。前提
- 组间确实具有相关性
- 组间具有联系
- 冗余分析是回归思维,强调X影响Y,比如环境影响丰度。CCA是相关性思维,X Y相关。CCA要求组间的变量需要有关系
交叉载荷:X组的变量如何影响Y的电典型变量,如果比较大 说明X Y中的信息有冗余
p 值显著,说明典型变量间不相关的概率很小**,即典型变量间大概率是相关的,至于多大的相关程度是不能判断的。在所有的线性组合中, 找一对相关系数最大的线性组合, 用这个组合的单相关系数来表示两组变量的相关性, 叫做两组变量的典型相关系数, 而这两个线性组合叫做一对典型变量。
- 典型相关分析(CCA)用于研究一组X与一组Y数据之间的相关关系情况。它是借助主成分分析思想,从两组变量中提取出一个或少数几个综合变量(即典型变量),从而将对两组变量关系集中到**少数几对典型变量间的关系之上。
统计学高级 CCA推导
D(X)方差的计算公式 E(x)可以看作上述
cov(X) 协方差的计算公式
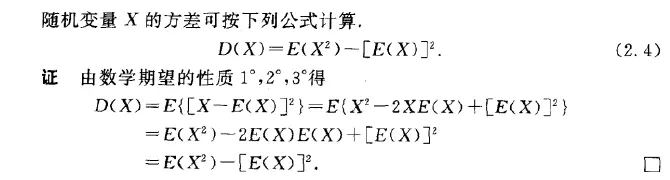
下面的X1 X2是样本
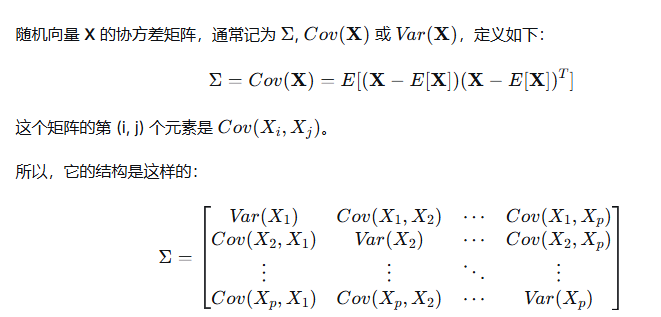 矩阵 X的方差 也是一个矩阵
注意 公式推导的问题,在数字中难以转换
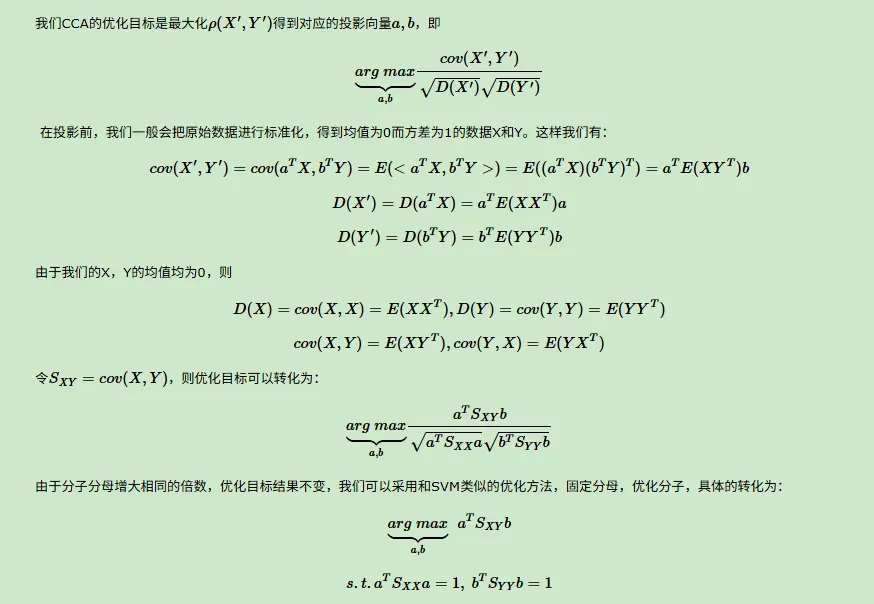
- SVD
- 特征值求解
最后是求拉格朗日的^2 , 求出偏导为0,就是极值
- **典型变量 : ** 通常表示将 **数据X投影到 由 A 定义的空间。每个样本的表示是这些基向量的 加权和
- 通过广义特征值问题求解载荷矩阵 :
为了找到典型变量 解载荷矩阵A B。这一步是通过求解广义特征值问题**来完成的。
具体的广义特征值问题如下: 这里, lambda是特征值(通常是典型相关系数的平方),而 A 是特征向量(即典型载荷矩阵)。
- 特征向量表示数据变化的方向(或在新空间中的坐标轴)。
- 载荷矩阵是通过这些特征向量构建的,描述了原始变量在这些方向(新空间)上的“权重”或“贡献”。
[最大化].(https://www.cnblogs.com/pinard/p/6288716.html)
01理论/线性代数/加权与投影
-
载荷矩阵:在CCA中,载荷矩阵 p_x p_y 分别表示数据集 x和y 中的原始变量在典型变量上的贡献。它们是通过左奇异向量和右奇异向量与原始数据矩阵相乘得到的。
如何解读得分图?
-
样本之间的相似性与差异性:
- 在得分图中,靠近的样本(即在X轴和Y轴上坐标相近的点)表示它们在两个数据集中的关联性较强,可能有相似的特征或行为。
- 远离的样本表示它们之间的关联性较弱,或者它们在两个数据集中的表现有较大的差异。
-
样本聚类:
- 得分图可以帮助识别样本中的自然分组或聚类。例如,如果样本在得分图中呈现出明显的分组结构(例如,有多个簇),则说明这些样本在两个数据集之间有某种程度的共同特征或模式。
- 异常值:
- 如果得分图中的某些样本与其他样本分布差异较大,可能说明这些样本是异常值。异常值通常在得分图中表现为位于远离其他样本的区域。
- 典型变量解释:
-
得分图中各个坐标轴表示的是样本在不同典型变量上的得分。你可以根据载荷图来解释这些典型变量代表的数据特征。例如,第一典型变量可能代表的是两个数据集之间最强的相关性方向,第二典型变量则可能表示次强相关性。
-
箭头:可以使用箭头表示每个原始变量的载荷,箭头的方向表示原始变量与典型变量的关系,箭头的长度表示该变量对典型变量的贡献程度。
-
点:也可以使用点来表示原始变量的载荷,点的坐标表示原始变量在两个典型变量上的贡献。
- 变量之间的关系:
- 靠近的变量:在载荷图中,靠近的原始变量表示它们在典型变量方向上的权重相似,可能表示这些变量在描述数据中的某个特征时有较强的共性。
- 远离的变量:远离的原始变量表示它们在典型变量方向上的权重差异较大,可能表明它们在数据中捕捉的特征不同。
- 变量的贡献程度:
- 较长的箭头或较远的点表示该变量对典型变量的贡献较大。换句话说,这些变量在形成典型变量时起到了更重要的作用。
- 较短的箭头或较近的点表示该变量对典型变量的贡献较小。
- 变量的相关性:
- 在载荷图中,如果两个变量的箭头或点的方向非常相似,说明这两个变量在典型变量方向上的载荷具有高度相关性。
- 如果两个变量的箭头或点的方向接近于垂直,说明这两个变量在典型变量方向上的载荷无关,或者它们之间的相关性较低。
- 对比不同数据集的载荷图:
- 通过比较数据集 \mathbf{X} 和 \mathbf{Y} 的载荷图,可以理解这两个数据集在典型变量上的相似性和差异性。例如,某些原始变量在 \mathbf{X} 和 \mathbf{Y} 中的载荷方向可能一致,表示它们在这两个数据集之间的关系较强。
- 对于数据集 \mathbf{X} 和 \mathbf{Y} 的不同原始变量,它们的载荷图可能会显示出某种模式,揭示出哪些变量对两个数据集之间的关联性贡献较大。
载荷图是通过展示原始变量在典型变量方向上的载荷来帮助我们理解数据集间的相关性。它的X轴和Y轴坐标分别来自于载荷矩阵的前两列,表示原始变量在前两个典型变量上的贡献。
通过载荷图,我们可以看到原始变量在典型变量空间中的分布,从而判断它们对典型变量的贡献、它们之间的相关性,以及它们在数据集之间的关联性。
是的,第一载荷是指原始变量在第一个典型变量(canonical variable)方向上的贡献,通常通过载荷矩阵(loading matrix)来表示。载荷图则展示了原始变量在典型变量空间中的投影,可以理解为每个原始变量在典型变量方向上的加权坐标。
第一载荷的意义
-
第一载荷指的是原始变量在第一个典型变量( u1 或 v1 )方向上的权重。它表明原始变量对第一个典型变量的形成贡献大小,载荷值越大,表示该变量在典型变量方向上占有更重要的地位。
-
载荷矩阵的第一列通常对应第一个典型变量的载荷,表示每个原始变量在第一个典型变量方向上的权重。
载荷图展示了原始变量在典型变量空间中的位置和关系。你可以将载荷图理解为变量的加权坐标图,其中每个点或箭头代表一个原始变量。箭头的方向和长度表示该原始变量在典型变量空间中的贡献。
如何在载荷图中表示
载荷图中的箭头方向表示原始变量在典型变量方向上的相关性,箭头的长度则表示变量在该方向上的贡献大小。你提到的“20%的A,30%的C”实际上就是这两者之间的关系:
- 方向:箭头的方向表明了该变量在典型变量空间中的关系,类似于它在该方向上的负载。
- 长度:箭头的长度表示该原始变量对典型变量的贡献比例。箭头越长,意味着该变量对典型变量的贡献越大。
,
1. I型 Biplot (Type I Biplot)
I型 biplot 通常是通过**主成分分析(PCA)或典型相关分析(CCA)**中样本得分和变量载荷的投影来绘制的。它通常表现为原始变量在低维空间(通常是二维)中的载荷,以及样本的得分。
-
方向解释(I型 Biplot):
- 在I型 biplot中,箭头的方向表示原始变量在选定典型变量或主成分方向上的负载。即,箭头方向上原始变量的相关性与所选择的主成分或典型变量成正比。
- 样本和变量的方向:如果样本和变量的箭头指向相同的方向,说明样本和变量之间有较高的相关性。反之,若指向相反方向,则表示负相关。
- 变量间的相关性:变量的箭头越接近,表示这些变量在所选主成分(或典型变量)方向上的相关性越高;若箭头指向相反方向,则说明它们之间是负相关。
-
距离解释(I型 Biplot):
- 在I型 biplot中,样本之间的距离反映了样本在低维空间(典型变量或主成分空间)中的相似性。距离较近的样本表示它们在该空间中有相似的特征或行为模式。
- 样本与变量之间的距离:变量和样本的距离关系并不是简单的几何距离。在I型biplot中,变量的载荷方向有时不完全与样本的分布一致。即,变量的箭头方向并不总是直接与样本的聚集分布呈现显著的几何意义,尤其在有多个主成分时。
-
角度解释(I型 Biplot):
- 在I型 biplot中,变量的箭头之间的角度代表了变量之间的相关性。例如,两个变量的箭头成小角度(较接近),意味着这两个变量在低维空间中高度相关;若箭头之间的角度接近90°,则表示这两个变量在低维空间中是独立的;如果箭头几乎指向相反方向,则表示它们之间的相关性为负。
- II型 Biplot (Type II Biplot)
II型 biplot 与I型 biplot在设计和理解上有显著不同。II型 biplot的目的是更清晰地展示**样本**和**变量**之间的关系,尤其是在主成分分析或典型相关分析中。这种方法通过不同的投影方式(如通过缩放投影或基于协方差矩阵的投影)来调整变量载荷和样本得分之间的关系,使得它们能够在同一图中直观地比较。
方向解释(II型 Biplot):
- II型 biplot的箭头方向通常仍然表示变量在低维空间中的投影方向,但它更加缩放和标准化,从而使得每个变量的影响可以清晰地看到。这意味着箭头的方向依然反映变量对主成分或典型变量的影响
- 在II型 biplot中,样本和变量的投影是独立的,样本的分布不直接影响变量的投影,而变量的投影是基于它们对低维空间的贡献来确定的。II型 biplot通过这种方式来确保样本和变量在同一空间中都有合适的展示。
距离解释(II型 Biplot):
- 在II型 biplot中,样本与变量之间的距离是由样本和变量在低维空间中的投影的内积(或角度)决定的。这意味着,样本和变量之间的距离可以直接反映它们在数据中相互作用的强度,而不仅仅是几何距离。
- 样本与变量之间的距离:样本点与变量的箭头之间的距离(或内积)反映了样本和变量之间的相似性程度。距离较近的样本和变量说明这些样本在这个典型变量(或主成分)方向上有类似的表现。
角度解释(II型 Biplot):
- 变量之间的角度仍然表示它们之间的相关性,但II型 biplot中,角度的几何解释变得更加直接和明确。角度越小,表示变量越相关;角度越大,表示变量之间的关系越弱。
- II型 biplot的独特之处在于,样本和变量之间的角度有时可以用于直接反映它们的关系,因为它们是通过投影与内积计算的,而不是通过简单的几何投影。因此,样本和变量之间的角度可以更准确地反映数据中的协方差结构。
- 方向和距离(或角度)解释的不同
-
I型 biplot主要侧重于展示样本和变量之间的相关性,并通过主成分的投影或典型变量的投影来进行解释。方向和角度的解读侧重于样本和变量之间的几何关系,样本和变量越接近,相关性越强。
-
II型 biplot则更加注重样本和变量之间的内积关系,即通过投影和协方差结构来解释方向和距离。变量之间的角度和样本与变量的距离通常提供了更加量化的相关性度量,强调了数据中潜在的协方差和相似性结构。
-
I型 biplot通过简单的投影将样本和变量在低维空间中展示,方向和角度主要反映变量间的线性相关性,而距离主要反映样本间的相似性。
-
II型 biplot使用内积和协方差投影来定义样本和变量的关系,方向和角度的解释更多与变量和样本的投影关系相关,距离则反映了样本和变量之间的相似性。
在**典型相关分析(CCA, Canonical Correlation Analysis)**中,一个核心假设是:X组和Y组之间的相关性应该是最大的,即我们试图找到一种方式,使得X组和Y组中的线性组合(即典型变量)之间的相关性最大化。
-
假设的意义:
- 典型变量的最大相关性:在CCA中,我们试图找到一对典型变量(一个来自X组,一个来自Y组),使得这对典型变量之间的相关性最大。这些典型变量是X组和Y组变量的线性组合。最大化这些典型变量之间的相关性,能够揭示X组和Y组变量之间最重要的结构性关系。
- 数据降维:通过将多个原始变量转换为少数几个典型变量,CCA有助于降维。通过最大化X组和Y组之间的相关性,我们能够找到最能表达两组数据之间关联的低维表示。
- 解释性:最大化X和Y组之间的典型相关性,能够帮助我们理解不同变量集之间的关系。例如,X组可能代表的是“预测变量”,Y组是“响应变量”,通过最大化两者的相关性,可以帮助揭示哪些X组的变量在多大程度上影响了Y组的变量。
-
假设的合理性:
-
捕捉线性关系:最大化相关性假设基于一个前提:X组和Y组之间的关系是线性的。假设X组和Y组变量之间有较强的线性相关性,CCA的目的是通过寻找一对典型变量,尽可能捕捉到这种线性关系。因此,假设X组和Y组之间相关性最大化是合理的,尤其在变量之间确实存在线性关系时。
-
数据降维与可解释性:在多维数据中,变量的维度可能非常高,直接分析这些变量之间的关系会变得复杂。CCA通过减少维度并且寻找X和Y之间最强的线性关系,从而简化了数据结构并提高了解释性。这个假设有助于我们理解X和Y组之间的最主要的共性。
-
假设前提的有效性:如果X组和Y组之间存在非常强的线性关系,且两组变量之间存在明显的协同变化(即某些X组变量的变化与Y组变量的变化高度相关),最大化相关性假设是合适的。通过最大化相关性,我们能够更好地捕捉这种关系。
-
假设的潜在问题和局限性:
-
非线性关系的局限性:CCA假设X和Y组之间的关系是线性的,因此如果两组变量之间存在非线性关系,最大化相关性的假设可能不再合能会更加合适。
- 多重共线性问题:如果X组或Y组中的变量之间存在高度的多重共线性,那么这些变量可能会冗余,从而影响CCA结果的稳定性。在这种情况下,最大化相关性假设可能导致过度拟合或解释不清楚的结果。
- 噪音的影响:在实际数据中,噪音可能导致变量之间的相关性较弱,或者相关性不完全反映数据的真实关系。过度依赖“最大相关性”假设可能导致对噪音的过度拟合,而无法有效捕捉到有理。在这种情况下,CCA可能无法充分捕捉到X和Y之间的真正关系。对于非线性关系,其他方法(如非线性CCA、典型相关自编码器等)可意义的结构。
- 数据独立性假设:在CCA中,假设X组和Y组之间没有过多的直接关联性(例如,多重共线性),但在某些情况下,X和Y组可能有潜在的依赖关系,导致经典CCA模型可能无法准确建模。这时可能需要考虑其他方法来克服这种问题。
-
典型载荷如何反映X和Y的影响?
在CCA中,典型载荷反映了 X组(转录组)或Y组(代谢组)中的每个变量对对应典型变量(即主成分)的贡献程度。在解读时,我们通常关注 X组的典型载荷 和 Y组的典型载荷 之间的关系。通过这些载荷,我们可以理解以下几点:- 转录组(X)典型载荷:表示哪些基因在 X组典型变量(转录主成分)中占据重要地位。这些基因是转录组变化的主要贡献者。
- 代谢组(Y)典型载荷:表示哪些代谢物在 Y组典型变量(代谢主成分)中占据重要地位。代谢物则反映了代谢状态的变化。
-
如何通过典型载荷找出相互影响的变量:
- 相关性检视:如果某个基因在 X组典型变量 中具有较高的载荷,并且与某个代谢物在 Y组典型变量 中具有较高的交叉载荷,那么可以推测该基因可能在转录过程中调节了该代谢物的合成或代谢。这是 X组与Y组之间相互影响的体现
- 同向变化:如果某个基因的典型载荷和某个代谢物的典型载荷方向一致(例如,它们都在同一方向变化),这通常意味着这些变量可能是同一生物过程的一部分。反之,如果它们的变化方向相反,则可能表明一种抑制或竞争性调节关系。
- 共表达分析:如果多个基因和代谢物的典型载荷值都高,且它们之间具有强相关性,可能揭示出它们在某些代谢途径或生物学过程中共同发挥作用。例如,多个基因可能同时调节代谢物的合成通路,或者多个代谢物在同一代谢网络中相互调节。
-
变量A是否可以同时是典型载荷和交叉载荷?
- 作为典型载荷:如果变量A(例如,基因A)在 X组典型变量 中有较高的载荷值,那么说明 基因A 对 X组(转录组)的变化有较大的贡献,可能是该组的主要驱动因子。
- 作为交叉载荷:如果变量A(例如,基因A)在 Y组典型变量 中有较高的交叉载荷值,那么这说明 基因A 与 Y组(代谢组)之间也存在一定的相关性,可能影响了代谢物的浓度。
当变量A同时表现为 X组的典型载荷 和 Y组的交叉载荷 时,可以推测:
-
基因A对转录组的变化有重要影响,同时也与代谢物的变化存在较强的相关性。
-
这可能表明 基因A 不仅在转录水平调控基因表达,还通过某些途径影响了代谢物的合成或代谢过程。也就是说,基因A可能在 转录和代谢之间 充当了一个“桥梁”角色,参与了跨层次的生物学调控。
-
如何解读这些相互影响?
-
典型载荷高的基因与代谢物的关系:
如果基因A在 转录组的典型载荷 中表现突出,并且在代谢组的交叉载荷中也有显著的贡献,那么我们可以认为基因A不仅在转录层面发挥作用,还通过影响代谢物的浓度、代谢途径等与代谢组发生了联系。例如,基因A可能通过编码某种酶或转录因子,调控代谢物的合成或降解。 -
通过交叉载荷找代谢标志物:
在代谢组中,交叉载荷值较高的代谢物可能是与转录组中关键基因调控相关的代谢标志物。这意味着,如果某个代谢物与某个基因的交叉载荷高度相关,它可能是该基因作用的下游反应产物或被该基因调控的代谢物。
- 典型载荷如何反映X和Y的影响?
在CCA中,典型载荷反映了 X组(转录组)或Y组(代谢组)中的每个变量对对应典型变量(即主成分)的贡献程度。在解读时,我们通常关注 X组的典型载荷 和 Y组的典型载荷 之间的关系。通过这些载荷,我们可以理解以下几点:
-
转录组(X)典型载荷:表示哪些基因在 X组典型变量(转录主成分)中占据重要地位。这些基因是转录组变化的主要贡献者。
-
代谢组(Y)典型载荷:表示哪些代谢物在 Y组典型变量(代谢主成分)中占据重要地位。代谢物则反映了代谢状态的变化。
- 理解典型载荷图的构成
- 在典型相关分析中,X组(转录数据)和 Y组(代谢数据)的每个变量(如基因A和代谢物B)都会有一个 典型载荷,表示该变量对其对应的典型变量(即主成分)的贡献程度。
- 典型载荷图通常显示的是:
- X组(转录组) 中每个基因的典型载荷;
- Y组(代谢组) 中每个代谢物的典型载荷。
- 如何通过载荷图看出基因A和代谢物B的重要性
在载荷图中,基因A和代谢物B的 典型载荷 会通过箭头的 长度和方向 来表示:
- 箭头长度:表示该变量(基因A或代谢物B)对对应典型变量的贡献程度。箭头越长,表示该变量对该主成分的影响越大。
- 箭头方向:表示该变量与典型变量的相关性方向。如果两个箭头方向相似,表示它们之间有较强的正相关关系;如果箭头方向相反,表示负相关关系。
- 分析转录典型变量1和代谢典型变量1的关系
- 基因A对转录典型变量1的贡献
- 在载荷图中,观察基因A的箭头在 转录组典型载荷(X组)中的长度。若基因A的箭头较长,说明它对 转录典型变量1 的贡献较大。换句话说,基因A在解释转录组的变化中占有重要地位。
3) 转录典型变量1与代谢典型变量1的相关性
- 在CCA中,转录典型变量1和代谢典型变量1之间的相关性通常可以通过查看它们的相对位置来确定。如果它们的箭头方向接近,表明它们之间有较强的正相关性;如果方向相反,则表明负相关性。
- 假设转录典型变量1与代谢典型变量1之间有较高的相关性(即它们的箭头方向相似),那么你可以推测 基因A(转录典型载荷中贡献较大)和 代谢物B(代谢典型载荷中贡献较大)之间可能存在一定的关联。也就是说,基因A可能通过某些代谢通路或机制影响了代谢物B。
如何解读没有显著参与主成分的基因:
- 局部性作用:某些基因可能仅在特定的组织或细胞类型中有重要作用,而在整体转录和代谢变化的主成分中作用较小。例如,它们可能在 组织特异性 的代谢调节中发挥作用。
调控较为复杂:有些基因可能通过复杂的调控网络或间接方式影响代谢通路的功能。它们的作用可能不直接通过主成分体现出来,但它们依然在更为 复杂的生物学过程 中起着至关重要的作用。
- 生物学上如何理解高贡献与低贡献
清晰
https://mp.weixin.qq.com/s/nFkVTzVWRtZoWp1KUn9uuQ
Visualising associations between paired ‘omics’ data sets | BioData Mining | Full Text
相关性原图的解释: 告诉了如何将两组变量投影到一个向量中的方法
- 可以反应相关的变量
- 关注接近1的 忽略小于0.5的,
看图
观察:
- 样本在解释变量的投影长度
- 变量之间的夹角。
- 对于I型标尺,仅可据此观测解释变量与响应变量间的相关性;
- 对于II型标尺,既可以据此观测解释变量与响应变量间的相关性,也可以观测解释变量之间、或响应变量之间的相关性
I 与II 型共同点:
- 样本在解释变量的投影有意义,投影越长,说明解释变量含量越高正方向或者越低负方向。
不同点:
-
物种(响应变量)箭头:物种或其他响应变量的箭头表示在 RDA 空间中这些变量的方向和大小。箭头的长度代表该物种在这个轴上的方差贡献度。箭头方向靠近的样方表明该样方在这些物种上具有较高的值。
-
环境(解释变量)箭头:解释变量(环境因子)的箭头表示它们在 RDA 空间中对响应变量的影响。箭头的方向和长度表明这些变量的影响方向和强度。
(1) 贡献度
RDA1 和 RDA2 各自解释了 YYY 矩阵中多少方差能够通过 XXX 矩阵解释。一般来说,RDA1 的解释度是最大的,它解释了大部分由解释变量 XXX 对响应变量 YYY 的线性影响。而 RDA2 解释了剩余的次要影响。
举个例子:
- 如果 RDA1 解释了 60% 的方差,RDA2 解释了 20% 的方差,那么这两条轴一共解释了 80% 的响应变量方差。
- RDA1 可能反映出主环境因子的影响方向(如温度的影响),而 RDA2 可能反映出次要环境因子的影响(如湿度的影响)。
(2) 样方与物种的关系
在 RDA 图中,如果样方点(代表样本)与物种箭头或环境变量箭头的方向相近,则表明该样方受到这些物种或环境因子的显著影响。例如:
- 如果某个样方点位于 RDA1 的正方向,而物种 A 的箭头也指向 RDA1 的正方向,那么该样方的物种 A 的丰度可能较高。
- 如果某个样方点与解释变量箭头方向一致,则说明该样方受该环境因子的影响较大。
4. RDA 图的例子
假设我们有一个 RDA 图,横轴是 RDA1,纵轴是 RDA2:
-
RDA1:横轴解释了 50% 的方差,反映了环境因子“温度”的主要影响。样方 A、B、C 在 RDA1 轴的正方向上,物种 1 的箭头也指向 RDA1 的正方向。这说明物种 1 在温度较高的样本中丰度较高,样方 A、B、C 可能位于高温区域。
-
RDA2:纵轴解释了 30% 的方差,反映了环境因子“湿度”的影响。样方 D 和 E 在 RDA2 轴的正方向上,物种 2 的箭头指向 RDA2 的正方向。这说明物种 2 在湿度较高的样本中丰度较高,样方 D 和 E 可能位于湿度较高的区域。