线性回归检验的由来
- 如果没对照组,无法保证处理条件,其他因素不会对结果产生影响
- 单侧检验: 在某个方向上是否更极端,双尾 两个方向上都更极端,
自由度
-
方差分析中的置换检验
library(lmPerm) set.seed(1234) fit <- aovp(weight~height, data=women) summary(fit) -
卡方统计量:皮尔逊残差R=(实际-预期)/预期
-
均方根 对数值平方后 求均值然后开方
2. RMSE (Root Mean Squared Error, 均方根误差)
RMSE 是衡量预测值与真实值之间差异的常用指标,
3. RSE (Residual Standard Error, 残差标准差)
RSE 是回归模型中残差的标准差,衡量模型预测的误差大小,其 LaTeX 公式如下:
- :回归模型中自变量的个数(不包括截距项)
- RSE 越小,说明模型拟合越好。
| 指标 | 公式 | 分母 | 适用场景 |
|---|---|---|---|
| RMSE | 通用预测误差评估 | ||
| RSE | 回归模型的误差估计 |
- RMSE 适用于任何预测任务(如机器学习、时间序列预测)。
- RSE 主要用于回归分析(如线性回归),考虑了模型复杂度(变量数 ),避免低估误差。
(决定系数,Coefficient of Determination)**
衡量回归模型对因变量变异的解释比例,其 LaTeX 公式为:
2. (调整决定系数,Adjusted R-squared)
在 基础上引入惩罚项,防止因变量过多而虚假提高解释力,
解释:
- :样本量
- :自变量个数(不包括截距项)
- 当 增加时, 可能下降,避免过拟合。
回归中的检验由来
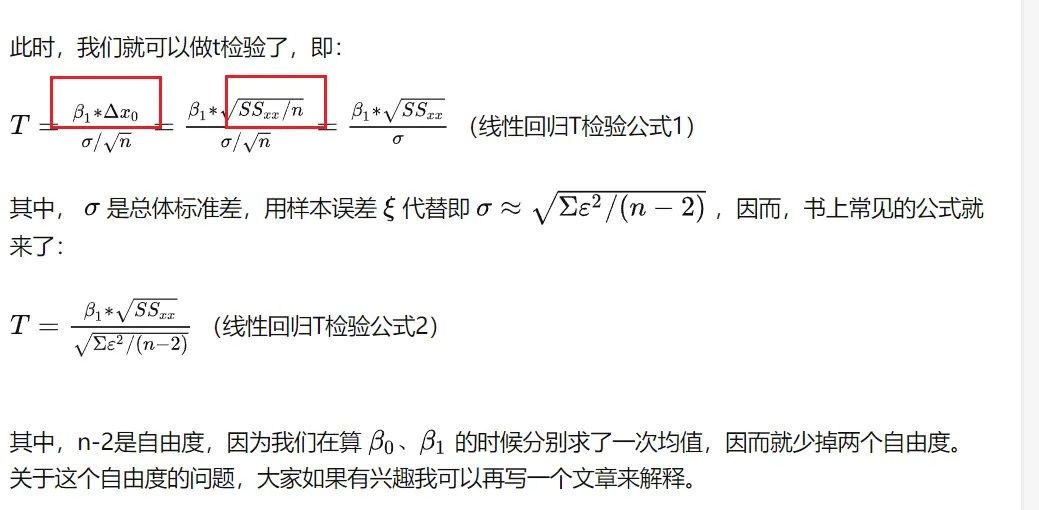
线性拟合中的t检验: t检验检测两总体均值。
在线性回归中,检测单个变量对因变量的影响。检测预测变量和拟合值标准差的大小
模型性能评价
- F检验看变量总体是否显著
- 拟合度R2看Y的变化有多少能被X解释
- 共线性分析:VIF
模型假设检验
Q1 为什么要调整随着参数的增加 R2有偏差
整理F检验显著但t检验均不显著
TYPE=“response” 对于预测变量输出原来尺度的概率 而不是预测尺度的概率
当每个自变量的t检验都不显著但是整体F检验显著时,首先应该排除多重共线性的影响。如果模型不存在多重共线性问题,可以检查是否存在较为明显的异常值等;又或者可以考虑剔除那些次要的、可有可无的变量,重新建立更为简单的回归方程
不同分布如何通过似然函数影响参数估计
在广义线性模型(GLM)中,分布的选择直接决定了似然函数的形式,进而通过极大似然估计(MLE)影响参数估计的结果。不同分布对参数估计的影响主要体现在以下几个方面:
1. 不同分布的似然函数形式
(1) 正态分布(线性回归)
- 似然函数:
假设误差项 ,则响应变量 ,其对数似然函数为:
- 影响:
- 最小二乘法(OLS)等价于极大似然估计(MLE)。
- 参数估计对异常值敏感(因平方损失放大极端值)。
(2) 泊松分布(计数数据)
- 似然函数:
,对数似然为:
- 影响:
- 参数估计通过 进行,确保 。
- 若数据存在过离散(方差 > 均值),MLE 会低估标准误。
(3) 二项分布(逻辑回归)
- 似然函数:
,对数似然为:
- 影响:
- 使用 Logit 连接函数 ,确保 。
- 参数估计对类别不平衡敏感(如罕见事件)。
2. 分布如何影响参数估计?
(1) 均值-方差关系
- 正态分布:方差 恒定(与均值无关)。
- 泊松分布:方差 = 均值()。
- 二项分布:方差 = 。
影响:
- 若错误假设分布(如用正态拟合计数数据),方差估计错误 → 标准误和置信区间不准确。
(2) 连接函数的选择
- 分布决定合适的连接函数:
- 正态分布 → 恒等连接()。
- 泊松分布 → 对数连接()。
- 二项分布 → Logit 连接()。
影响:
- 错误的连接函数会导致模型无法正确映射线性预测器到响应变量(如预测概率超出 [0,1])。
(3) 参数估计的鲁棒性
- 厚尾分布(如 t 分布):对异常值更稳健。
- 泊松分布:对过离散(方差 > 均值)敏感,需改用负二项分布。
例子:
- 若真实数据存在大量零计数(零膨胀),泊松回归会低估概率,需用零膨胀泊松模型(ZIP)。
3. 实际例子对比
案例1:泊松 vs. 正态回归
- 数据:医院每日急诊人数(计数数据)。
- 泊松回归:
- 正确假设 。
- 系数解释为“事件发生率比”(IRR)。
- 正态回归:
- 可能预测负值(无意义)。
- 低估极端事件概率(因正态分布尾部较薄)。
案例2:逻辑回归 vs. 线性概率模型
- 数据:用户是否购买(0/1)。
- 逻辑回归:
- 保证预测概率 。
- 系数解释为对数几率比(OR)。
- 线性回归(LPM):
- 可能预测 或 。
- 异方差问题(方差随 变化)。
4. 如何选择合适的分布?
- 观察响应变量类型:
- 连续值 → 正态/伽马分布。
- 计数 → 泊松/负二项分布。
- 二分类 → 二项分布。
- 检查均值-方差关系:
- 若 ,考虑负二项或准泊松。
- 模型诊断:
- 残差分析(如QQ图、Deviance残差)。
- 比较AIC/BIC(选择拟合优度更高的分布)。
总结
- 分布决定了似然函数的形式,进而影响参数估计的准确性和解释。
- 错误选择分布会导致:
- 偏差的参数估计。
- 不准确的置信区间/p值。
- 预测结果不合理(如负计数、概率超出边界)。
- 关键步骤:
- 根据数据类型选择分布。
- 验证均值-方差假设。
- 使用模型诊断工具调整分布(如处理过离散)。
通过正确选择分布,GLM 可以灵活适应多种数据类型,并给出可靠的统计推断。