卡方分布由来
卡方检验是属于非参数检验,主要是比较两个及两个以上样本率( 构成比)以及两个分类变量的关联性分析。其根本思想就是在于比较理论频数和实际频数的吻合程度或拟合优度问题。
卡方分布
卡方分布的随机变量从标准正态分布中抽样而来,们从这个标准正态分布中随机抽取一个样本Z,然后对这个样本进行平方,得到Z2。我们进行许多次这样的抽样,得到许多的Z2,这些Z2就会形成一个如下的右偏分布。由于我们每次只抽取了一个样本,所以称这个分布为自由度=1的卡方分布。
为什么是右偏的?
-
平方的影响:当我们对Z取平方时,负值会变成正值。这意味着所有负的Z值在平方后都会变为正的Z2值。由于负数和正数在平方后都变为正数,这导致Z2的分布向右侧(即正值方向)偏移。
-
小负值与大正值:虽然小的负Z值在平方后会变成小的正Z2值,但大的正Z值在平方后会变成更大的正Z2值。因此,Z2的分布中,大的正值比小的正值更常见,这进一步加剧了分布的右偏性。
关于卡方分布我们有如下定义:
n个相互独立的标准正态分布的随机变量的平方和,服从自由度为n的卡方分布。
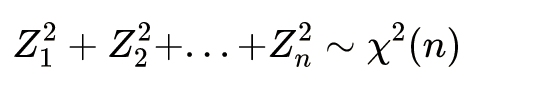
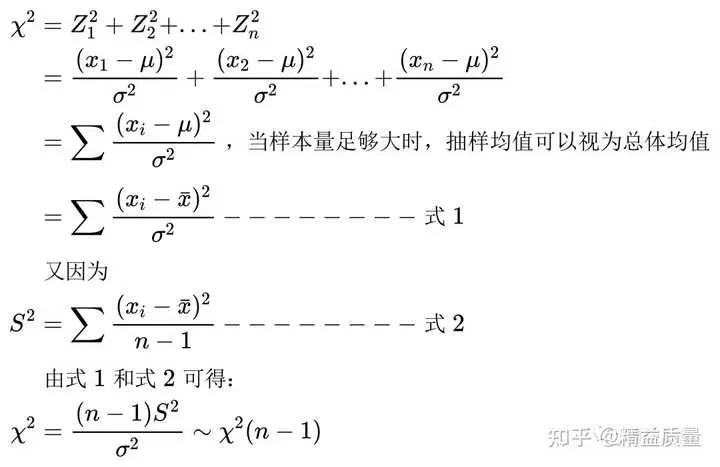
卡方分布独立性检验:喝牛奶和感冒真的是独立无关的,那么四格表里的理论值和实际值差别应该会很小
我们想知道喝牛奶对感冒发病率有没有影响,以下为数据统计的四格表:
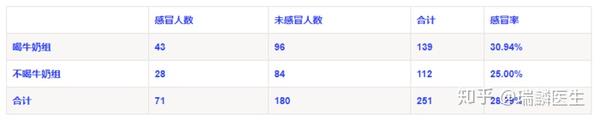
为了确定真实原因,我们先假设喝牛奶对感冒发病率是没有影响的,即喝牛奶喝感冒时独立无关的,所以我们可以得出感冒的发病率实际是(43+28)/(43+28+96+84)= 28.29%
所以,理论的四格表应该如下表所示:
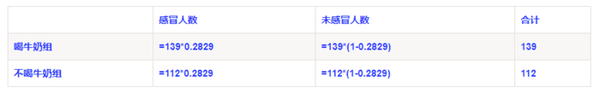
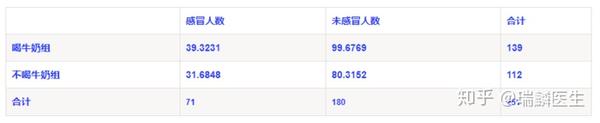
如果喝牛奶和感冒真的是独立无关的,那么四格表里的理论值和实际值差别应该会很小。
那如何来描述这种差别呢,我们定义卡方值为
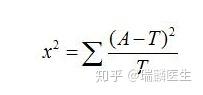
图1 卡方值计算公式
其中,A为实际值,T为理论值。
x2用于衡量实际值与理论值的差异程度(也就是卡方检验的核心思想),包含了以下两个信息:
- 实际值与理论值偏差的绝对大小(由于平方的存在,差异是被放大的)
- 差异程度与理论值的相对大小
1.n大于等于40.所有理论频数大于等于5---用卡方检验
2.n大于等于40,所有理论频数大于1,小于5----用校正的卡方
3.n小于40,理论频数小于1-----用fish精确概率法
卡方分布拟合度
计算是否服从某个分布
- 关键点还是比较差异 f0实际频数,fe理论频数,fe是通过均匀分布 泊孙分布 计算的
列联表统计
ftable()
xtab()
回归中的卡方
在比较嵌套回归模型时,使用的统计量通常是嵌套模型之间的差异,而卡方分布是用来评估这种差异是否显著的一种工具。这个过程通常使用的是假设检验,其中卡方统计量用于检验两个模型的拟合优度是否有显著差异。
假设我们有两个嵌套的模型,比如模型 A 和模型 B。模型 B 是模型 A 的特例,即模型 B 包含了模型 A 并额外拥有一些参数。
卡方统计量的计算涉及两个模型的残差平方和之差与自由度之差的比较。它的计算公式如下:
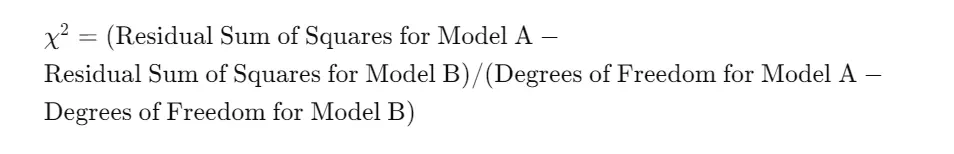
- Residual Sum of Squares(残差平方和)是模型拟合后残差(观测值与拟合值之差)的平方和。
- Degrees of Freedom(自由度)表示模型中可以自由变动的参数数量。对于线性回归模型,自由度通常是样本量减去参数个数减一(因为有一个截距项)。
计算得到的卡方统计量会接近一个卡方分布
统计基础 fisher.test在总体背景的发生的个数中,某一特定事件发生的次数,如果发生的次数
分母帮助我们理解这个特定组合的罕见程度:如果在所有可能的组合中,这个特定组合的概率非常低,那么它更有可能是显著的,意味着它并非偶然发生的。
检验的逻辑:衡量极端性
费舍尔精确检验的逻辑是基于检验极端性的思路。假设基因的上调与通路没有关联,那么每个基因进入上调基因集合或未上调基因集合的概率是均等的。因此,所有的列联表排列都有一定的随机概率。我们通过计算观察到的列联表出现的特定概率,并将其与所有可能的列联表相比,来判断该特定组合是否极端:
- 如果观察到的列联表的概率很小,即它在所有可能组合中显得极为罕见,这意味着这种情况不太可能随机发生。
- 如果概率较大,则说明观察到的列联表可能是随机出现的,不具有显著性。
特定组合的可能性(分子)除以所有可能组合的总数(分母),本质上是在生成一个检验统计量,用于衡量观测到的数据是否极端。检验的结果(即p值)反映了在原假设为真时,观察到相同或更极端结果的概率。这是我们判断是否拒绝原假设的重要依据。
在费舍尔精确检验的公式里:
- 分子是计算你抓到特定组合(比如“7红3绿”)的概率。
- 分母是所有可能抓到的结果(所有“红绿”组合)的总数。
通过把特定组合的可能性除以所有可能组合的总数,公式告诉我们这个组合在所有结果中的相对位置。如果这个结果非常少见,那它就是一个极端的结果。
费舍尔精确检验通过计算你的抓糖果结果在所有可能组合中的“罕见程度”,来告诉你这个结果是不是极端。如果结果很极端,就可能意味着有其他因素在影响,比如糖果的分布不均匀等。
这个比喻帮助小学生理解:
- 特定组合是我们观察到的抓到的糖果分布。
- 所有可能组合是所有你可能抓到的糖果分布。
- 通过比较我们观察到的组合和所有组合,判断它是否极端。
通俗理解:想象有一袋100颗糖果,你抓10颗,分母就表示袋子里所有你可能抓出的不同组合。如果分子表示的是你抓到的具体结果(“7红3绿”),那么通过把分子除以分母,你就知道这个特定结果在所有可能结果中占多少比例。比例越小,说明这个结果越极端。
key在于更极端的列联表往往代表的是比你观察到的结果更偏离无关联假设(或者说更极端的差异)。如果这些极端结果的概率也很小,并且加在一起让总概率(p值)变得很低,那么我们就认为整体结果是极端的,不太可能是随机的。
- 只计算疾病组的组合数: 如果仅计算 ,你就忽略了健康组的分布情况。虽然你可以知道疾病组中有多少样本是基因变异,但这并不能完整反映疾病组和健康组之间的差异。健康组的分布也会影响富集分析的结果。
- 为了计算观察到的列联表的概率(即分子),我们必须同时考虑疾病组和健康组的样本分布。因为富集分析的核心是比较疾病组和健康组的基因变异分布,所以两个组合数必须一起计算。
最终的分子是:
这代表了在无富集假设下,观察到的列联表(即疾病组有 c 个样本有基因变异,健康组有 a 个样本有基因变异)的所有可能组合数的乘积。
单尾
输入顺序的不同,对于单尾会影响结果,
为什么需要单尾检验?
greater选项表示你假设在疾病组中某个特征(如基因变异)的出现频率要显著更高,这就是检验“富集”的核心。- 该检验仅考虑一个方向的极端性,即基因是否在疾病组中显著富集,而不考虑贫化的情况(即基因在健康组中的出现频率是否更多)。
为什么 H₁ 不是“健康组中基因的出现频率显著高于疾病组”?
-
greater选项聚焦于疾病组是否富集:
在alternative = "greater"检验中,我们的核心问题是检验 疾病组是否显著富集该基因,即我们关心的是 疾病组中的基因频率是否显著更高,而不是健康组的基因频率。因此,我们的备择假设 H₁ 是:疾病组中基因的出现频率显著高于健康组。 -
greater只考虑疾病组的富集:
greater选项的检验仅会考虑疾病组是否显著富集该基因,因此它假设疾病组中的基因频率应该 更高,而不是健康组。因此,健康组中基因出现频率显著更高的情况无法通过greater检验进行验证。如果你有兴趣检查健康组是否富集基因,你需要使用alternative = "less",即进行 左尾检验。 -
如果要检验健康组的富集:
如果你关心的是 健康组是否显著富集该基因,可以使用alternative = "less"选项,在这种情况下,你的备择假设 H₁ 就是 健康组的基因频率显著高于疾病组。但在使用greater时,所有的假设方向都指向疾病组,检验的核心是疾病组的富集。
为什么选择 greater?
使用 greater 选项表示我们关心的方向是:抽烟组是否显著比不抽烟组有更多的肺癌病例。这个方向的选择基于我们假设,抽烟可能增加得肺癌的风险(因果关系方向)。
给出的 phyper 表达式
超几何分布
`phyper(q=131, m=268, n=7662-268, k=1781, lower.tail = F)`

对应的超几何参数:

- q = 131:观察到的成功事件数。
- m = 268:总体中成功事件的总数(基因集的总数)。
- n = 7662 - 268:总体中失败事件的总数(非基因集的总数)。
- k = 1781 :抽取的样本数(差异表达基因的总数)。
-  lower.tail = F算 **右尾概率**,即 `P(X > 131)`


yy[1:4,1:6]
xx<-data.frame(a=str_split(yy$GeneRatio,"\\/",simplify = T)[,1],
               b=str_split(yy$GeneRatio,"\\/",simplify = T)[,2],
               c=str_split(yy$BgRatio,"\\/",simplify = T)[,1],
               d=str_split(yy$BgRatio,"\\/",simplify = T)[,2],
               p=yy$pvalue,
               p.adj=yy$p.adjust)

xx<-apply(xx,2,as.numeric)
xx<-as.data.frame(xx)
#注意!!!我这里使用的是q-1 ,同时设置了lower.tail=F
xx$p.diy<-apply(xx,1,function(a){phyper(a[1]-1,a[3],a[4]-a[3],a[2],lower.tail = F)})
Ref 基因富集分析
为什么第一个参数需要减1?
假设我们有以下参数:

m = 50 表示成功事件的总数(如某个基因集中的基因数量)。
n = 200 表示失败事件的总数(如不属于该基因集的基因数量)。
k = 30 表示抽取的样本数(差异表达基因数)。
q = 10 表示我们观察到的成功事件的数量(属于基因集的基因数量)。
(1) 计算小于或等于 10 个成功事件的概率:
r
复制代码
phyper(10, 50, 200, 30, lower.tail = TRUE)
这里我们计算的是:成功事件数量 ≤ 10 的概率。

(2) 计算大于 10 个成功事件的概率:
r
复制代码
phyper(10, 50, 200, 30, lower.tail = FALSE)
这会返回成功事件数量 > 10 的概率。

(3) 计算大于等于 10 个成功事件的概率:
要计算成功事件数量大于或等于 10 的概率,我们可以将 q 减 1 并取 小于等于 q-1 的概率的反函数:


1 - phyper(9, 50, 200, 30, lower.tail = TRUE)
这也就是为什么有时候在 phyper() 中需要对第一个参数 q 减 1。通过减 1,我们可以控制是计算严格大于 q 的概率,还是大于等于 q 的概率。

总结
phyper() 计算的是累积分布函数(CDF),即小于或等于 q 的成功事件的概率。
当需要计算 成功事件大于等于 q 的概率时,通常需要减 1。
在右尾概率计算(lower.tail = FALSE)时,如果你想计算大于等于某个值的概率,通常要将 q 减 1,然后求补的概率。
4. 处理小样本问题
- 卡方检验:在小样本情况下,期望频数过低会影响卡方检验的准确性,可能导致 Type I 错误率增加。在这种情况下,一般推荐改用 Fisher 精确检验。
- Fisher 精确检验:专为小样本设计,能够精确计算列联表的概率分布,因此在处理小样本时更加稳健,适用于 2x2 以及较小的 r x c 表格。