平均数, 标准差为 的正态总体,抽样样本平服从均数,标准差为 \sigma_\bar{X}=\frac{\sigma} {\sqrt{n}} \sigma_\bar{X}:标准误,衡量样本均值围绕总体均数的离散程度,衡量抽样误差
方差分析 检验各组之间的均值是否一致,方差分析比较的是平均数,比较1个或者多个因素影响下,总体的平均数是否有影响
单因素方差分析和lm的关系
对于回归的0模型 将截距考虑为预测变量
| 标准误 | 标准差 |
|---|---|
| 均值是否能够代表样本 | 样本能否很好代表总体 |
| 描述个体变异程度 | 描述均数的抽样误差大小 |
| S_\bar{X}=\frac{S} {\sqrt{n}} | |
t分布
t分布:是从Z变换而来,因为抽样原因导致,标准误有变异,前提假设是t分布
t=\frac{\bar{X}-\mu} {S_\bar{X}}=\frac{\bar{X}-u} {{S}/{\sqrt{n}}}
t分布的由来:由于样本的标准差具有变异性,不再服从Z分布
经过标准正态变换,Z变换,Z=\frac{\bar{X}-\mu} {\sigma_\bar{X}} ,此刻样本的标准误是常量,由于实际中\sigma_\bar{X}未知,因此用S_\bar{X}代替\sigma_\bar{X},后者的理论标准误是常量 \sigma_\bar{X}=\frac{\sigma} {\sqrt{n}},但是 S_\bar{X}=\frac{S} {\sqrt{n}} 不是,具有变异,因此不在不从标准正态分布,而服从t分布
点估计和区间估计
点估计就是用一个数去估计参数,eg用样本的平均值去估计
区间估计:估计参数所在的范围
\bar{X}-t_{\alpha/2}S_\bar{X}<\mu<\bar{X}+t_{\alpha/2}S_\bar{X}
已知样本的标准差和平均值从上面的公式可以求出平均数的置信区间
用法
-
单样本均值检验, 检验 总体方差未知、正态数据 单样本的均值 是否与 已知的总体均值相等
2. 要求:
1. 总体方差未知,否则就可以利用Z检验(也叫U检验,就是正态检验)
2. 正态数据或近似正态应用
3. 场景举例:1. 从某厂生产的零件中随机抽取若干件,检验其某种规格的均值是否与要求的规格相等(双侧检验) 2. 在某偏远地区随机抽取若干健康男子,检验其脉搏均数是否高于全体健康男子平均水平(单侧检验) 3. 检验某一线城市全体高三学生视力水平是否比全国全体高三学生视力水平低(单侧检验) -
两独立样本均值检验 检验 两对独立的 正态数据或近似正态的 样本的均值 是否相等,这里可根据总体方差是否相等分类讨论
目的:检验两独立样本的均值是否相等。
要求:两样本独立,服从正态分布或近似正态。
1. 解释两样本独立 :两个样本有自己单独的分布,不相互影响
应用场景举例
1. 检验两工厂生产同种零件的规格是否相等(双侧检验)
2. 为研究某种治疗儿童贫血新药的疗效,以常规药作为对照,治疗一段时间后,检验施以新药的儿童血红的增加量是否比常规药的大(单侧检验)
3. 检验两种药物对治疗高血压的效果,检验两组药物的降压水平是否相等(双侧检验)
分为两种
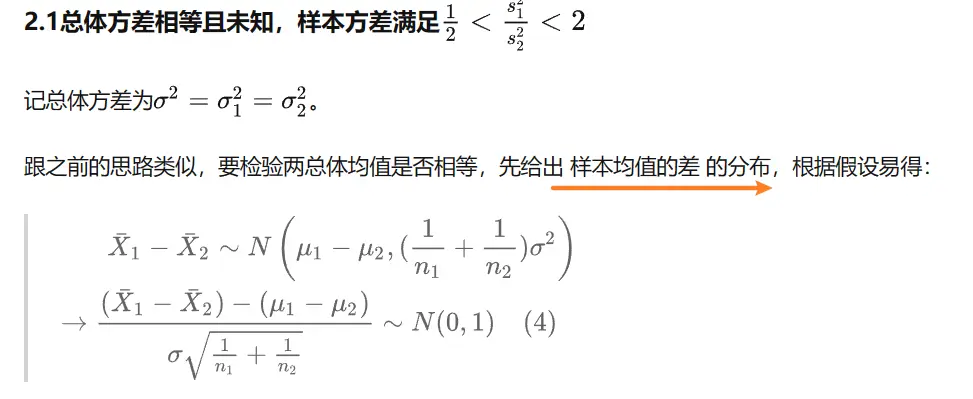
1.总体方差相等,但是未知,样本方差
-
总体方差不等,但是未知,样本方差,近似法 n1 n2>5,近似效果比较好
泊松分布
描述单位时间 或者单位面积内发生若干次数的概率分布,是离散分布。 例子:三代pacio 的测序就是泊松分布
观察是否在对角线上 PQ累积数据 和累积概率 QQ实际样本 和理论分位数
P-P图和Q-Q图,都是通过散点与正态分布的预测直线法重合程度以说明数据是否服从正态分布。
P-P图是将实际数据累积比例作为X轴,将对应正态分布累积比例作为Y轴,作散点图,反映实际累积概率与理论累积概率的符合程度。
Q-Q图将实际数据作为X轴,将对应正态分布分位数作为Y轴,作散点图,反映变量的实际分布与理论分布的符合程度。
正态检验
,样本量较大时,任意分布的随机样本均数比较,可以使用T检验,但足够大的样本量是关键条件。那么多大的样本量才算是足够大呢?实际上并没有唯一答案,这取决于原始分布本身偏离正态分布的程度,以及我们对近似性标准要求到底有多高。
经验来看,若只是稍稍偏离正态分布,可能大于30的样本量就够了(相信大家对这个说法有所耳闻),但若偏离比较大,则会需要更多,比如50以上,甚至100以上。这种近似是可以接受的,因为即便是我们通过正态性检验发现不拒绝正态性假设时才进行T检验,也无法保证原始数据一定就是完美的正态分布,正态性检验本身也是个近似
答案是,若原始数据比较符合正态分布,推荐用T检验,若偏离较大,建议用非参数检验。若样本量非常大,那么这两种检验都是可以的。
这是因为两种检验方法在不同条件下的power不同。当数据近似符合正态分布时,T检验几乎利用了所有的数据信息,因此最有能力发现差异,非参数检验利用的是数据间的次序关系,本身造成了一定的信息损失。
但是当数据明显偏离正态分布时,由于T检验依赖于较大的样本量才可以获得较好的近似,其power可能下降明显,不如非参数检验power高。
标准差的定义和初中不一样,除以标准差,衡量了数据之间相对的波动
如果数据不是正态分布的,建议使用非参数**配对样本Wilcoxon检验**。
3.5 计算配对样本t检验
配对t检验检查的是一组个体前后的差值 因此不需要方差检验
# 配对样本t检验
res <- t.test(after,before, paired = TRUE)
# 显示结果
res
	data:  after and before
t = 2.7111, df = 9, p-value = 0.02395
alternative hypothesis: true difference in means is not equal to 0
95 percent confidence interval:
  0.9388936 10.4011064
sample estimates:
mean of the differences
                   5.67
秩和检验
. 检验是否具有正态性 用于不满足正态分布的小样本,一般用Wilcoxon秩和检验,又称Mann-Whitney 检验
适用条件:
- 不依赖分布
- 两独立样本检验
秩和检验
- 先编秩 再求和
- 数秩和检验的思路其实没有变化,只是t检验针对的是原始数据,而秩和检验针对的是“秩”!
第四步:求秩和。秩编好了,正负号也添加完成,所以剩下的工作就只有求和。注意,此处有两种求和方式:
第一种直接将正秩和(一般用“R+”表示)与负秩和(对应为“R-”)相加,算出总的秩和,用R表示,将R进行变换,其实就是z变换,根据z值判断P值是否小于相应的检验水准。
这里的思想实际上是:如果两种方法耗时没有差异,那么这里的差值应该在0附近,而其对应的正秩和负秩大小应该差不多,所以总秩和加起来会相互抵消,因此总和与0差不多。
第二种是单独求和,即不把正秩和与负秩和相加,取二者中绝对值较小者,称作“W”,用数学的语言就是:W=min (R+, R-)。然后对W进行适当的变换(仍是z变换),根据z值判断P值是否小于相应的检验水准。