# 使用airquality数据集示例
library(mice)
data <- airquality
md.pattern(data)  # 查看缺失模式

imp <- mice(data, m = 5, maxit = 10, method = "pmm", seed = 123) #使用5个数据集
summary(imp)  # 查看插补摘要
complete(imp) %>% head()  # 查看完整数据集(默认返回第一个)
complete(imp, "long") %>% head() # 查看所有插补数据集
plot(imp)

# 检查变量间关系是否保持
stripplot(imp, pch = 20, cex = 1.2)
# 为不同变量指定不同插补方法
meth <- c("pmm", "pmm", "", "", "", "")  # 只为Ozone和Solar.R指定pmm方法
imp_custom <- mice(data, method = meth)
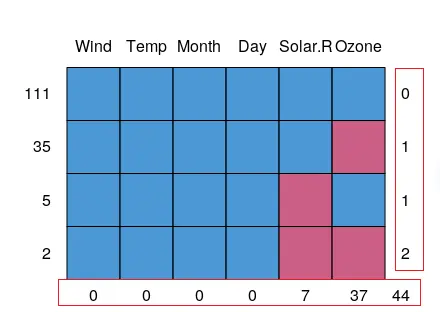 缺失值模式查看
- 一共111个行无缺失值,35个行有1个缺失值, 太阳列有7个缺失值,一共44个缺失值
填充后的,注意无明显的偏离比较好
-
随机缺失(MAR)
- 需要确保填充模型中包含所有能解释缺失机制的变量
- 建议进行变量重要性分析,确保关键预测变量被包含
-
非随机缺失(MNAR)
- 最具挑战性的情况
- 随机森林可能无法完全校正系统性偏差
- 建议考虑专门的MNAR处理方法或进行敏感性分析
样本量对填充效果的影响
小样本情况(n < 100)
- 挑战:
- 随机森林容易过拟合
- 填充结果可能不稳定
- 建议:
- 减少树的数量(ntree=50-100)
- 使用较简单的插补方法(如KNN)作为替代
- 考虑多重插补(mice)来评估不确定性
中等样本量(100 ≤ n ≤ 1000)
- 随机森林表现最佳的范围
- 可以:
- 使用默认参数(ntree=100-500)
- 进行更精细的调参
- 考虑变量重要性来优化填充模型
-
数据准备:
# 检查缺失模式 mice::md.pattern(your_data) -
参数设置:
# 推荐参数设置 missForest::missForest( your_data, ntree = ifelse(nrow(your_data)<100, 50, 500), # 根据样本量调整 maxiter = 10, variablewise = TRUE # 对每个变量单独评估 ) -
验证方法:
- 对完整数据部分进行人工缺失测试
- 比较不同方法的填充结果
- 对于关键变量,考虑多重插补评估不确定性
-
替代方案考虑:
- 小样本:pmm(预测均值匹配
- 高维数据:带有正则化的回归方法
- 分类变量:多重logistic回归
对,标准 KNN 填补的逻辑是:
         S1   S2   S3   S4   S5   S6
蛋白A    10   NA   12   11   NA   13
         ↑
         要填这个缺失值

Step1: 找和 S2 最相似的其他样本(比如 S4、S6)
Step2: 用 S4、S6 在蛋白A上的值(11、13)取均值 → 填 12
ImpSeq 的转置思路解决了这个问题:
         S1   S2   S3   S4   S5   S6
蛋白A    10   NA   12   11   NA   13  ← 要填
蛋白B    10   9    12   11   10   13  ← 邻居
蛋白C    11   10   11   10   9    12  ← 邻居

Step1: 找和蛋白A最相似的其他蛋白质行(从40000行里找)
Step2: 用邻居蛋白在 S2 位置的值来填补蛋白A的 S2
邻居池是 40000 行,完全够用,这就是 ImpSeq 适合你数据的原因。
ImpSeq 的不足:
1. 假设蛋白质表达模式相似
ImpSeq 的前提是”相似蛋白质在所有样本中变化趋势一致”,但现实中:
但如果蛋白A的缺失不是随机的(MNAR):
蛋白A在S2缺失 → 恰恰是因为浓度太低检测不到
填补值却用邻居的正常值 → 严重高估
**这是最大的缺陷**:ImpSeq 假设缺失是随机的(MAR),但蛋白质组学的缺失大多是**非随机的(MNAR)**——低丰度蛋白更容易缺失。
| 问题 | 严重程度 |
|---|---|
| MNAR 缺失(低丰度检测限) | ⚠️ 高,蛋白组学通用问题 |
| K 值选择 | ⚠️ 中,建议测试 K=5/10/15 |
| 全局结构缺失 | 低,6样本全局结构本来就简单 |
实际建议:先检查缺失模式——如果缺失值在低强度蛋白中集中出现,说明是 MNAR,这时候 MinDet 或 MinProb 反而比 ImpSeq 更合适,因为它们专门针对 MNAR 设计(用检测下限附近的小值填充)。
你的数据缺失主要集中在低丰度蛋白还是随机分布?