SAM 算法
SAM(Significance analysis of microarrays)算法用于微阵列基因表达谱数据识别DE基因 。SAM算法与t检验相似,但为了使具有较小标准误的基因不会被误判为DE基因,SAM在t统计量的分母中增加了校正值,提高了t检验的稳定性。计算公式如下,其中S0 为样本残差标准误的校正值:
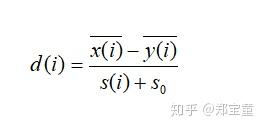
SAM算法是以t检验为基础,但它依旧存在与t检验相似的问题:偏向于识别在两类样本中表达水平低但倍数变化大的基因为DE基因
非参数方法鉴定差异表达基因的R包,samr。该包具有重采样功能以解决不同的测序深度,并可以稳健地应用于具有定量、生存、二分类或多分类结果的数据。非参数的方法普遍保守,您会发现它比其它R包鉴定的差异基因少得多
缺点:
SAM的理论很不错,但可能需要较大的样本量。如果只有2/3 replicates的实验,用SAM,实则大材小用,也得不到有意义的结果。因为FDR根本计算不准。
Significance Analysis of Microarrays (SAM)是由斯坦福大学Tucher 等人开发出来用于识别基因芯片中显著差异基因的算法工具 该算法是控制假阳性率的一种方法,FDR在SAM中被定义为假阳性基因个数的中位数除以显著差异基因的个数。
首先计算每个基因的矫正的统计量(对于两类比较使用t检验,多类比较使用F检验),其分母包含一个“标准差修正因子”(Fudge Factor For Standard Deviation)用于稳定基因的特异的标准差估计量。
我们对这些统计量按升序排列(F(1), F(2), …, F(i), …, F(n)),其中n是基因总数。然后我们对分组变量进行随机组合置换,每次计算以上的统计量序列。期望的序列统计量就是每次组合置换的序列统计量的均值。
我们比较真实分组与置换期望的序列统计量,定义F(i*)(Δ)为阈值点,其中i*( Δ) 是真实分组统计量大于期望统计量至少Δ数值的第一个序数i。统计量大于此阈值点的基因被认为是“显著差异基因”。
如果在真实分组认定为“显著”基因在随机置换过程中被评估为假阳性,那么计算整个所有置换中假阳性基因数的中位数。该中位数再乘以一个收缩因子,该收缩因子代表了真实的基因在数据集中的比例。
具体是这样计算的:收缩因子等于真实统计量落入所有基因在置换中的25%~75%区间的个数,再除以基因总数的1/2。如果收缩因子大于1,那么使用1代替。某个Δ值下的FDR就等于假阳性基因个数的中位数乘以收缩因子再除以“显著的”基因数。
在SAM工具中,需设定FDR和列置换的次数,然后会自动搜索Δ的范围并最终给出一个优化Δ。“标准差修正因子”则通过搜索一定范围内的可能值,并最终给出一个最小化的变异系数即修正统计量的中位绝对差值(minimizes the coefficient of variation of the median absolute deviation of the modified F-statistics)。
参考链接
github实现
[SAM算法提出文献](https://www.ncbi.nlm.nih.gov/pmc/articles/PMC33173/
综述
https://zhuanlan.zhihu.com/p/569002791
芯片显著性分析(SAM)
SAM是使用改进的t-statistics (q-value)来识别在蛋白质组数据中多组样本之间的差异表达蛋白,该方法衡量蛋白质丰度和疾病结果之间关系的强度。与小样本量的常规t-test不同,SAM算法非常适用于大数据,通过对蛋白质丰度的列进行置换,并通过最近邻算法自动插补缺失数据,使假阳性和假阴性的数量最小化。此外,SAM的一个有价值的特点是,它利用数据的排列组合给出了错误发现率的估计值,即可能被偶然确定为有意义的蛋白质的比例。
Cui M, Cheng C, Zhang L. High-throughput proteomics: a methodological mini-review[J]. Laboratory Investigation, 2022: 1-12.