O2PLS 原理 O2PLS(Second-order Orthogonal Partial Least Squares)是对 OPLS(正交偏最小二乘法)的扩展。
mp.weixin.qq.com/s/04NzRgsBfMoW1dFXqZJ6zQ
1. OPLS 回顾
OPLS(Orthogonal PLS)做的事是:
- 在 里提取一个或多个 与 相关的预测成分 ;
- 剩余的方差分解成与 无关的 X 正交成分 ;
- 数学形式:
其中:
- :预测得分矩阵(与 有关)
- :X 正交得分(与 无关)
OPLS 只对 做正交化,不对 做正交化。
2. O2PLS 的核心思想
O2PLS(Bidirectional Orthogonal PLS)是 OPLS 的双向版本,既考虑 的正交部分,也考虑 的正交部分。
它把 和 分解为三部分:
- 共同结构(共变异,与另一方相关的部分)
- 各自的正交结构(与对方不相关的系统变异)
- 噪声残差
形式上:
- 、:预测成分(双向相关)
- :X 正交成分(与 无关)
- :Y 正交成分(与 无关)
区别:
- OPLS 只有 ,剔除的是 X 中与 Y 无关的部分;
- O2PLS 同时剔除 和 ,把 Y 中与 X 无关的部分也剔掉。
3. 从 OPLS 到 O2PLS 的过程
-
先做 OPLS(X 正交化)
得到:- :预测得分
- :X 正交得分
- 、:载荷矩阵
-
计算 Y 的残差部分
用预测得分 去回归 Y:然后得到:
这部分就是 Y 中与 X 不相关的成分候选。
-
对 Y 残差做 PCA / OPLS-like 正交化
提取 Y 中的正交成分 ,以及对应的载荷 。 -
得到双向正交分解
此时你有:- 、:共同预测成分(X 端)
- 、:共同预测成分(Y 端,通常与 对应)
- 、:X 正交成分
- 、:Y 正交成分
-
形成 O2PLS 模型结构
其中 和 是通过最大化协方差得到的。
4. 直观理解
- OPLS = 从 X 中去掉与 Y 无关的系统性方差,保留预测部分。
- O2PLS = 双向去无关方差:
从 X 去掉与 Y 无关的部分;
从 Y 去掉与 X 无关的部分;
中间保留共同的变异结构。
5. 实际意义
- OPLS 更适合建模预测(例如 OPLS-DA)。
- O2PLS 更适合做数据整合(multi-omics、双模态分析),因为它对两边数据都做了对称的正交分解,可以更准确地识别“共享结构”与“私有结构”。
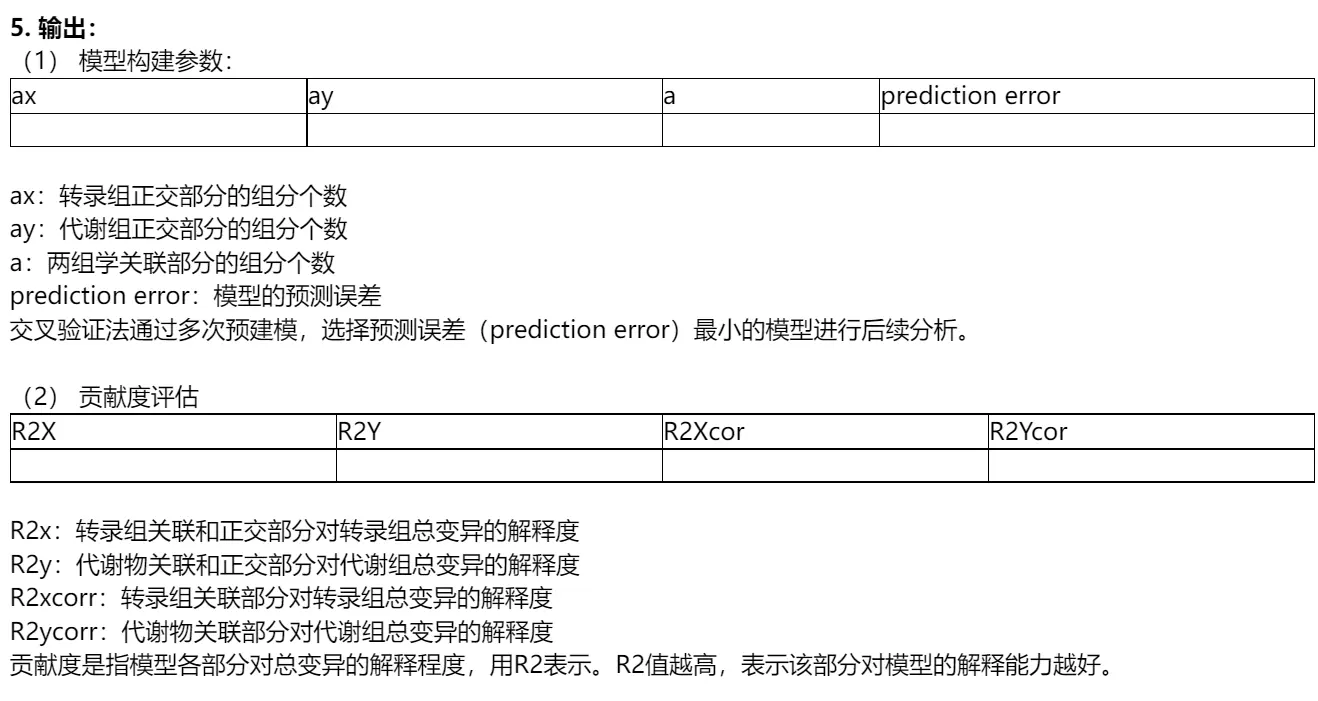
这个函数 crossval_o2m_adjR2 是用来执行 交叉验证(Cross-Validation, CV),并评估一个多数据集模型的拟合效果,用于选择MSE最小的。
. MSE:均方误差(Mean Squared Error),是模型预测误差的标准指标,计算的是预测值与真实值之间差异的平方的平均值。MSE 越小,表示模型的预测能力越强,误差越小。
- 这些值代表在不同参数组合下,模型的误差情况。
1. **a**
   - **作用**:指定考虑的 **联合成分数(joint components)**。这些成分是X和Y之间共同的特征,表示X和Y数据集中最相关的部分。通常这个参数会包含一个整数值,表示我们希望同时建模的成分数。

1. **ax**
   - **作用**:指定考虑的 **X-specific 成分数**。这些成分仅与输入数据X相关,而不涉及输出数据Y。它们反映了X数据集独立的特征。

1. **ay**
   - **作用**:指定考虑的 **Y-specific 成分数**。这些成分仅与输出数据Y相关,而不涉及输入数据X。它们反映了Y数据集独立的特征。

1. **nr_folds**
   - **作用**:交叉验证的折数。


  MSE      n  nx ny
1 1.290579 1  1 10
2 1.284161 2  1 10
3 1.299483 3  1 10
1
-
分析是否可以仅进行Z-Score标准化?,Z-Score标准化消除尺度差异,使得 O2PLS 分析能够聚焦于不同变量间的关系。然而,是否能够仅依赖 Z-Score标准化 还需要考虑以下几点:
-
数据类型和分布:如果数据本身是经过合适的定量测量且没有显著的样本间偏差或噪声,单独使用 Z-Score标准化 是可以的。
-
分析目标:如果你只关心基因与代谢物之间的联合模式而不特别关注样本间的偏差(例如总表达量差异),则只进行 Z-Score标准化 是足够的。
-
低变基因和总和标准化的影响:对于 RNA-Seq 数据,如果基因的变异性非常低(绝大多数基因的表达量变化很小),不去除低变基因可能会引入噪声,影响模型的稳定性。
-
在代谢数据中,如果数据涉及相对丰度,进行 总和标准化 可以消除样本间的浓度差异,因此不进行这一步可能会导致样本间差异未能得到有效的控制。
如果代谢物数据是相对丰度数据,推荐进行 总和标准化,以消除样本间的测量差异。
如果 RNA-Seq 数据的样本间存在显著的总体表达量差异,建议进行 中位数归一化。
如果数据中存在 低变基因,去除这些基因可能会改善模型的稳定性和预测能力。
我明白了,你是想问 O2PLS 里:
- 怎么从第一对联合预测成分(共同结构)往下得到第二对联合成分;
- 以及怎么得到第3个成分是 X 端特异性、第4个成分是 Y 端特异性那部分。
1. O2PLS 成分类型回顾
O2PLS 把 X 和 Y 分成三块:
-
共同结构(joint predictive components)
- 对应第一、第二、…对“联合成分”
- 两端是成对的,最大化协方差
-
X 端特异性(orthogonal to Y)
- :X 的正交成分(与 Y 不相关)
-
Y 端特异性(orthogonal to X)
- :Y 的正交成分(与 X 不相关)
2. 第一对联合成分(Joint Component 1)
算法类似于 PLS,只是多了正交化:
-
去除两端的正交部分(如果是迭代过程的中间步骤,这一步可能为空)
-
在 X、Y 上做 最大化协方差 的 SVD / NIPALS:
-
得到第一对预测得分:
-
计算载荷:
-
残差更新:
3. 第二对联合成分(Joint Component 2)
直接在残差矩阵 上重复上面的最大化协方差过程:
-
从上一步的残差开始(已经去掉了第一对联合成分的贡献)
-
再次做 SVD / NIPALS 找到新的方向
-
得到:
-
计算载荷、更新残差
这样就得到了第二对联合成分。
4. 第3个成分:X 特异性(Orthogonal to Y)
当你设定“X 端正交成分个数 = 1”时:
-
用当前 X 残差矩阵和 U 的预测得分做回归:
其中 的方向要求:
即与所有 Y 预测得分正交。
-
得到 X 特异性载荷:
-
更新 X 残差:
5. 第4个成分:Y 特异性(Orthogonal to X)
同理,从 Y 残差矩阵提取与 X 预测得分正交的方向:
-
求:
满足
-
计算 Y 特异性载荷:
-
更新 Y 残差:
6. 总结流程(O2PLS迭代)
- 从原始 X、Y 去掉上一轮提取的所有成分
- 提取一对新的联合成分(最大化协方差)
- 提取 X 正交成分(与 Y 联合成分正交)
- 提取 Y 正交成分(与 X 联合成分正交)
- 重复步骤 1–4,直到达到设定的成分数
如果你愿意,我可以帮你画一张“成分提取顺序时间线图”,把 第1、2联合成分 和 第3 X 特异性成分、第4 Y 特异性成分 的计算顺序和残差更新路径画出来,看起来就像算法流水线,会特别清晰。
要我画吗?
是的,O2PLS 选择了 3 个联合成分(joint components)后,剩下的残差会用于计算组内特异性成分(X-specific components 和 Y-specific components)。这是 O2PLS 模型的基本机制,也是为什么选择不同数量的联合成分(例如,3 个联合成分 vs. 4 个联合成分)会导致不同结果的原因。
1. O2PLS 模型的工作原理
在 O2PLS 中,模型通过将两个数据集(比如 RNA 表达数据和代谢物数据)分解为以下几部分:
-
联合成分(Joint components):这部分成分描述了两个数据集之间的共变结构,即 X 和 Y 之间的共同变异。联合成分反映了两个数据集共享的特征。
-
组内特异性成分(X-specific components 和 Y-specific components):
- X-specific components:描述仅与 RNA 数据(X)相关的变异。即,X 中的变异不能通过 Y 中的变异来解释。
- Y-specific components:描述仅与 代谢物数据(Y)相关的变异。即,Y 中的变异不能通过 X 中的变异来解释。
5. 选择联合成分的数量:如何决定最优数目
-
交叉验证(Cross-validation):通常,选择 O2PLS 模型的联合成分数量可以通过交叉验证来确定。通过在不同数量的联合成分下进行交叉验证,比较模型的预测性能(如误差或 R² 值),从而选择一个最优的联合成分数。
-
模型复杂度与过拟合:增加联合成分的数量可以捕获更多的共变信息,但也可能导致过拟合。因此,选择合适的联合成分数是一个平衡的问题,需要避免过多的成分导致模型复杂度过高,而损害泛化能力。
-
3 个联合成分和 4 个联合成分的不同结果,主要是因为:
- 联合成分 捕获了 X 和 Y 之间的共变信息,选择不同数量的联合成分会影响剩余的变异分配。
- 选择 更多的联合成分(如 4 个)意味着更多的共变信息被捕获,因此剩余的变异较少,导致 X-specific 和 Y-specific 成分 相对较小。
- 选择 较少的联合成分(如 3 个)意味着剩余的变异较大,更多的变异被分配给 X-specific 和 Y-specific 成分,这些特异性成分可能会更加显著。
如果你想得到一个稳健的模型,可以通过交叉验证选择最优的联合成分数量,这样可以平衡模型的拟合程度和泛化能力。
是的,将 X-specific 和 Y-specific 成分设置为 0,意味着你假设所有的差异都来自于 联合成分(joint components),而不考虑 X(RNA 或基因表达数据)和 Y(代谢物数据)各自的特异性变异。
在 O2PLS 中,假设我们有如下的数据模型:
- 为第一个数据集(例如,RNA 表达数据),
- 为第二个数据集(例如,代谢物数据)。
模型可以分解为以下部分:
其中:
- 是联合成分的得分矩阵(Joint component scores),
- 和 分别是联合成分的载荷矩阵(loading matrices),
- 和 是 X 和 Y 中的残差(即 X-specific 和 Y-specific 部分,表示不被联合成分解释的部分)。
X-specific 和 Y-specific 成分的意义
在 O2PLS (Orthogonal Two-Block Partial Least Squares)模型中,X-specific 成分 和 Y-specific 成分 分别代表了仅与 X 数据集(例如 RNA 数据集)和 Y 数据集(例如代谢物数据集)相关的特异性变异。它们是 O2PLS 模型中的重要组成部分,用于捕捉每个数据集的独立变异性,而不涉及两个数据集之间的共变结构。
X-specific 成分
- 定义:X-specific 成分描述了 X 数据集(例如 RNA 数据集)中那些与 Y 数据集(代谢物数据集)无关的变异,即 X 数据集中仅由其自身的特征或变量驱动的变化。
- 作用:这些成分捕捉了 X 数据集中的独立变异,即 X 数据集中的 特定基因表达模式。通过 X-specific 成分,你可以理解在 X 数据集(基因表达)中,哪些变化是 独立于代谢物变化 的。
X-specific 和 Y-specific 成分的用途
在 O2PLS 中,X-specific 和 Y-specific 成分的使用主要体现在以下几个方面:
1. 揭示每个数据集的独立信息
- X-specific 成分 可以帮助你理解基因表达数据集中那些 独立于代谢物信息的变化模式。例如,这些变化可能是由基因调控、转录因子活性或其他生物学机制驱动的。
- Y-specific 成分 可以帮助你理解代谢物数据集中那些 独立于基因表达信息的变化模式。这些变化可能与代谢路径、酶活性或环境因素相关。
通过 X-specific 和 Y-specific 成分,你可以分别了解 基因表达 和 代谢物 数据集中的变化模式,同时避免把两个数据集之间的共变信息混合在一起。
2. 去除共变干扰
X-specific 和 Y-specific 成分可以帮助你在分析中 去除 可能来自两个数据集之间共变的干扰,使你能 聚焦于每个数据集的独立特征。例如,在进行代谢物的分析时,去掉 X-specific 成分的干扰可以让你更准确地理解代谢物的变化和它们自己的特征,而不被基因表达数据的变化所影响。
3. 识别潜在的生物学机制
- X-specific 成分 可以揭示基因表达数据集中一些可能与特定代谢物不相关的变异。例如,这些成分可能与某些 生物过程 或 信号通路 有关,这些过程和通路可能没有直接的代谢物关联。
- Y-specific 成分 可以帮助你识别代谢物中与基因表达变化无关的变异,可能涉及 代谢通路、代谢酶活性 或其他生物标志物,这些变异可能在 独立的环境或疾病状态下 发生。
联合成分数量 r 的作用
-
揭示 X 和 Y 之间的共变结构
- O2PLS 旨在找出 X 和 Y 数据集之间的关系。联合成分越多,模型可以捕捉到的 X 和 Y 之间的共变信息就越多。选择合适的 r 值 可以帮助我们理解 X 和 Y 数据集之间 共享的生物学模式(如基因表达和代谢物变化之间的关系)。
- 例如,假设 X 是基因表达数据,Y 是代谢物数据。如果选择 3 个联合成分,那么 O2PLS 会尝试从 X 和 Y 数据集中提取 3 个共变的模式,揭示这两个数据集之间最显著的联系。
-
决定模型的复杂度,过多 过拟合 过少 拟合不足
-
帮助选择模型参数
- 通过交叉验证等方法选择合适的联合成分数量(r),可以确保模型的泛化能力。通常,在选择联合成分的数量时,交叉验证(例如 K-fold CV)被用来选择 最佳的 r 值,即选择能够 最小化预测误差 的联合成分数量。
-
揭示生物学解释
- 在 O2PLS 分析中,联合成分帮助我们发现 X 和 Y 数据集之间的 共同变化模式,这些模式通常是由某些生物学机制或过程驱动的。
- 例如,选择合适数量的联合成分可以帮助我们识别基因表达和代谢物数据中可能存在的 共变生物学通路,例如,基因表达模式与代谢物变化之间的直接关联。
- r 的选择 可以影响你从这些成分中提取到的生物学信息。例如,选择较少的联合成分(如 r = 2)可能会使你只能观察到 最强的基因与代谢物的共变关系,而选择更多的联合成分(如 r = 5 或 6)可能揭示出更多的细节和更复杂的生物学关系。
-
控制噪声
- 适当选择联合成分数量可以 减少噪声的干扰。过多的联合成分可能捕捉到训练数据中的 噪声,使得模型在测试数据集上的表现变差。适当的联合成分数量有助于 提高模型的稳定性和可靠性。
- 如果联合成分过多,模型可能会学习到不具有普遍性的模式,导致过拟合。因此,通过选择合适的 r 值,可以避免模型对数据噪声的过度敏感。
如何选择合适的联合成分数量(r)
选择合适的 r 值通常是一个 试探性过程,以下是常见的选择方法:
-
交叉验证:通过在不同的 r 值下进行交叉验证(例如 K-fold CV),计算模型的预测误差,选择具有 最低预测误差 的联合成分数量。
-
解释方差:观察联合成分所解释的方差,通常 前几个联合成分 会解释大部分的方差。选择可以解释大部分方差且不会引入过多噪声的成分数量。
联合成分数量(r) 是 O2PLS 模型中的关键超参数,它决定了 X 和 Y 数据集之间共享变异的捕捉程度。选择合适的 r 值有助于:
- 揭示 X 和 Y 之间的 共变结构;
- 控制模型的复杂度;
- 提供对生物学机制的 深入解释;
- 优化模型的 预测性能。
“共享的结构信息”指的是在 X 和 Y 数据集之间存在的一些 共同变化模式,这些模式表明 X 和 Y 数据之间有某种程度的相关性或相互关系。这种共享信息可以通过 联合成分(Joint Components) 来捕捉和揭示。通过联合成分,O2PLS 模型能够找到 X 和 Y 中的共变结构,即那些在两个数据集上同时发生变化的因素或模式。
-
X 和 Y 数据集之间的共同变异:
- 假设 X 是基因表达数据,Y 是代谢物数据。在 O2PLS 模型中,联合成分 提取的是 基因表达数据和代谢物数据中同时变化的部分。如果某些基因的表达变化和某些代谢物的变化相关联,那么这部分变化就会体现在联合成分中。
- 例如,基因表达的上调可能伴随着代谢物浓度的增加,这种上调和增加的关系就是共享的结构信息,它反映了 基因和代谢物之间的共变关系。
-
共同变化的模式:
- 共享结构信息的本质就是 共变模式。例如,如果一个特定的基因群体在某些条件下表达上调,且这些基因的表达变化与代谢物的某些浓度变化有同步性,那么这些基因和代谢物的变化就体现为共享的结构信息。这些信息反映了基因和代谢物之间的潜在关联。
- 在 O2PLS 中,模型会试图找到这种 共变结构,也就是基因和代谢物数据集的相互作用部分,它们在 联合成分 中得到了体现。
-
揭示生物学关联:通过捕捉 X 和 Y 数据集之间的共享结构信息,O2PLS 帮助我们识别 基因表达与代谢物之间的潜在生物学关系。例如,通过这种分析,我们可能发现某些基因的表达与代谢物的变化紧密相关,这为我们理解基因如何调控代谢路径提供了新的线索。
-
数据集的协同效应:O2PLS 通过联合成分提取出的共享结构信息,也有助于揭示 X 和 Y 数据集的协同效应。例如,在疾病研究中,基因表达和代谢物浓度的变化可能共同反映疾病的生物标志物,联合成分能够帮助我们找到这些协同作用的潜在信号。
-
减少噪声,集中捕捉有意义的变异:通过聚焦于 X 和 Y 之间的共同变异,O2PLS 能够减少噪声和无关信息,从而更有效地提取出两个数据集之间的有意义的关系。
假设我们有基因表达数据和代谢物数据,O2PLS 分析的目标是揭示这两个数据集之间的关联。如果我们选择了联合成分数量为3,那么O2PLS 会提取出 3 个描述 X 和 Y 之间共享变异 的成分。每个联合成分都代表一个 潜在的生物学过程或机制,在这个过程中,基因表达和代谢物的变化是协同的。例如:
- 联合成分1 可能揭示了某些与能量代谢相关的基因与代谢物的共同变化。
- 联合成分2 可能揭示了与免疫反应相关的基因和代谢物的共同变化。
- 联合成分3 可能揭示了与细胞调控相关的基因和代谢物的共变关系。
通过这些联合成分,我们能够在基因和代谢物数据之间建立联系,发现它们如何共同作用于生物学过程。
“共享的结构信息”就是 X 和 Y 数据集之间 共同变化的模式,这部分信息揭示了两个数据集之间的关联或共变关系。O2PLS 通过联合成分提取这种共享变异,帮助我们理解 基因和代谢物之间的潜在生物学关系,并为进一步的生物学解释和发现提供重要线索。
3. 如何解读载荷图
载荷值越大,表示该变量对主成分的贡献越大。反之,载荷值越小,表示该变量对主成分的贡献越小。
- 如果一个原始变量(例如,X1,X2,…X_1, X_2, \dots)在载荷图中远离原点,说明该变量对该成分有较大的贡献。
- 如果载荷值接近 0,说明该变量对该成分的贡献较小,甚至没有贡献。
(4) 载荷的分布
- 如果变量在载荷图中靠近 原点,这表明它对该成分的贡献较小,或者说它对该成分的变异贡献较低。
- 如果多个变量聚集在一起,并且与某个主成分(如第一主成分)呈现出强相关性,说明这些变量在这个主成分的解释中起到了重要作用。
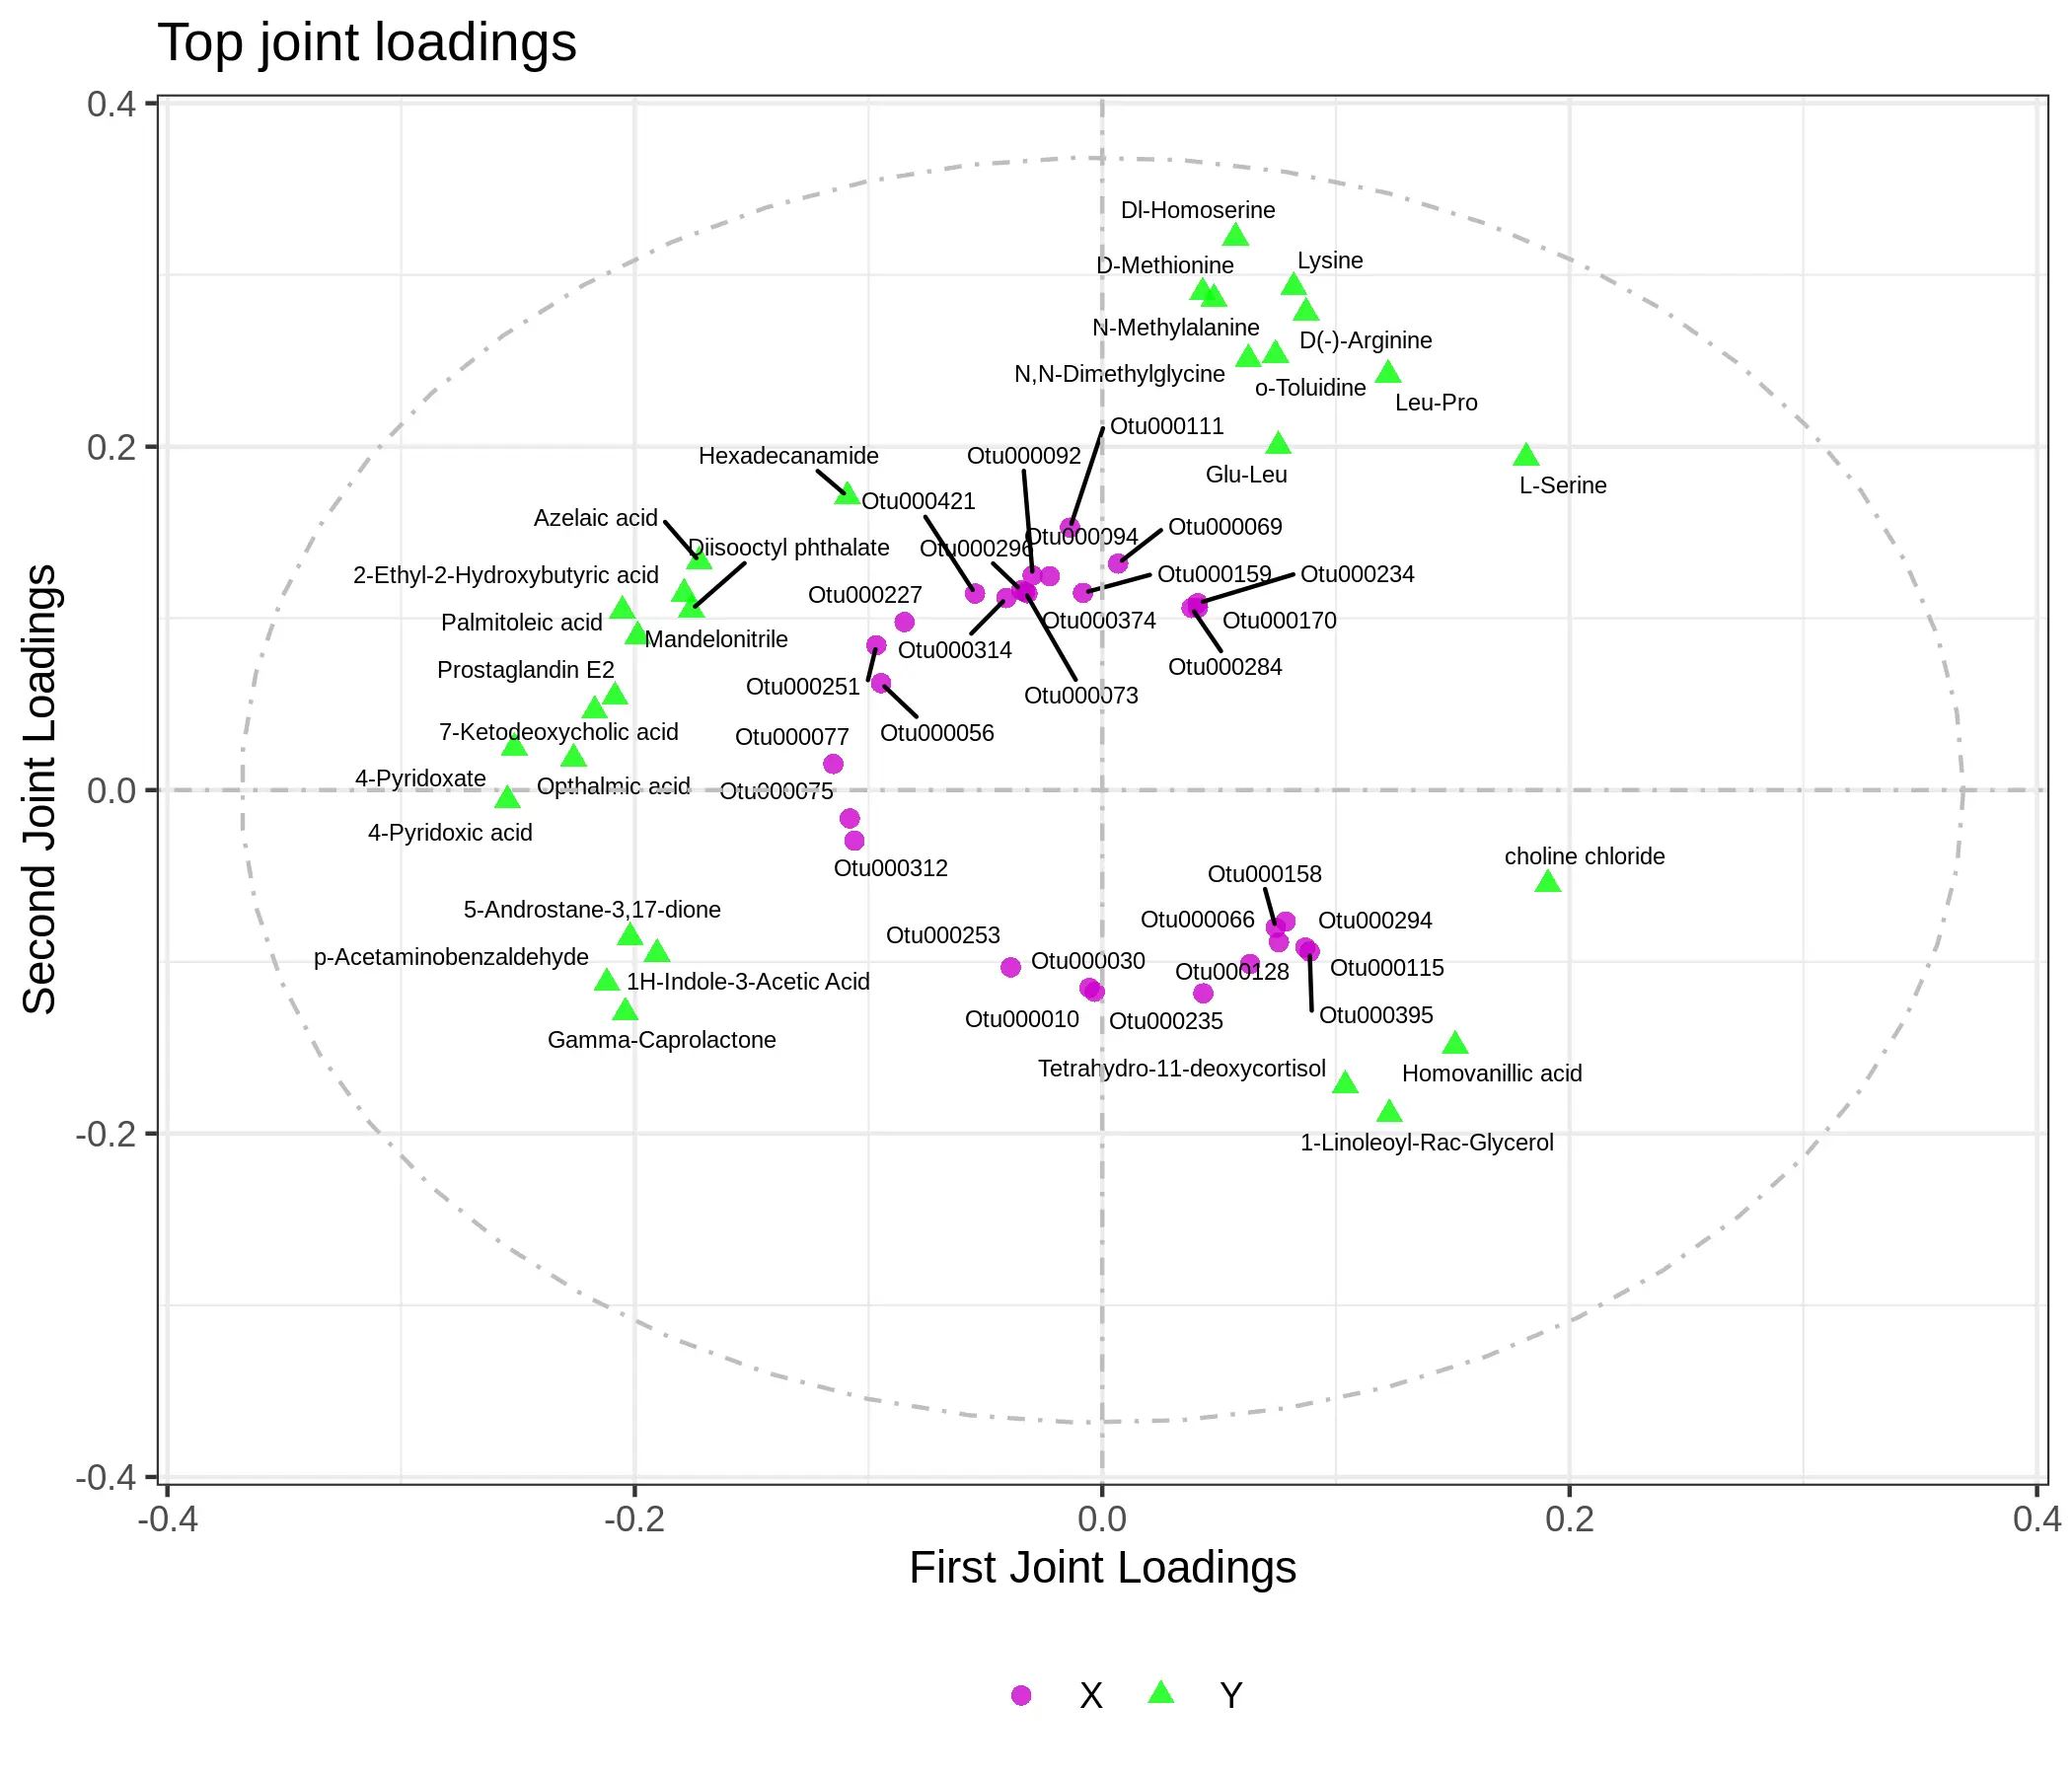
4. O2PLS 载荷图(First Joint Loading 和 Second Joint Loading)
-
解释变量之间的关系:
- 变量之间的 距离 和 方向 提供了它们之间的相关性信息。距离较近的变量通常是相关的,而方向相反的变量可能表示负相关。
- 那些变量影响力主成分
-
理解与目标变量的关系:
- 在 第一层载荷图 中,分析与目标变量(YY)相关的成分。载荷图可以告诉你哪些变量对目标变量的预测具有重要作用。
-
正交成分的影响:
- 在 第二层载荷图 中,观察变量如何影响与目标无关的正交成分。这些成分帮助你理解数据中未被目标变量解释的部分。
-
联系:
- 每个 得分 都是通过将样本的原始数据投影到主成分上得到的,得分图显示了样本在这些主成分上的分布。
- 每个 载荷 都是计算主成分时,用于加权变量的系数,载荷图显示了哪些变量对主成分的贡献最大。
也就是说,得分 反映了 样本 如何在主成分空间中分布,而 载荷 反映了 变量 如何在主成分空间中投影。
误差 通常指的是模型没有解释的部分,通常会被视为模型的残差,而 join 在 O2PLS 中更准确地说是处理那些无关的变异,去除掉它
❌ 误解1:「第二联合成分是正交成分的分析」
- 联合成分(Joint components) 是解释 X 和 Y 相关的变异(也就是“两个数据集共享的信息”)
- 正交成分(Orthogonal components) 是解释 X 或 Y 自己特有、与对方不相关的变异
✅ 正确认识:第二联合成分的意义是什么?
O2PLS 把“X 和 Y 之间的关系”分成多个方向(成分)来描述:
- 第一联合成分:解释 X 和 Y 中最强的相关性方向(比如主通路、主要调控轴)
- 第二联合成分:解释剩下的相关性中的第二强部分,可能是另一个生物过程或次级机制
所以,第二联合成分的生物学意义通常是:
- 次级通路:一个不如第一成分强,但依然存在的 跨组学耦合机制
- 分层调控:第一成分可能是炎症反应,第二成分可能是代谢调节
- 亚群驱动:第二成分可能捕捉了某些样本子群之间的 差异性共变
- 时间进程或剂量反应:比如在动态实验中,不同时间点的相关机制
✅ 如何解释第二联合成分的生物学意义?
=以下是标准分析流程:=
1. 看 loading(载荷)
- 找出在第二联合成分中 loading 高的基因/代谢物(在 , 中)
- 这些变量是这个共变异模式的“主角”
2. 做富集分析(GO, KEGG, pathway analysis)
- 对这些高 loading 的变量做功能注释或通路分析,找它们集中在哪些生物过程
- 看是否代表一个新的调控轴或通路模块
3. 看样本的得分(scores)
- 分析样本在第二成分上的得分(比如 )
- 看是否与 分组、表型、时间、剂量 有关联,或者能把样本进一步区分开
4. 结合第一联合成分一起看
- 比较第一和第二成分上的样本分布,有时可以揭示 多维调控关系或分层结构
你做 RNA-seq 和 metabolomics 联合分析:
- 第一联合成分揭示的是:炎症相关基因↑ → 嘧啶代谢物↑
- 第二联合成分则显示:脂代谢基因↑ ↔ 胆固醇类代谢物波动
这时第二联合成分就可能提示一个独立的调控子系统,可能与能量代谢、氧化应激或药物反应有关。
第二联合成分仍然描述的是 X 和 Y 的“共享信息”,只是它代表的是 另一条相对较弱但独立的生物学相关路径。它可以揭示出主调控通路之外的 次级机制、样本亚群差异或多层次调控网络。
这个问题问得非常细致,也非常重要!👏
✅ 第二联合成分(2nd joint component)
- 来自 X 和 Y 的共同变异结构
- 代表两个数据集之间 次一级的相关性模式
- 比如:第一联合成分是炎症↔能量代谢,第二成分可能是免疫调控↔脂代谢
🧪 用于解释:两个组学之间的协同变化
✅ 第二正交成分(2nd orthogonal component)
- 是某个数据集(比如 X)中 独立于 Y 的变异
- 在 O2PLS 中用来 去除无关信息,提纯真正的相关性
- 第二个正交成分,说明这个数据集中还有一个次级的内部变异模式,但它跟另一个数据集没啥关系
🧪 用于解释:X 或 Y 中自己的噪声/结构特有信息
假设你在研究「基因表达(X)」和「代谢物(Y)」之间的关系:
| 成分类型 | 代表什么? |
|---|---|
| 第一个联合成分 | 炎症相关基因 ↔ 嘧啶代谢物变化(主相关性) |
| 第二个联合成分 | 免疫调节基因 ↔ 脂代谢物(次级相关性) |
| 正交成分 1 | 与代谢物无关的基因表达变化(比如 batch effect) |
| 正交成分 2 | 另一个不相关的基因调控模块 |
所以:
第二正交成分载荷图 ≠ 第二联合成分载荷图
05.2 O2PLS
挑选两个组学数据中的Joint part部分,分别绘制载荷图。通过载荷图初步判断不同数据组中相关性和权重都比较高的变量,筛选出影响另一组学的重要变量。在载荷图总每个点到原点的距离意味着和另外一个组学相关性的大小,图中越靠近外圈的因子(基因和代谢物),为两组学关联越高的因子。图中标示出对另一个组学影响较大的前10个基因、代谢物。 选取所有的差异基因、差异代谢物建立 O2PLS 模型,通过载荷图初步判断不同数据组中相关性和权重都比较高的变量,筛选出影响另一组学的重要变量。图中每个点到原点的距离高度代表基因或者代谢物和另外一个组学相关性的大小,且颜色越深表示相关性越大图中标示出对另一个组学影响较大的前 10 个基因/代谢物。
筛选前两个维度loading值平方和
两组学关联载荷图
根据元素loading值结果,我们筛选出前两个维度loading值平方和前n个基因和代谢物进行整合绘制loading图,以展示关联程度最大的基因和代谢物。(这里的n在显示标签提前设置) 在坐标中,载荷值绝对值的大小表示两组学关联的强弱,绝对值越大,表明此元素与另一组学的关联程度越强
在 O2PLS(或者 PLS)里:
-
X 端 first joint loading
表示 X 各变量在第一联合成分方向上的贡献。 -
Y 端 first joint loading
表示 Y 各变量在第一联合成分方向上的贡献。
它们是针对各自数据块定义的,量纲和取值范围由原始变量的缩放方式决定(通常是 autoscaling 后量纲一致,但仍然是两组不同变量的系数)。
2. 为什么 t 和 u 可以放一起,而 p 和 q 不行
-
t 与 u
在 O2PLS / PLS 中,t(X 得分)和 u(Y 得分)是通过最大化协方差求出来的,理论上线性相关:所以它们的数值范围是可比的,可以画在同一个得分图(score plot)上,甚至直接用 t 当横轴、u 当纵轴做相关性图。
-
p 与 q
载荷向量是两套不同的投影系数:-
是 X 变量在 t 方向上的权重
-
是 Y 变量在 u 方向上的权重
-
它们的绝对数值大小没有直接可比性,因为:
- 定义时除的分母不同( vs )
- t 和 u 之间可能有比例系数 ,会传递到 p、q 的大小里
- X 和 Y 变量的数目、方差结构也可能完全不同
-
所以,即使第一对 joint component 在方向上是线性相关,p 和 q 也不是在同一量纲下的向量,直接放一张图比较大小会有误导。
3. 如果真的想比较 p 和 q
有几种方法:
-
标准化到单位长度
把 p 和 q 分别除以自己的范数(或最大值),让它们都在 [-1,1] 范围内,再画同一张图。
这样比较的是相对模式,而不是绝对权重。 -
通过 t-u 关系转换
如果 ,那么可以用这个 b 调整 q 的尺度,让它跟 p 在可比框架内:这样对模式对齐更准确。
-
Canonical correlation / 共通得分空间
把 X、Y 的加载向量都映射到共同的 canonical variate 空间中比较。
4. 结论
- 得分 (t,u) → 可以直接放一起,因为是同一个成分方向的两个表现形式。
- 载荷 (p,q) → 不应直接放一起比较绝对值,因为量纲和缩放方式不同;如果一定要放在同一图中,需要标准化或调整到共同尺度。
# 安装必要的包
install.packages("permute")

# 置换检验的代码
set.seed(123)  # 设置种子

# 定义置换检验的函数
permute_test <- function(rna, metab, nr_permutations = 1000) {
  original_model <- crossval_o2m_adjR2(rna, metab, 1:5, 1:5, 1:5, nr_folds = 10, nr_cores = 4)
  original_score <- original_model$MSE  # 这里假设你想看 MSE

  # 初始化置换结果
  permute_scores <- numeric(nr_permutations)

  # 进行置换
  for (i in 1:nr_permutations) {
    # 对 Y 数据进行置换
    metab_perm <- metab[sample(nrow(metab)), ]
    permute_model <- crossval_o2m_adjR2(rna, metab_perm, 1:5, 1:5, 1:5, nr_folds = 10, nr_cores = 4)
    permute_scores[i] <- permute_model$MSE  # 计算每次置换的 MSE
  }

  # 比较原始模型和置换模型
  p_value <- mean(permute_scores <= original_score)  # 计算 p 值

  return(list(original_score = original_score, p_value = p_value))
}

# 运行置换检验
permute_result <- permute_test(rna, metab)
print(permute_result)
# 使用 permute 包生成置换数据
permute_test <- function(rna, metab, nr_permutations = 1000) {
  original_model <- crossval_o2m_adjR2(rna, metab, 1:5, 1:5, 1:5, nr_folds = 10, nr_cores = 4)
  original_score <- original_model$MSE  # 这里假设你想看 MSE

  # 进行置换
  permute_scores <- numeric(nr_permutations)
  for (i in 1:nr_permutations) {
    # 使用 permute 包进行置换
    metab_perm <- permute::shuffle(metab)  # permute 包的置换函数
    permute_model <- crossval_o2m_adjR2(rna, metab_perm, 1:5, 1:5, 1:5, nr_folds = 10, nr_cores = 4)
    permute_scores[i] <- permute_model$MSE
  }

  # 计算 p 值
  p_value <- mean(permute_scores <= original_score)

  return(list(original_score = original_score, p_value = p_value))
}

# 运行置换检验
permute_result <- permute_test(rna, metab)
print(permute_result)
- 当你选择更多的联合成分时
- 虽然第二个联合成分会被计算出来,它可能没有太多实际的解释力,可能只是捕捉了数据中的随机变化
- 模型可能不稳定,且容易受到样本波动的影响
- 影响后续的 X-specific 和 Y-specific 成分
- 选择的联合成分数超过了数据的真实结构需求,交叉验证结果(如 MSE 或 R²)可能不会表现得很好,或者对于测试数据的性能评估可能较差。
实际最优成分数为 1 的情况通常出现在数据结构较简单、变量之间的相关性较强,或数据本身的变化模式较为一致的情况下。以下是几种可能出现实际最优成分数为 1 的情境:
1. 数据之间的强相关性
- 如果 X 和 Y 两个数据集之间具有很强的线性关系或共同变异(例如高度相关的代谢物和基因表达数据),则大多数的信息可能都集中在第一个成分中。这种情况下,1 个联合成分就足够捕捉数据中的大部分变异。
- 例如:如果基因表达数据和代谢物数据是由某个共同的生物学过程驱动的,且它们之间的相关性较高,那么第一个成分就可能解释大部分的变异。
2. 数据维度高但样本数小
- 当数据的维度很高(即变量数多)但样本数很少时,常常只有 1 个主要的成分能够代表数据中的大部分方差。其他成分往往只是噪声或非常小的变异,并不能提供有意义的结构信息。
- 例如:如果你有 1000 个代谢物特征和 6 个样本,可能大部分的方差已经被第一个成分解释,其他成分只是少量的噪声或不可辨识的随机波动。
3. 数据分布单一且没有复杂的模式
- 如果 X 和 Y 数据集中的大部分变化都来自单一的潜在变量(或共同因素),则可能只需要一个联合成分来捕捉所有的变异。比如,如果你的数据集只是简单的线性关系,或者只包含一种明确的变化趋势(例如所有样本都沿着一个主要的主成分分布),那么第一个成分就足够了。
- 例如:在某些简单的生物学实验中,可能仅有一个主效应变量(例如某种特定的代谢途径的变化),这个变量主导了所有基因和代谢物的变化。
4. 极少的噪声与变异
- 如果数据中的噪声很小,并且大部分的变异都是由少数几个因素(例如生物学特征或环境因素)驱动的,可能只需要一个成分就能充分解释数据的大部分变异。
- 例如:某些生物学实验中,代谢物与基因表达之间的关系非常明确,数据噪声较小,第一个成分就能够捕捉到大部分的信息。
5. 数据的层次结构简单
- 当数据具有较简单的层次结构或类内变异小,而类间差异大时,第一个主成分(联合成分)可能就足够解释数据的主要结构。例如,某些生物标志物或代谢途径的变化可能非常明确,且差异化明显,导致数据中的方差主要集中在第一个成分上。
- 例如:在某些疾病诊断的代谢物数据集中,可能所有样本都在一个主要方向上变化(例如高表达代谢物与低表达代谢物之间的变化),导致仅一个成分能解释所有的变异。
7. 仅有一个潜在的生物学过程主导
- 如果数据中只有一个生物学过程或者因素主导了所有变化,例如只有一个代谢途径的活动变化导致代谢物和基因表达的变化,那么所有的变异就集中在一个成分上。
- 例如:在一个单一疾病模型中,所有的基因和代谢物可能都受某个共同的因子(如某个转录因子)控制,导致数据中所有的变化都集中在第一个成分上。
总结:
- 1 个联合成分通常适用于以下几种情境:数据相关性强、数据维度高但样本数小、数据分布简单、噪声小、层次结构清晰,或者数据中只有一个主导因素。
- 如果你的数据存在非常明显的主效应或共有结构,模型可能只需要一个成分就能有效地解释大部分的方差。
如果选择的少了
-
无法捕捉所有共同变异,导致你识别出的代谢物对基因的影响的种类和数量会减少。在 5 个联合成分,但你选择了 2 个成分,这意味着你忽略了 3 个联合成分的信息。因此,你无法捕捉到基因和代谢物之间的全部相关性
-
选择较少的 联合成分 意味着你忽略了代谢物和基因之间的一部分潜在影响模式。联合成分反映了代谢物与基因表达之间的共享变异,少选择联合成分会导致模型无法全面捕捉所有这些影响,例如,假设代谢物 A 对基因 B 和基因 C 都有影响,但这些影响分别位于不同的联合成分中。选择的联合成分数目太少,可能会错过其中的一些影响模式,导致 A 对 B 或 C 的影响未被完全识别,进而影响最终鉴定出的代谢物与基因的关系。
-
结果的解释性下降
- 在 O2PLS 中,选择的 联合成分 会影响如何解释代谢物对基因的影响。选择过少的联合成分会导致 残差 增加,这些残差可能包含与代谢物和基因相关的有意义的变异信息,但由于残差中未被模型捕捉的变异,解释的准确性会受到影响。
- 解释能力下降意味着你无法准确地理解哪些代谢物对基因的影响是显著的,因为你的模型缺乏对数据中关键结构的充分捕捉。
-
多样性和复杂性丧失
- 如果代谢物和基因表达之间的影响是多样的和复杂的,少选择联合成分会导致模型无法反映这些复杂的关联。
- 举个例子,假设 代谢物 A 影响了基因 B 和 C,而 代谢物 D 影响了基因 E 和 F,但这些影响分别属于不同的联合成分。选择 2 个成分可能无法捕捉到这些复杂的相互关系,导致 A、D 等代谢物与基因的复杂影响被忽视或混淆。
- 如果代谢物和基因表达之间的影响是多样的和复杂的,少选择联合成分会导致模型无法反映这些复杂的关联。
-
潜在的假阴性
- 由于你忽略了联合成分中的一部分信息,选择较少的成分可能会导致出现 假阴性(false negatives)。也就是说,实际上有影响的代谢物和基因对可能没有被识别出来,从而漏掉了很多潜在的生物学重要信息。
1. 单个载荷图
单个载荷图是针对 X 和 Y 数据分别绘制的,表示 X 或 Y 数据的每个成分的载荷情况。
- X 单个载荷图:展示的是 X 数据中每个变量(例如基因)在每个成分上的载荷(loading)。载荷表示该变量在该成分上贡献的大小和方向。
- Y 单个载荷图:展示的是 Y 数据中每个变量(例如代谢物)在每个成分上的载荷。与 X 的载荷图类似,载荷值显示了代谢物在成分上的贡献。
解读方法:
- 载荷的符号(正负):决定了该变量和该成分的关系是正相关还是负相关。例如,正载荷表示该变量与成分正相关,负载荷表示负相关。
- 载荷的大小:表示变量对成分的贡献度。绝对值越大,贡献越大,通常意味着该变量对该成分的解释力越强。
- 载荷图中的变量:通过查看图中的位置,可以了解哪些变量对成分有较大贡献。位置接近原点的变量贡献较小,远离原点的变量贡献较大。
例如,如果你有基因表达数据作为 X,而代谢物数据作为 Y,你可能会在 X 的载荷图中看到某些基因的载荷较大,表示这些基因在成分上有较大贡献。同样,你可以在 Y 的载荷图中看到某些代谢物的载荷较大,表示这些代谢物在成分上有较大贡献。
2. 联合载荷图(Joint Loading Plot)
联合载荷图是 O2PLS 模型的关键,它展示了 X 和 Y 数据之间共享的变异。换句话说,联合载荷图展示的是 X 和 Y 中对两个数据集都影响较大的成分。
解读方法:
-
联合载荷图 显示的是 X 和 Y 之间在成分上的共同变异(即联合成分)。这些联合成分代表了两个数据集(例如基因和代谢物)之间的共变异或相关性。
-
X 和 Y 的载荷(联合载荷):图中通常有两个坐标轴,一个表示 X 的载荷,另一个表示 Y 的载荷。通过这些载荷,可以判断哪些变量在两个数据集之间具有较强的共变关系。
- 距离原点较远的点 表示对成分的贡献较大。
- 在同一方向上的点 表示这两个变量在该成分上有共同的变异模式。
- 反向的点 表示这两个变量在该成分上有相反的变异模式。
-
联合成分的含义:联合成分是 X 和 Y 之间共同的变异部分,也就是说它们共享的变异和相似的结构。它反映了两组数据之间的关联性。
联合载荷图的作用:
- 揭示 X 和 Y 之间的关系:通过联合载荷图,可以揭示基因表达数据和代谢物数据之间潜在的关系,了解哪些基因和代谢物是共同变化的。
- 解释生物学意义:如果某些基因和代谢物在联合载荷图中有明显的共同方向或高度相关,可能意味着它们在生物学过程中有某种共同的作用。