GSVA 中的“核函数” 和 SVM 中的“核函数”是不是同一个?
🔹 一、SVM 中的核函数(kernel function)
SVM 有一个非常著名的“核技巧”(kernel trick):我们无法直接在低维空间中分开数据,于是使用核函数,把数据映射到更高维的特征空间,在高维空间中用线性分类器分开它。
一个核函数本质是一个内积函数:
- 这里 是某种非线性映射
核函数度量的是:两个样本在高维空间中的相似性
🔹 二、GSVA 中的核函数(Kernel in GSVA)
GSVA 中所谓的核函数,和统计中 kernel density estimation(核密度估计)类似:
- 把每个基因表达量估计为一个概率密度函数
- 类似于画一个“平滑的直方图”(而不是柱状的),这就是我们说的“频率图”的来源
GSVA 中默认使用的核是:
是一个叫 Epanechnikov 的核函数(很像核密度估计的核)
GSVA 的核函数 ≈ 核密度估计中用于平滑表达值的工具
SVM 的核函数 ≈ 计算两个样本在高维空间相似性的工具
它们在数学形式上都源自于 核方法(kernel methods):
- 都是通过某种函数,把数据从原始空间“转换”或“平滑”处理
- 在数学泛函分析中,“核”是一类函数算子的名称,这也是名字来源
| 说法 | 适用场景 | 解释 |
|---|---|---|
| 类似直方图的频率图 | GSVA 的核函数 | 表达量经过核函数平滑 → 得到每个基因集在样本中的富集度曲线(像密度图) |
| 低维映射到高维 | SVM 的核函数 | 用核技巧隐式地将样本映射到高维空间进行分类 |
🧠 1. 核函数到底在做什么?
核函数本质是用一个非线性映射 将原始的低维输入 映射到一个(可能是无限维)高维空间 :
但我们不需要真的构造这个高维空间,因为核技巧允许我们只计算内积:
这就是“核技巧”的核心:不用显式造高维特征,也能做高维的事情。
为什么不需要显式映射?
因为SVM的优化目标(如最大化间隔)和决策函数最终仅依赖内积,而非单独的 。
例如,SVM的决策函数:
其中 是支持向量的权重,完全通过核函数 计算。
4. 经典核函数的映射方式
| 核函数类型 | 公式 | 隐式映射的高维空间特性 |
|---|---|---|
| 线性核 | 原始空间(无映射) | |
| 多项式核 | 次多项式组合空间 | |
| 高斯核(RBF) | 无限维空间(泰勒展开) | |
| Sigmoid核 | 近似非线性映射空间 |
一、什么叫“偏向多数类”?
SVM 容易偏向多数类
意思是:在训练数据中若某一类别样本数量远多于另一类,SVM 更可能学习一个“对多数类更友好”的分类边界。
SVM 会试图最大化分类间的间隔,但它受到样本数量的影响,可能学出一个分类边界:
- 很好地分类了大多数正常组织
- 但错误分类了一些肿瘤样本(即少数类)
因为模型“看”到的肿瘤样本太少,可能误认为它们是正常的变异样本。
🧬 二、和基因特征选择有什么关系?
在 SVM 中,支持向量的分布和分类边界的形状直接影响:
- 哪些样本被认为重要
- 哪些特征(基因)在 SVM-RFE 中被选为关键
如果模型偏向多数类,可能导致:
- 重要的“肿瘤相关基因”没被识别出来(因为“肿瘤样本”分类效果差)
- 选出来的特征更能区分“正常样本之间的细微差异”,而不是“病理状态之间的真正差异”
✅ 不是 gene 本身被错误分类,而是模型学到的分类标准过度依赖多数类,导致特征选择失真。
💡 三、如何解决类别不平衡问题?
| 方法 | 原理 | R中做法 |
|---|---|---|
| 调整权重 | 增加少数类惩罚权重 | class.weights 参数(e1071::svm()) |
| 过采样(SMOTE) | 复制/合成少数类样本 | DMwR::SMOTE() |
| 欠采样多数类 | 随机丢弃部分多数类样本 | ROSE::ovun.sample() |
| 使用 F1/Recall/ROC-AUC 评估 | 避免只看 accuracy | caret::confusionMatrix(),pROC::roc() |
🧭 一、数据准备阶段
1. 特征缩放(标准化)
- 必须做!
- SVM 对特征尺度非常敏感,尤其在使用 RBF、polynomial 等核函数时。
- 建议使用 Z-score 标准化(
scale()或caret::preProcess())
2. 类别不平衡处理
-
若正负样本比例严重失衡,SVM 容易偏向多数类。
-
可以用:
- 过采样(如 SMOTE)
- 欠采样
class.weight参数(在某些 SVM 实现中支持)
3. 去除冗余/无用特征
- 太多无用变量会影响支持向量选择
- 可先做特征选择(如:差异分析、基于方差、RFE)
⚙️ 二、模型选择和调参
4. 选择合适的核函数(kernel)
linear:特征很多,样本少(如基因数据)RBF(默认):非线性数据,一般推荐polynomial:不常用,容易过拟合sigmoid:类似神经网络,不常用
5. 调参:C 和 gamma(非线性核)
C控制误差惩罚(大 → 低偏差,高方差)gamma控制 RBF 核的影响范围(大 → 高复杂度,易过拟合)
使用交叉验证(如 grid search 或随机搜索)寻找最优参数组合。
# 用 e1071 包调参示例
tune(svm, train.x, train.y, kernel="radial",
     ranges=list(cost=10^(-1:2), gamma=c(0.1, 0.01, 0.001)))
📈 三、训练与评估
6. 交叉验证(CV)
- 使用 k-fold CV 或留一法(尤其样本量小时)
- 避免 train/test 信息泄露(特别在基因数据分析中)
7. 评估指标
-
不要只看 accuracy!
-
特别关注:
- Precision / Recall / F1-score
- ROC-AUC
- Confusion matrix
8. 支持向量不是特征,是样本
- SVM 的支持向量是靠近边界的训练样本,不是变量
- 这些样本对模型边界影响最大
9. 权重 与特征的重要性
- 对于线性核,可以通过 的大小评估特征重要性
- 可用作特征选择依据(如 SVM-RFE)
🧬 五、SVM 在生物信息学中的注意点
10. 高维低样本(HDLSS)
- SVM 非常适合这种情况(如 10000 个基因,100 个样本)
- 但也容易过拟合 → 要结合特征选择或正则化处理
11. 特征选择(RFE)
- 常用 SVM-RFE 筛选关键基因
- 配合交叉验证使用,避免数据泄露
⚠️ 六、SVM 的局限性
- 对大数据(样本多)扩展性差(训练慢)
- 不适合离散型特征太多的数据
- 对缺失值敏感(需预处理)
1. 数据标准化
2. 处理类别不平衡
3. 特征选择(如差异分析)
4. 选择合适核函数(linear 或 RBF)
5. 调参(C 和 gamma)
6. 使用交叉验证评估性能
7. 理解支持向量(是样本)
8. 结果可视化与解释(如 ROC 曲线)
非常好的问题!你提到了 SVM-RFE(支持向量机递归特征消除)为什么需要做 RFE,以及它是否类似 lm 中的 stepAIC、怎么判断最优特征子集、如何避免过拟合 —— 这些正是做特征选择时最关键的思考点。
🧠 一、为什么需要 RFE?
不是 SVM 模型本身不能处理很多特征,而是:
高维特征(如基因表达)中,大部分特征是冗余或噪声,会干扰分类器性能。
- RFE 是在 SVM 的基础上,通过逐步删除“最不重要的特征”,找到对模型性能最关键的子集。
- 它和
stepAIC(基于信息准则)类似,但用的是模型性能(如交叉验证准确率)来评估每轮特征集的优劣。
🔄 二、SVM-RFE 是怎么做的?
SVM-RFE 的标准流程:
- 🧠 初始训练: 用所有特征训练 SVM。
- 📉 计算权重: 对于线性核 SVM,计算每个特征的权重 ,用 表示特征重要性。
- ❌ 消除特征: 去掉重要性最小的一部分(1个或几个)。
- 🔁 重复训练: 在剩下特征上重新训练 SVM。
- 🏆 记录性能: 每一步保留交叉验证结果(准确率、AUC等)。
- 📌 选择最佳特征集: 找到使性能最优的特征子集。
✅ 三、SVM-RFE 如何判断最优?
和 stepAIC 选最小 AIC 类似,SVM-RFE 通常:
- 使用 交叉验证准确率 / ROC-AUC / F1 score 对每一步进行评估;
- 选择性能最优对应的特征子集;
- 通常用 外部验证集 进一步验证选中的特征是否泛化良好。
🚨 四、SVM-RFE 如何避免过拟合?
RFE 过程中的过拟合风险是真实存在的,尤其在小样本 + 高维度场景。以下是防止过拟合的关键策略:
| 方法 | 说明 |
|---|---|
| ✅ 使用嵌套交叉验证(Nested CV) | 外层划分验证集,内层做 RFE,防止信息泄漏 |
| ✅ 限制模型复杂度(如线性核) | 非线性核(如 RBF)可能导致在训练集中拟合过度 |
| ✅ 正则化 SVM(C 参数)调优 | 小 C 有助于提高泛化性 |
| ✅ 评估稳定性(稳定特征排名) | 多次运行 RFE,检验前 N 个基因是否稳定出现 |
| ✅ 加入生物背景知识筛选预特征 | 如先筛选差异表达基因,再做 RFE,避免噪音干扰 |
🔬 举例:基因表达数据上 SVM-RFE 的简化流程(R语言思路)
library(e1071)
library(caret)
library(mlbench)
library(caretFuncs)  # 自定义RFE函数

# 假设已有表达矩阵 expr_matrix 和分类标签 label

# 自定义SVM训练函数
svmFuncs$fit <- function(x, y, first, last, ...) {
  e1071::svm(x, y, kernel = "linear", cost = 1, scale = FALSE, ...)
}

# 使用rfe
rfe_control <- rfeControl(functions = svmFuncs, method = "cv", number = 10)

set.seed(123)
results <- rfe(x = expr_matrix, y = label, sizes = c(5, 10, 20, 30),
               rfeControl = rfe_control)

# 查看最优特征数
results$optVariables
plot(results)| 问题 | 解答 |
|---|---|
| 为什么要 RFE? | 因为基因数据高维低样本,噪声多,SVM 性能受影响 |
| 和 stepAIC 像吗? | 类似——都是逐步删减特征、用某种标准(准确率或 AIC)选最优子集 |
| 怎么评估最优? | 用交叉验证评估每一步性能,选出最佳子集 |
| 怎么防止过拟合? | 使用嵌套交叉验证、线性核、正则化参数调优、评估特征稳定性 |
| !你抓住了 三种机器学习方法(Lasso回归、SVM、随机森林)在建模和分类机制上的核心区别,下面我帮你一一解释清楚它们是如何从特征(如基因表达量)“过渡”到分类结果的。 |
我们想用基因表达量 来分类样本属于哪一类(如癌症 vs 正常)
① Lasso 回归:逻辑回归 + L1 正则化
-
🎯 目标:拟合
-
Lasso 是 逻辑回归的变种,引入 L1正则 来让不重要的系数 收缩为 0,从而达到特征选择效果。
-
拟合后,对于新样本 ,计算:
-
如果 ,分类为 1,否则为 0(阈值可调)。
-
🎯 目标:找到最优超平面 将两类数据分开:
如果 则分类为 +1;否则为 -1。
-
通过最大化类别间距(margin)来提升泛化能力。
✅ 分类怎么做?
- 对新样本 ,计算 。
- 看其在超平面哪一侧:正侧是正类,负侧是负类。
| 方法 | 分类方式 | 表达量的作用 | 特征选择能力 |
|---|---|---|---|
| Lasso | 根据逻辑回归概率是否大于0.5 | 每个基因有 ,影响分类概率 | ✅强,L1正则自动选变量 |
| SVM | 根据 正负 | 表达量乘以 ,影响样本在哪边 | ⚠️中等,可配合 RFE 做特征选择 |
| 随机森林 | 多棵树投票 | 表达量决定是否满足分裂条件 | ✅强,能衡量每个特征的重要性 |
🧠 哪种更适合基因表达数据?
| 数据特点 | 推荐方法 |
|---|---|
| 特征数远大于样本数(高维) | Lasso / SVM(需做特征筛选) |
| 数据非线性、含交互 | 随机森林(天然支持非线性) |
| 想明确知道哪些基因重要 | Lasso / RF 都可以 |
| 想建模型 + 变量筛选同时做 | Lasso 回归 / SVM-RFE |
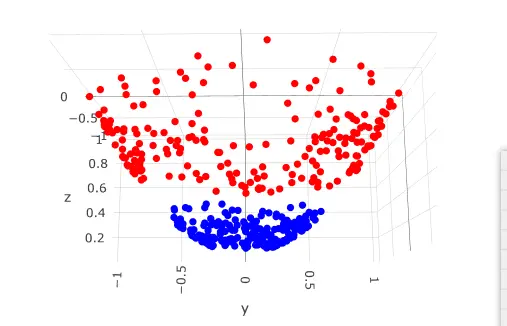
library(ggplot2)
library(plotly)

set.seed(42)

# 生成内圈数据
n <- 200
r1 <- runif(n, 0.2, 0.5)
theta1 <- runif(n, 0, 2*pi)
x1 <- r1 * cos(theta1)
y1 <- r1 * sin(theta1)
z1 <- x1^2 + y1^2

# 生成外圈数据
r2 <- runif(n, 0.7, 1.0)
theta2 <- runif(n, 0, 2*pi)
x2 <- r2 * cos(theta2)
y2 <- r2 * sin(theta2)
z2 <- x2^2 + y2^2

# 合并数据
df <- data.frame(
    x = c(x1, x2),
    y = c(y1, y2),
    z = c(z1, z2),
    class = factor(c(rep("inner", n), rep("outer", n)))
)

# 原始二维空间图
p1 <- ggplot(df, aes(x = x, y = y, color = class)) +
    geom_point(size = 1.5) +
    ggtitle("原始空间:环形不可线性分割") +
    theme_minimal()

print(p1)


# 三维交互式图
p2 <- plot_ly(df, x = ~x, y = ~y, z = ~z, color = ~class,
              colors = c("blue", "red"),
              type = "scatter3d", mode = "markers",
              marker = list(size = 2)) %>%
    layout(title = "映射后空间(z = x² + y²)可线性分割")

p2