logistic回归
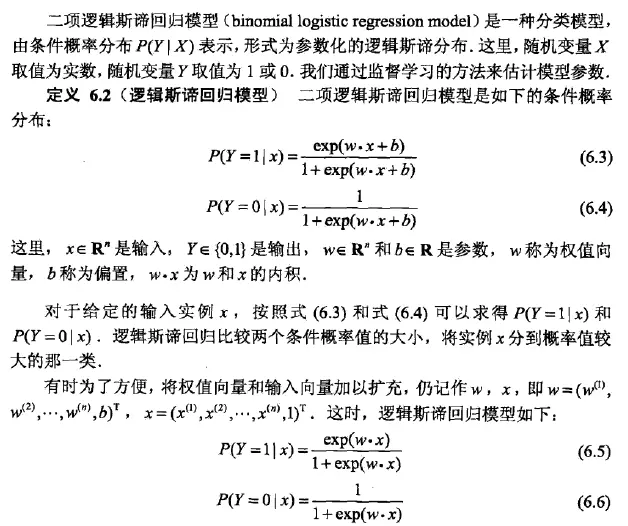
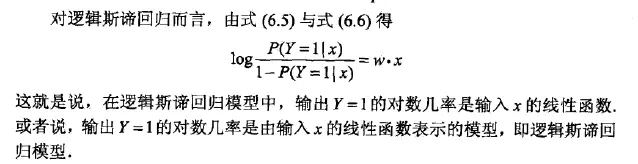
当因变量为二分类或多分类时 由于Logistics回归对资料的正态性和方差齐性不做要求、对自变量类型也不做要求,
关键点:
- 变换函数变化后得到一个值处于0-1之间
Q AA逻辑回归和神经网络中的sigmoid函数有什么不同?
Q:如何通过sigmoid函数得到形如 wx+b的线性表达公式的?
- 首先写出Y=1|X 和Y=0|X的sigmoid的表达公式,这个可以让转为0-1的概率
log (P(Y=1|X)/(1-P(Y=1|X) 得到了线性公式其中1-P(Y=1|X) 在二分类的时候等于P(Y=0|X)
解决wx+b可能处于正负无穷,但是概率处于0-1之间,需要把最后的值也变为无穷
是一个概率
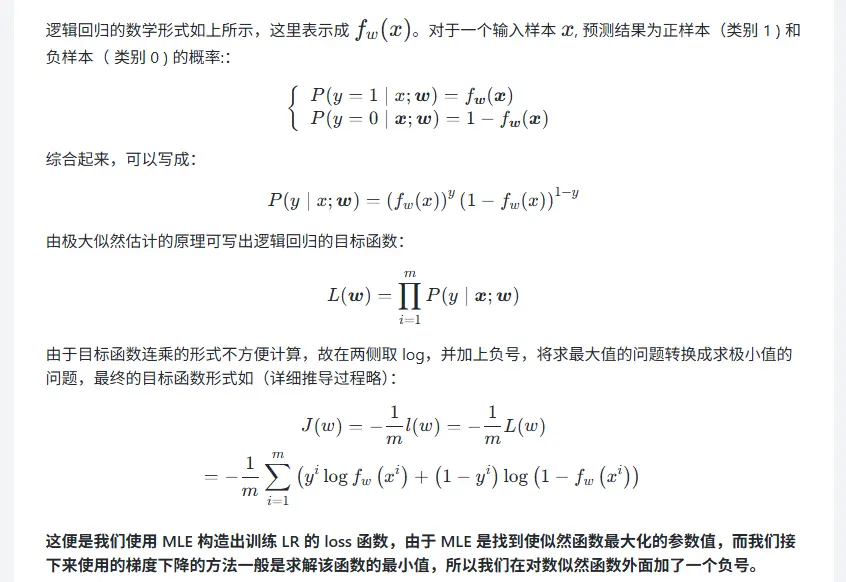
那算法是怎么从一堆 和 中,把回归系数 算出来,进而得到概率的呢?它用到的核心方法叫做 极大似然估计 (Maximum Likelihood Estimation, MLE)。
第一步:反向求解,让模型能吐出概率
既然我们建立了公式:
我们可以把左边的 解包反算出来(这一步叫 Sigmoid 函数):
这个公式的意思是:只要你给我一组猜想的 和样本的 ,我就能算出这个样本 的概率 。
第二步:建立一个“连连看”的评分机制(似然函数)
现在,假设我们手头有一组盲猜的系数,比如 。我们把观察值 代入上面的公式,去和真实的 对比:
-
样本 1:真实 。模型代入 后,算出概率 。
-
评价:猜得挺准!既然真实是 1,那发生的概率是 0.9,这个样本的“合理得分”就是 。
-
样本 2:真实 。模型代入 后,算出概率 。
-
评价:猜得太离谱了!真实是 0,你居然说有 80% 的概率发生?那它“不发生”的概率只有 。这个样本的“合理得分”就是 。
把所有样本的“合理得分”全部乘起来,得到的总分就叫似然度 (Likelihood)。用数学公式表达就是:
我们的终极目标:找到一组最完美的 ,让这个总分(似然度)达到最大。这就意味着这组系数最符合我们看到的观察值。
第三步:计算机是如何“收敛”并找到答案的
因为连乘在数学上很难算,计算机处理时会做两件事:
- 取对数 (Log):把令人头疼的“连乘”变成“连加”,这就变成了 对数似然函数 (Log-Likelihood)。
- 加负号:因为计算机算法通常喜欢“寻找最小值”(比如损失函数的最小值),所以加个负号,就变成了大名鼎鼎的 二元交叉熵损失 (Binary Cross-Entropy Loss)。
由于逻辑回归的这个损失函数是一个非常完美的凸函数(像一个大碗,只有一个最低点,没有乱七八糟的局部陷阱),计算机通常使用梯度下降法 (Gradient Descent) 或 牛顿法 (Newton-Raphson):
- 初始盲猜:随机给 一个初始值(比如全设为 0)。
- 计算梯度:看一眼在这个 下,总分离最高点(或者损失离最低点)还有多远,往哪个方向走能让分数变高。
- 更新微调:顺着正确的方向把 往前挪一点点。
- 不断迭代:重复这个过程,直到 的变化非常小,再怎么调整分数都不会变高了。
这时候,计算机就宣布“模型收敛了”。打印出来的 就是最终的参数。
简单串一遍整个流水线
- 你输入数据 ,其中 全是 和 。
- 算法在后台启动,先随便瞎猜一个 。
- 用 Link Function 的反函数 (Sigmoid) 把每个 算出一个概率 。
- 用这些 去对照真实的 计算总评分(似然度)。
- 根据评分的反馈,使用梯度下降法调整 ,直到评分升到最高,锁定最终的 。
这就是从观察值 出发,利用 Link Function 建立的桥梁,最终在后台把参数训练出来的全过程。
这个翻译官的工作是:把 之间的概率,映射(拉伸)到 的整个宇宙中去。
这个翻译官就是 Logit 函数。
第一步:从“概率”变成“几率” (Odds)
我们不直接预测概率 ,我们先看发生与不发生的比率:
- 如果概率 ,Odds =
- 如果概率 接近 (比如 ),Odds 就会变成正无穷 ()
- 如果概率 接近 (比如 ),Odds 就会接近 ()
你看,通过这一步,我们把原本 的范围,拉伸到了 。但还不够,负数部分还没填满。
**Logit 函数详解
Logit 函数 是 Logistic 回归 和 概率建模 中的核心函数,用于将概率值 (取值范围 )映射到实数范围 。
给定概率 ,Logit 函数定义为:
- 称为 几率(Odds),表示事件发生的概率与不发生的概率之比。
3. 反函数:Logistic(Sigmoid)函数
Logit 的反函数是 Logistic 函数(Sigmoid 函数):
它可以将任意实数 映射回概率 。
4. 应用
- Logistic 回归:用于建模二分类问题,其中 logit 作为线性预测器的链接函数:
- 概率转换:在统计学中,logit 变换用于处理受限变量(如概率),使其适用于线性模型。
- 医学/社会科学:用于分析事件发生的相对概率(Odds Ratio)。
5. 示例计算
- 若 ,则:
- 若 ,则:
. logistic回归适用于二值响应变量,连接函数为logit函数,概率分布为二项分布,通过**最大似然估计求**解常数项和偏回归系数,基本思想时当从总体中随机抽取n个样本后,最合理的参数估计量应该使得这n个样本观测值的概率最大。最大似然法的基本思想是先建立似然函数与对数似然函数,再通过使对数似然函数最大求解相应的参数值,所得到的估计值称为参数的最大似然估计值。
Site Unreachable
X值带入函数 进行连乘,使得最后的P最大
link函数的意义是什么?
回归 glm
glm(Y ~ X1 + X2 + X3, family=binomial(link="logit"), data=data)
Logistic Regression | Yonji’s Blog
基本步骤
- 选择数据建立模型
- 确定模型系数(损失函数最小)
- 全模型
- 部分模型 回归
- 选择模型选择模型标准 AIC准则
- 优化
- 预测数据
- 检查模型是否准确
- 过度离势过度离势指的是观测到的响应变量方差大于期望的二项分布方差,过度离势会导致奇异的标准误检验和不精确的显著性检验。当出现过度离势时,仍可使用glm()函数拟合Logistic回归,但此时需要将二项分布改为类二项分布。
检测过度离势的一种方法是比较二项分布模型的残差偏差与残差自由度(在四变量模型中分别是615.36和596),如果两者的比值比1大很多,则可以认为存在过度离势。
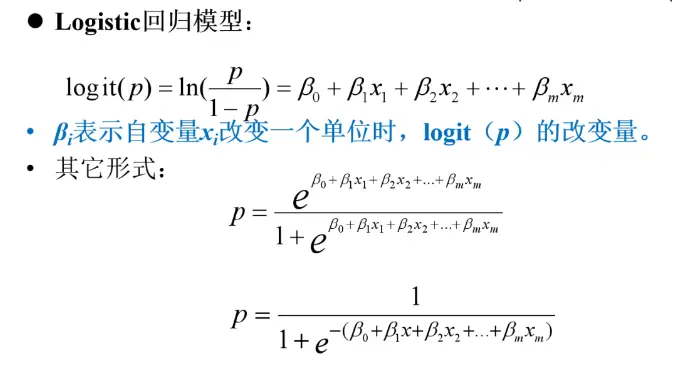
Logistic回归的Y是P1/P0的自然对数
logit(P)=log(Odds(Y=1)=ln(P/1-P)=自变量 可以直接回归得到logit(P),这个整体值是说 每增加一个单位的X,增加的对数几率的变化量。 然后再推出P,也就是事件发生的可能性
一般来说,进行logistic回归分析的样本量不应该低于100,并且随着变量的增加,样本量也需要相应增加。
-
二元Logit(Logistic)回归
-
多分类Logit(Logistic)回归
-
有序Logit(Logistic)回归。
-
Y值的选项有多个,并且选项之间没有大小对比关系,则可以使用多元Logistic回归分析。
-
Y值的选项有多个,并且选项之间可以对比大小关系,选项具有对比意义,应该使用多元有序Logistic回归分析。
-
扩展的Logistic回归和变种如下所示:
-
稳健Logistic回归:当拟合Logistic回归模型数据出现离群点和强影响点时,robust包中的glmRob()函数可用来拟合稳健的广义线性模型
-
多项分布回归:当响应变量包含两个以上的无序类别(例如已婚、寡居、离婚)时,可使用mlogit包中的mlogit()函数拟合多项Logistic回归
-
序数Logistic回归:当响应变量是一组有序的类别(例如信用为好/良/差)时,可使用rms包中的lrm()函数拟合序数Logistic回归。
-
1. 设置因子水平,默认使用因子水平第2个作为建模的概率
	1. 逻辑回归先计算回归值(线性预测器) 这是相同的
	2. 然后再根据响应变量的因子水平去解释 logit 是哪一类的对数优势比(log-odds)
# 逻辑回归
mydata$type[which(mydata$Species== "virginica")] <- 0 # virginica编号为0
mydata$type[which(mydata$Species== "versicolor")] <- 1 # versicolor编号为1
attach(mydata) # 固定数据集
fit <-glm(type~Sepal.Length+Sepal.Width+Petal.Length+Petal.Width,data=mydata,family=binomial())# 指定分布为二项分布
summary(fit) # 输出拟合结果
confint(fit) # 输出95%置信区间
exp(coef(fit)) # 取拟合系数的自然指数
exp(confint(fit)) # 取95%置信区间的自然指数
predict(fit, type="response") # 输出拟合值
residuals(fit, type="deviance") # 输出残差
1. 自变量独立:IBM来自于体重和身高的计算,所以IBM不能包含在里面
2. 最小样本量, 最终回归模型中自变量个数的10倍
3. 自变量无多重相关性,VIF检验否则lasso回归执行
4. 无极端值
5. 是否需要转化为分类变量 需要看Box-Tdell的检验你说的应该是 Box–Tidwell 检验(有时被误写成 Box–Tdell),它确实和连续变量是否需要转化(例如取对数、幂变换)有关,不过它不是用来把连续变量转成分类变量的,而是用来检验 连续自变量和因变量的关系是否是线性的(在线性回归的对数几率或普通线性模型中)。
我给你从统计原理上解释一下:
1. 背景问题
- 在线性回归(或广义线性模型)里,有一个核心假设:
每个连续自变量 与因变量 之间的关系是线性的(在 GLM 里是和线性预测子 线性的)。 - 如果这个假设不成立(比如关系是曲线的),模型就会偏倚,预测效果差,显著性检验也会失效。
- Box–Tidwell 检验就是专门用来检查是否需要对连续变量进行幂变换,以改善线性关系。
2. 统计原理
Box–Tidwell 的想法:
-
原本模型假设:
-
他们提出一个更一般的模型:
其中 是指数(幂次)。
-
如果 ,就说明原本的线性假设成立;如果显著偏离 1,就说明需要做幂变换,比如:
- → 取平方根变换可能更合适
- → 对数变换更合适
-
在回归实现上,Box–Tidwell 用的是一种可估计 的方法,并用假设检验来判断:
- :(线性成立)
- :(线性不成立)
3. 和“转化为分类变量”的关系
-
Box–Tidwell 检验不是用来判断一个连续变量要不要转成分类变量。
-
它判断的是是否需要对连续变量做非线性变换(log、平方根、平方等)以满足回归的线性假设。
-
如果检验结果表明非线性很强,你有几种选择:
- 对变量做适当的幂变换(Box–Tidwell 给出变换建议)
- 用分段回归、样条函数等处理非线性
- 在极端情况下,转为分组变量(分类)处理,但这会丢失信息,所以不是首选。
4. 一个例子
假设你做逻辑回归:
library(car)
fit <- glm(y ~ x1 + x2, family = binomial, data = df)

# Box-Tidwell 检验
boxTidwell(y ~ x1 + x2, ~ x1 + x2, data = df)
输出的每个变量都会有一个估计的 和对应的 p 值:
- p 值大 → 没有证据拒绝线性假设(不需要变换)
- p 值小 → 线性假设不成立,考虑变换
5. 总结
-
Box–Tidwell 检验:检验连续自变量是否与因变量存在线性关系
-
结论:
- p 值大 → 保持原变量
- p 值小 → 考虑幂变换(不是直接转成分类变量)
-
把连续变量转成分类变量更多是出于解释方便或模型策略,而不是 Box–Tidwell 的结论。
如果你愿意,我可以画一个 变量与响应变量关系的可视化图,展示 Box–Tidwell 检测出非线性时,变换前后曲线的变化,这样更直观。
你需要我画吗?
可视化变量相关性
library(corrplot)
data(swiss)
corr<-cor(swiss)
corrplot(corr)

lm(formula = Fertility ~ ., data = swiss)

Residuals:
     Min       1Q   Median       3Q      Max
-15.2743  -5.2617   0.5032   4.1198  15.3213

Coefficients:
                 Estimate Std. Error t value Pr(>|t|)
(Intercept)      66.91518   10.70604   6.250 1.91e-07 ***
Agriculture      -0.17211    0.07030  -2.448  0.01873 *
Examination      -0.25801    0.25388  -1.016  0.31546
Education        -0.87094    0.18303  -4.758 2.43e-05 ***
Catholic          0.10412    0.03526   2.953  0.00519 **
Infant.Mortality  1.07705    0.38172   2.822  0.00734 **
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 7.165 on 41 degrees of freedom
Multiple R-squared:  0.7067,	Adjusted R-squared:  0.671
F-statistic: 19.76 on 5 and 41 DF,  p-value: 5.594e-10
需要注意的是,逐步回归法是基于AIC值最小的选择变量,可能出现挑选变量的参数估计不通过显著性检验的情况,此需要利用函数dropI()进行后线处理,具体操作如下:
 lm5<-lm(Fertility~.,data=swiss)
 lm6<-step(lm5)

 #上述输出结果展示了剔除每一个解释变量所对应的AIC值,逐步回归算法选择剔除使AlC值最小的变量,即Examination,
 若剩余变量的参数估计还是不能通过显著性检验,就根据上述输出结果,选择人为剔除变量Examination外使AIC值最小的变量Agriculture,即利用根据逐步回归选择的变量,然后人为剔除其中的Agriculture,再次进行回归分析。一般来说,此步骤能满足所有参数估计均通过显著性检验:若还是存在参数估计没有通过检验的情况,则需要考虑原始数据可能不适用于线性模型。
 lm_other=drop1(lm5)
广义线性模型:
结果变量为计数型的(一周交通事故的数目、每日酒水消耗的数量),这类变量都是非负的有限值,它们的均值和方差通常都是相关的(而正态分布变量间则是相互独立,改均值不影响方差)。
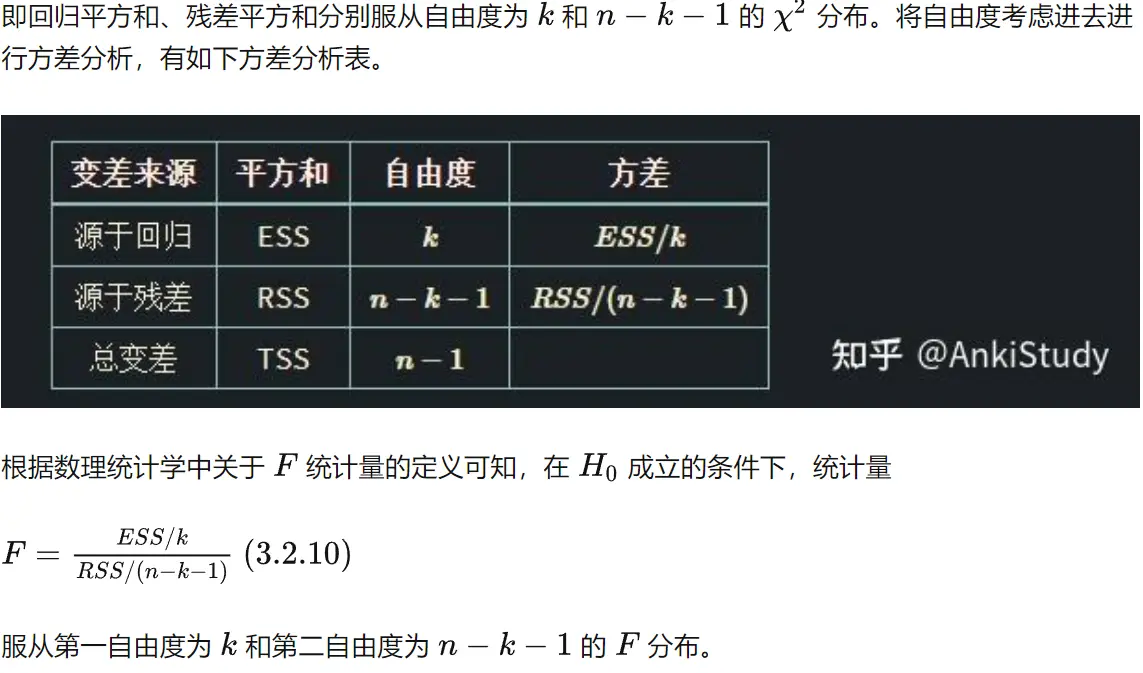
F检验:检验回归模型的总体显著性检验,就是检验全部解释变量对被解释变量的共同影响是否显著
使用的卡方分布进行检验
0假设全为系数0
逻辑回归
#知识点2 predict输出的是一个向量也就是预测值
#知识点3 summary函数
#知识点5 过程 1 看变量相关性 2拟合 3看拟合结果 4剔除变量  5预测
Y值 0,1 变量
library (ISLR)

train =(Smarket$Year <2005) ##设定数据分割标准
glm.fits1 = glm(Direction ~ Lag1+Lag2+Lag3+Lag4+Lag5+Volume, data=Smarket, family =binomial ,subset =train)##使用2001-2004的数据建模

Smarket.2005 = Smarket[! train ,]##提取2005年的数据
glm.probs1 = predict(glm.fits1, Smarket.2005, type="response")##通过2001-2004的数据模型,预测2005年的股市涨跌

Direction.2005 = Smarket$Direction [! train]##2005年每天的实际涨跌情况

##实际值
glm.pred1=rep("Down" ,252)
glm.pred1[glm.probs1>0.5]="Up"##涨跌预测结果
glm.pred1 = as.factor(glm.pred1)

table(glm.pred1, Direction.2005)###实际情况与预测情况对比
mean(glm.pred1 == Direction.2005)###预测正确的概率
mean(glm.pred1 != Direction.2005)###预测错误的概率


###查看预测的模型
summary(glm.fits1)
summary(glm.fits1)$coef

###查看变量之间的相关性
cor(Smarket[,-9])

glm.fits2 = glm(Direction ~ Lag1+Lag2, data=Smarket,
                family =binomial ,subset =train)#
summary(glm.fits2)
比较全模型和较少的模型差异
anova(myfit,myfit_reduced,test="Chisq")
testd ata$prob <- predict(myfit_reduced, newdata=testdata, type="response")注意内容
- 连续变量编码为类别变量 否则结果错误