- Lasso 方法 正则项什么意思
lasso的惩罚项可能会使得某些系数估计偏离了其真实值,从而引入了偏倚。
Lasso方法中的正则项是指在线性回归模型中添加的惩罚项,用于控制模型的复杂度并促使系数向零稀疏化,以达到特征选择的目的
-
Lasso 方法 相比于线性回归的优点
-
特征选择: Lasso方法通过正则化惩罚,倾向于将一些特征的系数稀疏化为零,从而实现特征选择。这意味着Lasso能够自动识别并排除对模型预测贡献较小的特征。
-
**防止过拟合:Lasso方法的正则化有助于提高模型的泛化能力,使其对新数据的预测更准确。
-
处理多重共线性: Lasso方法对处理多重共线性(即特征之间存在高度相关性)有一定的优势。它倾向于选择其中一个相关特征,并将其他高度相关的特征系数稀疏化为零,从而减少了特征间的冗余信息,提高了模型的稳定性。
-
-
ridge regression 和Lasso 方法区别
Ridge回归和Lasso方法都是用于线性回归的正则化技术,它们有几个重要的区别:
-
正则化项:
- Ridge回归使用L2正则化项,即系数的平方和的乘以一个常数(λ)作为惩罚项。
- Lasso方法使用L1正则化项,即系数的绝对值之和乘以一个常数(λ)作为惩罚项。
-
特征选择:
- Ridge回归倾向于缩小系数的大小但不会将系数压缩到零,它减少了系数的幅度但保留了所有特征。
- Lasso方法的特点是能够将一些系数稀疏化为零,从而实现特征选择,将某些不重要的特征的系数置为零,从而达到降维和简化模型的目的。
-
解决多重共线性:
- Ridge回归对多重共线性有所帮助,它可以缩小相关特征的系数,减少它们之间的相互影响,但并不会将系数压缩至零。
- Lasso方法对处理多重共线性也有效,因为它可以倾向于选择其中一个相关特征,并将其他相关特征的系数压缩至零,从而达到降维和简化模型的效果。
-
平滑性:
- Ridge回归的系数收敛到零的速度比Lasso慢,因此Ridge更倾向于保留所有特征,但是通过减小系数的大小来控制它们的影响。
- Lasso方法更倾向于创建稀疏模型,即使在相对较小的惩罚项下,也能将某些系数压缩至零。
选择Ridge回归还是Lasso方法通常取决于数据集的特征性质以及对模型的期望,如果希望保留大部分特征并且对多重共线性有所控制,可以选择Ridge回归;如果希望在模型中实现特征选择,减少特征数量并且更加简化模型,可以考虑使用Lasso方法。
-
在Logistic回归为什么不使用卡方或者F检验
-
卡方检验的问题: 卡方检验通常用于检验分类变量之间的关联性。在Logistic回归中,虽然因变量是一个二分类变量(例如,是/否),但主要关注的是自变量与因变量之间的关系,而不是类别之间的关联。因此,卡方检验并不直接适用于Logistic回归中的系数显著性检验。
-
F检验的问题: F检验通常用于线性回归模型中检验多个系数的同时显著性。在Logistic回归中,因为模型是基于对数几率的,不是线性关系,所以F检验对Logistic回归模型整体的显著性测试也不太合适。
在Logistic回归中,更常用的是Wald检验、似然比检验或Z检验来评估系数的显著性。Wald检验通过系数估计的标准误差来检验系数与零之间的差异,似然比检验则通过比较两个模型(包括一个特征和不包括该特征)的拟合优度来评估特定特征对模型的影响.
| 参数 | 说明 |
|---|---|
| x | 输入特征矩阵,维度为 nobs × nvars(观测数 × 变量数)。可以是稀疏矩阵(如 Matrix 包的 sparseMatrix)。要求 nvars > 1。 |
| y | 响应变量,取决于模型类型: - gaussian: 数值型(回归)- poisson: 非负整数计数- binomial: 两类分类(因子或 2 列计数矩阵)- multinomial: 多分类(因子或矩阵)- cox: 存活分析数据(推荐使用 survival 包的 Surv 对象)- mgaussian: 多响应变量的回归(y 是一个矩阵) |
模型参数
offset:类似cox回归中的baseline风险
alpha:对于L1 正则化的惩罚的系数
nlambda:自动寻找最合适的选项
| 参数 | 说明 |
|---|---|
| family | 模型类型:"gaussian"、"binomial"、"poisson"、"multinomial"、"cox"、"mgaussian"。也可以传 glm() 的 family 对象。 |
| weights | 每个观测的权重。用于加权最小二乘/对数似然。默认为 1。 |
| offset | 线性预测器的偏移项,长度为 nobs,用于 poisson 模型(如 log(曝光时间))等。 |
| alpha | 弹性网络的混合参数,范围 [0,1]:- alpha=1: Lasso- alpha=0: Ridge- 介于两者之间:Elastic Net。 |
| nlambda | lambda 值的个数(模型路径长度),默认 100。 |
| lambda.min.ratio | 最小 lambda 是最大 lambda 的多少倍。默认值根据样本量而变: - nobs > nvars: 0.0001- nobs < nvars: 0.01 |
| lambda | 手动提供 lambda 序列。如果提供,则覆盖 nlambda 和 lambda.min.ratio。建议不要只提供一个值,否则无法发挥 warm start 的优势。 |
| standardize | 是否在模型拟合前对 x 做标准化(均值为 0,方差为 1)。默认 TRUE。返回的系数会被还原到原始单位。 |
| standardize.response | (只用于 mgaussian)是否对响应变量也标准化。 |
⚙️ 拟合控制参数
| 参数 | 说明 |
|---|---|
| intercept | 是否包含截距项,默认 TRUE。 |
| thresh | 协调下降算法的收敛阈值。默认 1e-7。 |
| maxit | 每个 lambda 路径的最大迭代次数,默认 1e5。 |
| type.gaussian | 仅对 gaussian 模型有效:- "covariance"(默认,快,但内存占用高)- "naive"(适用于变量多于观测数的情况) |
| type.logistic | binomial 模型使用的海森矩阵类型:- "Newton"(默认,精确)- "modified.Newton"(速度快,但近似) |
| trace.it | 是否输出进度条,值为 1 时显示。适用于大模型。 |
dfmax的使用:
- 当你希望最终模型简洁,比如只要前20个最重要的变量
- 用于控制模型的可解释性
pmax的使用:
- 当变量数量非常大(比如基因数据有几万个变量)时
- 为了提高计算效率,避免算法考虑太多变量
- 通常设置为比总变量数小但比预期重要变量数大的值
假设你有1000个变量:
- 设置
pmax=200:算法最多考虑200个变量参与计算 - 设置
dfmax=10:最终模型最多选择10个变量
| 参数 | 说明 |
|---|---|
| dfmax | 限制模型中最多包含的变量数(稀疏控制)。 |
| pmax | 限制整个路径中最多可能出现非零系数的变量数。 |
| exclude | 指定要排除的变量索引;这些变量将不会被模型选择。也可传入函数动态排除。 |
| penalty.factor | 对每个变量分别设置惩罚强度(乘以 lambda)。设为 0 表示不惩罚该变量(强制进入模型)。默认全部为 1。 |
| lower.limits | 每个系数的下限,必须是非正数。可以是单个值或长度为 nvars 的向量。 |
| upper.limits | 每个系数的上限。默认 Inf。 |
🔁 弛豫模型与路径控制(用于 relax.glmnet)
| 参数 | 说明 |
|---|---|
| relax | 是否对每个活动变量集重新拟合非正则化模型。适用于提高精度。 |
| fit | 已拟合的 glmnet 模型,用于 relax.glmnet()。 |
| maxp | 放松模型中允许的最大系数数,默认 n - 3。某些非高斯模型中建议手动设置较小值。 |
| path | 是否对每个放松模型使用原始 lambda 路径再次拟合(TRUE 会显著增加计算时间)。默认 FALSE。 |
| check.args | 在放松模型时是否检查原始拟合使用的所有参数。默认 TRUE。 |
🔄 多类别回归的设置
| 参数 | 说明 |
|---|---|
| type.multinomial | "grouped":对一个变量的所有类别系数一起施加 L1 惩罚;"ungrouped"(默认):每个类别系数独立惩罚。 |
📝 示例:使用 Lasso 拟合二分类逻辑回归模型
library(glmnet)

# 模拟数据
set.seed(123)
x <- matrix(rnorm(100*20), 100, 20)
y <- rbinom(100, 1, 0.5)

# 拟合 Lasso 模型(alpha = 1)
fit <- glmnet(x, y, family = "binomial", alpha = 1)

# 交叉验证选择最优 lambda
cvfit <- cv.glmnet(x, y, family = "binomial", alpha = 1)
best_lambda <- cvfit$lambda.min

# 打印最优模型系数
coef(cvfit, s = "lambda.min")
RSS 残差平方和
MSE 均方误差,是RSS的均值
✅ 方差-偏差平衡(bias-variance tradeoff)是什么?
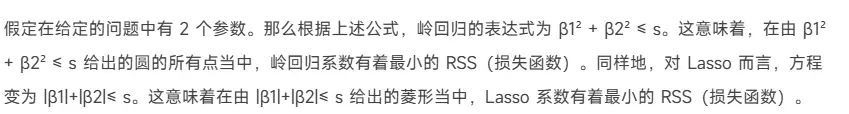
- 偏差 = 模型预测的平均值与真实值的差异(反映模型本身能力不足,欠拟合)
- 方差 = 模型在不同训练集下输出的波动程度(反映模型过于依赖训练数据,过拟合) 训练99个模型 用最后一个去看
所以,偏差是“预测值与真实值之间的平均误差”,
而方差是“不同训练集训练出的模型,对同一个样本预测值之间的波动”。
你无法同时让两个都低 —— 所以我们需要在泛化能力上做权衡:
总误差 = 偏差² + 方差 + 不可约误差(噪声)
我们追求的是 总误差最小,这就需要权衡两者。
✅ 判断你是否掌握“套索回归”的标准
🔹 1. 套索回归优化目标是什么?与岭回归有何不同?
-
✔️ 你能写出其目标函数:
-
✔️ 你能解释为什么 L1 惩罚会导致稀疏(变量选择);
-
✔️ 你知道岭回归用的是 L2 范数,不会导致稀疏(但能防止过拟合)。
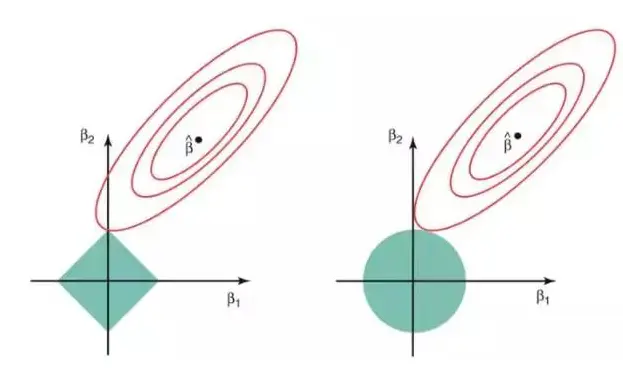
🔹 2. 你能用“图像几何”解释套索回归如何实现变量选择?
- ✔️ 你能解释“等高线 + L1 范数菱形约束区域”;
- ✔️ 你知道“最优解 = 等高线首次触碰约束边界”;
- ✔️ 你理解为什么解容易落在坐标轴上(即某些系数为0)。
🔹 3. 你知道什么时候应该使用 Lasso?
- ✔️ 特征很多,但可能只有少量真正有用(稀疏解很重要);
- ✔️ 你希望自动进行变量筛选;
- ✔️ 特征高度相关时,你知道 Lasso 有可能表现不稳定。
🔹 4. 你知道 Lasso 的局限性吗?
- ❗ 不能很好地处理强相关变量(它会随机选一个保留);
- ❗ 对于高维数据(p >> n),可能选不出对的变量;
- ✅ 你知道 elastic net(L1 + L2 混合)是怎么解决的。
🔹 5. 你能用代码(R 或 Python)实现并解释结果?
- ✔️ 你会用
glmnet(R)或sklearn.linear_model.Lasso(Python); - ✔️ 你能解释交叉验证下
lambda的选择如何影响系数收缩; - ✔️ 你能画出 λ 路径图(lasso path plot)并解读变量消失的过程。
✅ 终极测试问题(回答这些代表你真的懂了)
- 为什么 Lasso 可以做变量选择,而 Ridge 不行?
- 如果两个特征高度相关,Lasso 会怎么处理它们?
- Lasso 的 λ 增大时,系数是如何变化的?
- 你如何在实际建模中选择 λ?用什么评估标准?
- 你何时会选择 elastic net 而不是纯 Lasso?
如果你知道它在做什么(目标函数),怎么做的(几何图),能不能选变量(稀疏),适合什么时候用(适用场景),什么时候不能用(局限性) —— 那你就已经真正掌握了套索回归。
cv.glmnet() 会在一系列 lambda 值上进行 k 折交叉验证,计算每个 lambda 下的 平均验证误差(如 MSE)。然后返回:
cv 代表 Cross-Validation,即交叉验证。
| 项目 | 含义 | 特点 |
|---|---|---|
lambda.min | 最小交叉验证误差 | 预测最准确,模型可能较复杂 |
lambda.1se | 在误差容忍范围内选择的最大 lambda | 模型更简单、更稳健,推荐部署 |
- 做研究、模型解释为主? →
lambda.1se(更稀疏,易解释) :在 lambda.min 的 1 个标准误差(1 Standard Error)范围内,选择最稀疏的 λ(即更大的 λ,更多系数被压缩为零)。 - 追求精度? →
lambda.min(预测能力强) :交叉验证中使平均均方误差(MSE)最小的 λ 值。
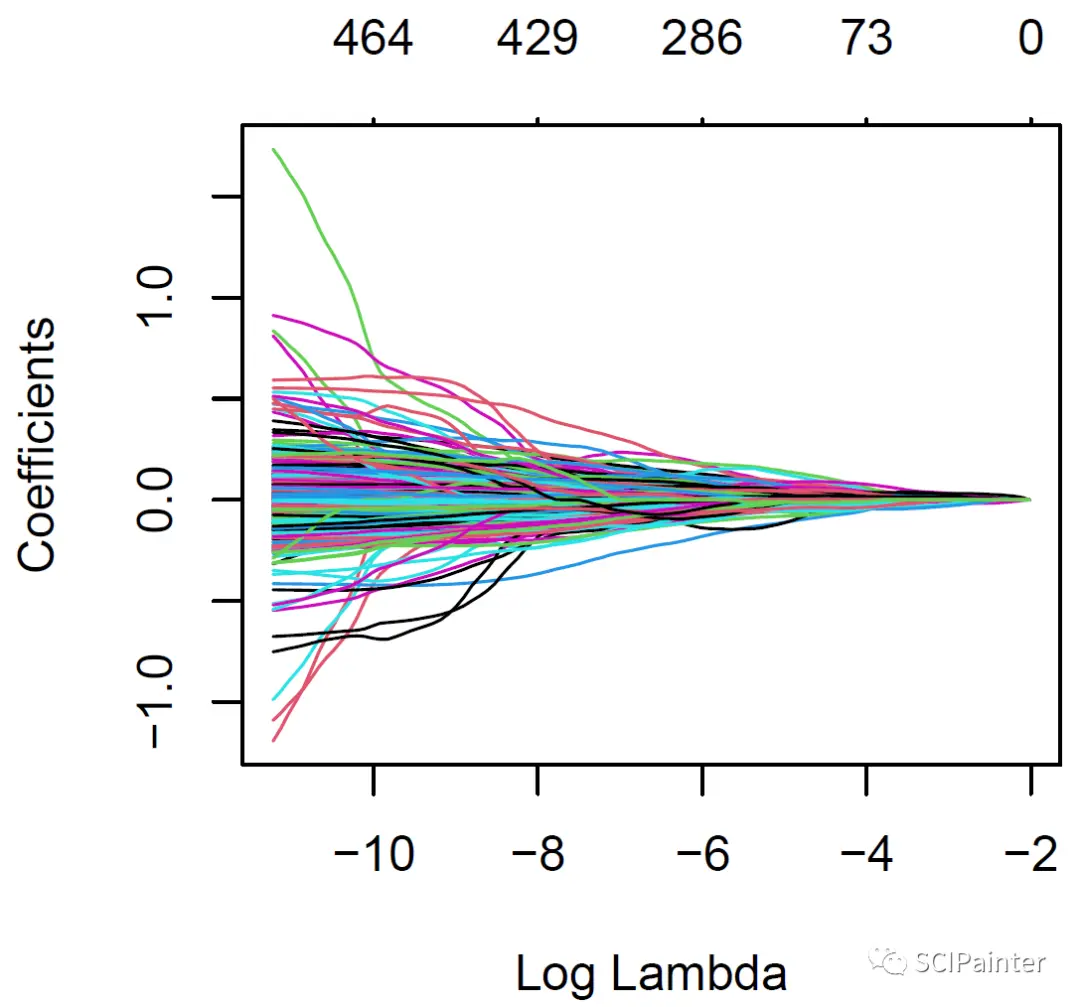
- 下面是lambda的系数
- 上面是随着lamda变为不为0的系数
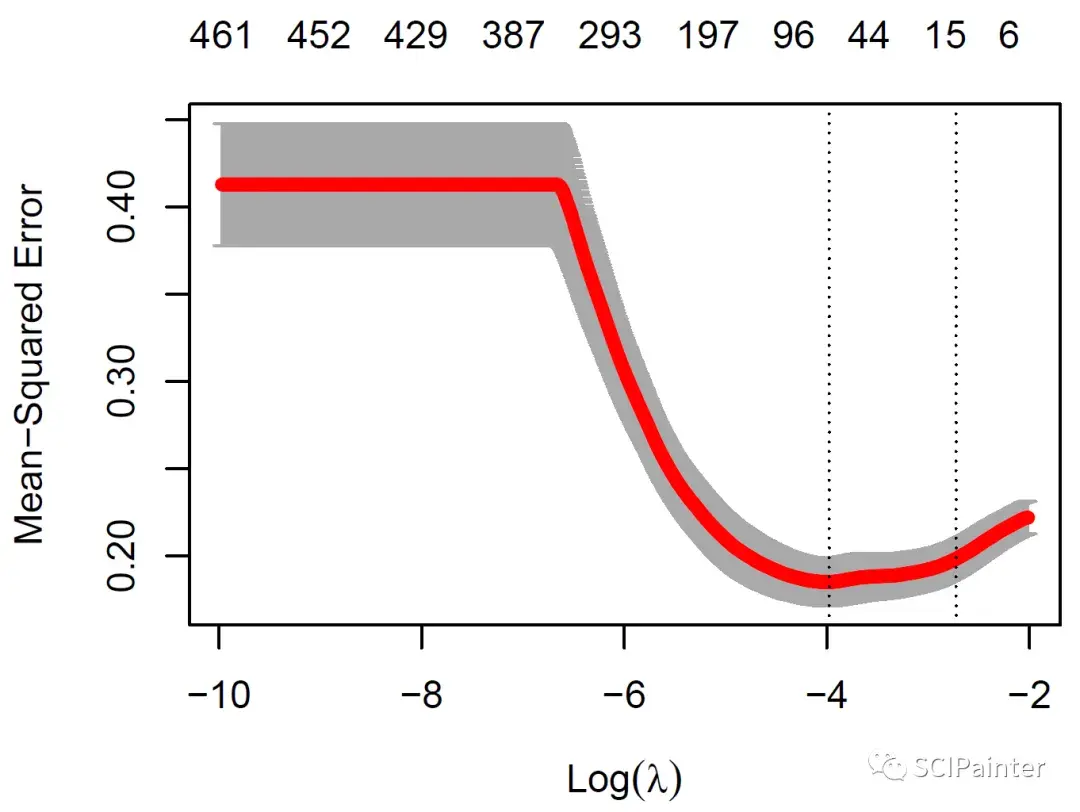
#图中两条虚线为两个特殊λ值,左为lambda.min,右为lambda.1se,一般认为在这两个值之间的λ值都是合适且可挑选的;
#lambda.min:最小目标参量均值,准确度更高;
#lambda.1se:在 lambda.min 一个方差范围内得到最简单模型的λ值,具备优良性能但使用基因数量最少,准确度没有lambda.min高;
#我们可以取两个λ中间的某个值建模,**或者直接使用这两个值构建模型**
必须标准化数据!
因为 Lasso 的惩罚项依赖于系数的大小,而不同变量的量纲不同会严重影响惩罚效果。
cv.glmnet(X, y, alpha = 1, standardize = TRUE)💡 默认 glmnet() 会自动标准化。
2. ⚠️ 对异常值敏感(强影响点)
Lasso 是基于最小二乘的(平方误差),因此对异常值敏感:
-
异常点会极大地影响模型系数选择。
-
对策:
- 预先检测并处理异常值(箱线图、Cook 距离等)
- 或者使用 鲁棒 Lasso 变种(比如 Huberized Lasso)
3. ⚠️ 方差齐性与正态性假设?
Lasso 是一种预测导向模型,不是传统意义上的统计推断工具,因此:
- 不强依赖于误差正态性和方差齐性。
- 但如果你希望进行推断(如置信区间或假设检验),则这些假设依然重要。
👉 如果要做置信区间,可以考虑 Post-Lasso OLS(用 Lasso 选出的变量再跑一次线性回归)。
4. ⚠️ 多重共线性(Multicollinearity)
-
Lasso 会在高度相关变量中只选一个,将其余系数压成零。
-
它确实可以缓解共线性问题,但:
- 有时这种“择一保留”的行为不是你想要的。
- 如果你希望保留一组相关变量,可以考虑 Elastic Net(结合了 Ridge 的效果)。
5. ⚠️ 样本量与变量数量的关系
- Lasso 特别适合
p >> n的高维数据(变量比样本多)。 - 但当样本量太少时,Lasso 的选择也可能不稳定。
👉 解决方法:多做交叉验证、引入先验知识、用 bootstrap 稳定变量选择。
一、数据准备阶段
Step 1: 数据清洗与预处理
# 处理缺失值
data <- na.omit(data)  # 或使用适当的插补方法

# 分类变量转换为哑变量 (因子变量会自动处理)
model.matrix(~., data = data)[,-1]  # 移除截距列

# 检查并处理极端值/异常值
boxplot(continuous_vars)
Step 2: 数据标准化 (必须步骤)
# 对连续变量进行标准化 (分类变量/哑变量不需标准化)
library(caret)
preProc <- preProcess(data[, continuous_vars], method = c("center", "scale"))
data_scaled <- predict(preProc, newdata = data)

# 或直接使用glmnet的标准化 (推荐)
# 设置standardize=TRUE (默认值)
二、模型训练阶段
Step 3: 设置合理的交叉验证
library(glmnet)

# 推荐设置
set.seed(123)  # 保证可重复性
cv_fit <- cv.glmnet(
  x = as.matrix(X),  # 必须转换为矩阵
  y = y,
  family = "binomial",  # 或"gaussian"等
  alpha = 1,  # 1 for Lasso
  type.measure = "deviance",  # 或"class", "auc", "mse"等
  nfolds = 10,  # 10折交叉验证
  parallel = TRUE,  # 若需要并行
  standardize = TRUE  # 默认TRUE,重要!
)
Step 4: 检查交叉验证结果
# 查看最优lambda值
cv_fit$lambda.min  # 最小误差对应的lambda
cv_fit$lambda.1se  # 1个标准误内的最简模型

# 绘制CV曲线
plot(cv_fit)
三、模型诊断阶段
Step 5: 系数路径分析
# 绘制系数路径
plot(cv_fit$glmnet.fit, xvar = "lambda", label = TRUE)
abline(v = log(cv_fit$lambda.min), col = "blue", lty = 2)
abline(v = log(cv_fit$lambda.1se), col = "red", lty = 2)

# 提取系数
coef_min <- coef(cv_fit, s = "lambda.min")
coef_1se <- coef(cv_fit, s = "lambda.1se")
Step 6: 模型稳定性检查
# 多次CV验证稳定性
library(doParallel)
registerDoParallel(cores = 4)
multi_cv <- replicate(10, {
  cv.glmnet(x = X, y = y, alpha = 1, family = "binomial")$lambda.1se
})
hist(multi_cv)  # 查看lambda.1se分布
Step 7: 预测性能评估
# 训练集预测 (仅演示,实际应在测试集评估)
pred <- predict(cv_fit, newx = X, s = "lambda.1se", type = "response")

# ROC分析
library(pROC)
roc_obj <- roc(y, pred)
plot(roc_obj)
auc(roc_obj)

# 校准曲线
library(rms)
val.prob(pred, y)
四、结果解释阶段
Step 8: 最终模型选择与解释
# 通常选择lambda.1se以获得更稳定的模型
final_model <- glmnet(
  x = X,
  y = y,
  alpha = 1,
  lambda = cv_fit$lambda.1se,
  family = "binomial"
)

# 获取非零系数
nonzero_coef <- coef(final_model)[which(coef(final_model) != 0), ]
print(nonzero_coef)

# 计算标准化系数 (如需比较重要性)
scaled_coef <- coef(final_model) * apply(X, 2, sd)
Step 9: 变量重要性评估
# 变量选择频率分析 (通过bootstrap)
library(boot)
boot_fn <- function(data, index) {
  fit <- glmnet(X[index,], y[index], alpha = 1,
               lambda = cv_fit$lambda.1se,
               family = "binomial")
  return(as.numeric(coef(fit) != 0)[-1])  # 去掉截距
}
boot_results <- boot(data, boot_fn, R = 200)
var_importance <- colMeans(boot_results$t)
五、报告与文档
Step 10: 结果记录
- 记录使用的R版本和包版本 (
sessionInfo()) - 保存随机种子 (
set.seed()值) - 记录数据预处理步骤
- 保存交叉验证曲线和系数路径图
- 记录最终选择的lambda值和对应变量
关键注意事项
- 标准化必须做:确保所有连续变量在同一尺度 (glmnet默认
standardize=TRUE) - 分类变量处理:因子变量会自动转换为哑变量,但需注意虚拟变量陷阱
- λ值选择:优先考虑
lambda.1se除非预测精度显著下降 - 样本量要求:至少需要样本量 > 10倍选择的变量数
- 多重共线性:Lasso虽能处理,但高相关变量的选择可能不稳定
- 结果验证:应在独立测试集验证或使用嵌套交叉验证
- 解释谨慎:被剔除的变量不代表无关联,可能是信号较弱或与其他变量相关
通过以上规范化流程,您可以确保glmnet分析结果可靠、可重复且具有实际解释价值。3
这是一个非常实用的问题。使用 glmnet 进行 Lasso 回归(或 Ridge/Elastic Net)时,要确保整个流程规范、完整、结果可靠,建议遵循如下步骤。
✅ glmnet 正确完整的建模流程(Lasso)【R语言】
🔹 Step 1. 数据准备
-
结构要求:
X: 自变量,必须是 矩阵格式(matrix或dgCMatrix,不能是 data.frame)。y: 因变量,向量(numeric)。
X <- as.matrix(mydata[, -1])  # 自变量
y <- mydata$target # 因变量-
注意事项:
- glmnet 默认 会自动标准化(standardize)变量,无需手动做,但如果你自己处理过,需设
standardize = FALSE。 - 缺失值需提前处理。
- glmnet 默认 会自动标准化(standardize)变量,无需手动做,但如果你自己处理过,需设
🔹 Step 3. 模型选择(lambda.min vs lambda.1se)
cv_fit$lambda.min  # 最小误差对应的 lambda,模型更好但复杂
cv_fit$lambda.1se # 更简洁的 lambda,误差容忍范围内- 若追求预测准确度 → 选
lambda.min - 若追求变量简洁(模型可解释性)→ 选
lambda.1se
🔹 Step 4. 模型系数提取
coef(cv_fit, s = "lambda.min") # 提取非0变量系数- 检查哪些变量被选择(非0)
- 可以用来做变量筛选、建模报告解释
🔹 Step 5. 模型预测
y_pred <- predict(cv_fit, newx = X, s = "lambda.min")- 注意
newx也必须是矩阵格式
🔹 Step 6. 模型诊断(建议)
-
交叉验证误差图:
plot(cv_fit) -
系数路径图:
plot(cv_fit$glmnet.fit, xvar = "lambda", label = TRUE) -
残差分析:
residuals <- y - y_pred plot(y_pred, residuals) qqnorm(residuals); qqline(residuals) -
Cook’s Distance 或杠杆点识别(如需):
lm_fit <- lm(y ~ ., data = as.data.frame(X))
plot(cooks.distance(lm_fit))
🔹 Step 7. 模型评估指标
- RMSE / MAE / R²:
library(Metrics)
rmse(y, y_pred)
mae(y, y_pred)- 也可以拆分数据做 训练 / 测试集验证,评估泛化能力:
train_index <- sample(1:nrow(X), 0.7 * nrow(X))
X_train <- X[train_index, ]; y_train <- y[train_index]
X_test  <- X[-train_index, ]; y_test  <- y[-train_index]

cv_fit <- cv.glmnet(X_train, y_train, alpha = 1)
y_test_pred <- predict(cv_fit, newx = X_test, s = "lambda.min")
rmse(y_test, y_test_pred)
✅ 建模注意事项总结
| 注意事项 | 说明 |
|---|---|
| 数据格式 | X 必须是矩阵,不能是 data.frame |
| 标准化 | glmnet 默认会自动标准化变量 |
| 缺失值 | 必须提前处理,否则报错 |
| lambda 选择 | lambda.min vs lambda.1se 需根据目标选择 |
| 变量解释 | 看 coef() 输出,找非零变量 |
| 过拟合防控 | 交叉验证 + 测试集评估 |
| 诊断图 | 可借助残差图、QQ图、Cook 距离等辅助分析 |
| 高维数据 | Lasso 特别适用于 p >> n 情况 |