M个学生N个科目
.Python机器学习笔记:奇异值分解(SVD)算法 - 战争热诚 - 博客园
一步步教你轻松学奇异值分解SVD降维算法 | 白宁超的官网
✅ 问题1:SVD 降维是否直接基于奇异值矩阵?
不是单独只看奇异值矩阵(Σ),而是看整个分解:
降维是通过 截取前 个最大的奇异值及其对应的奇异向量 实现的:
- 奇异值(Σ) 告诉我们每个主成分的重要性(信息量)
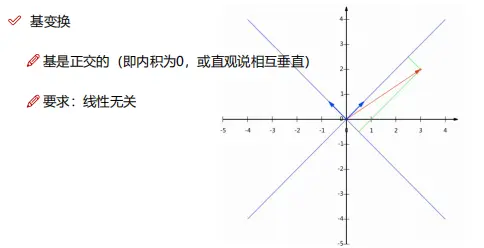
- 右奇异向量(V_k) 定义了投影的方向(特征方向)
- 左奇异向量(U_k) 表示样本在这些方向上的坐标
所以真正的降维过程是:
也可以写为:
Σ 只是衡量主成分重要性的量尺。
✅ 问题2:如何保证 SVD 正好求解了 PCA 的目标?
🎯 PCA 的优化目标
PCA 的目标是找到一个投影方向 ,使得原始数据 在这 个方向上投影后的方差最大化(也即信息保留最多):
也可以等价地理解为:最小化原始数据和重构数据之间的误差:
这个低秩逼近问题正好由 SVD 的前 项截断解决!
最小化误差 不一定方差最大
📌 数学连接点:协方差矩阵特征分解
- 假设数据 是中心化的(每列减去均值)
- 则 PCA 是对协方差矩阵做特征分解:
其中:
- :是特征向量矩阵(PCA 的方向)
- :是特征值矩阵(对应方差)
- 这和 SVD 中的:
对比发现:
- 就是协方差矩阵的特征值(乘了 或 的比例常数)
- 是 PCA 的投影方向
- 所以 PCA 实际上就是对 做特征分解,而这正好被 SVD 求出来了!
等价归纳
| 对象 | SVD | PCA |
|---|---|---|
| 输入 | 任意矩阵 | 零均值矩阵 |
| 输出 | 协方差矩阵的特征向量(= ) | |
| 主成分方向 | (右奇异向量) | 协方差矩阵的特征向量 |
| 主成分大小 | (奇异值平方) | 协方差矩阵的特征值 |
| 降维坐标 | 同上 |
所以,只要数据中心化过,PCA 就等价于 SVD 的前 项截断!
转置后,PCA 所需的列均值为零可能部分满足(取决于你中位数化是否改变了列均值),但严格来说,为保证协方差矩阵准确,最好再次按列中心化。
如果不中心化,直接用SVD得到的结果通常不是我们想要的PCA。
奇异值分解(SVD)原理与在降维中的应用 - 刘建平Pinard - 博客园
下面我会把你真正关心的核心问题彻底解释清楚:
当矩阵 A 不是方阵(例如 PCA 的样本×基因矩阵),我没有传统的特征值和特征向量,那用 SVD 得到的 U、V 是谁的“特征向量”?我该如何画载荷图?
这是 PCA 和 SVD 中最容易造成混淆的点,我会用最清晰的数学和生物信息学视角解开。
非方阵 A 本身没有特征值,但 AᵀA 和 AAᵀ 是方阵,有特征向量。
SVD 的 U 和 V 就是这两个方阵的特征向量。
更明确:
✔ V 的列 = AᵀA(基因 × 基因协方差矩阵)的特征向量
= PCA 载荷(loadings)
✔ U 的列 = AAᵀ(样本 × 样本协方差矩阵)的特征向量
= 样本在主成分方向上的投影(scores)
✔ Σ² 的对角线 = AᵀA 的特征值(即 PCA 的特征值)
🧠 为什么会这样?(但我用简单方式解释)
设你的数据矩阵是:
- n = 样本数
- p = 基因/蛋白/特征数
通常 p >> n,不是方阵,所以 A 没有特征值分解。
但是:
| 矩阵 | 维度 | 用途 | 特征向量 |
|---|---|---|---|
| (A^TA) | p×p | 特征协方差 | V(载荷) |
| (AA^T) | n×n | 样本协方差 | U(得分) |
SVD:
两边左乘 得:
注意结构:
- 这是标准的 特征值分解
- 左边是基因×基因协方差矩阵
- 右边 V 是特征向量
所以 V 的列就是 PCA 的 loadings。
同理:
所以:
- U 的列 = 样本对应的 PCA 得分方向(scores)
📌 最终答案(用于作图):
✔ 载荷图(loadings plot)使用的向量 = SVD 的 V
你画:
- PC1 loadings → V[,1]
- PC2 loadings → V[,2]
这和 PCA 得到的特征向量完全一致(只是符号 ± 可交换)。
📌 样本得分图(scores plot)使用 = SVD 的 UΣ
PCA scores =
所以:
- PC1 scores → U[,1] * Σ$$
1