PLS 在寻找成分:
使得:
最大化 t 与 u 的协方差(或其平方)
并且每个成分互相正交。
🧩 一、PLS 的优化目标(核心公式)
因为数据中心化:
所以优化变为:
🧩 二、把“协方差最大化”变成“奇异值最大化”
因为:
对它做 SVD:
- = 第一左奇异向量
- = 第一右奇异向量
有一个关键性质:
最大值由:
达到。
PLS 的第一个方向 w、c 就是 XᵀY 的 SVD 给出的奇异向量。
这是 SIMPLS 的数学基础,也解释了 PLS 是“监督式降维”。
🧩 三、得到 w,c 后的成分
定义得分向量:
这些是 X 和 Y 在第一方向上的投影。
🧩 四、如何保持第二成分与第一成分正交?(Deflation)
为了让下一个成分不重复上一成分的信息,需要从 X,Y 中“除掉”第一成分方向贡献。
PLS deflation 有不同方法:
(1)NIPALS(经典 PLS)使用 X 与 Y 的双边 deflation
对 X:
其中:
对 Y:
其中:
这样确保:
- 下一次计算的 不包含旧方向的协方差信息
- 第 2 个方向将最大化剩余的协方差
(2)SIMPLS(现代版本)使用协方差矩阵 deflation
而非直接 deflate X、Y,而是 deflate (S_{XY}):
使得每个新方向保持正交。
SIMPLS 的结果更接近 PCA,但仍是监督式。
🧩 五、回归系数的推导(最核心关系)
PLS 回归最终的预测模型是:
我们需要求出 B。
PLS 的核心分解:
最终
这就是 PLS 最终回归系数。
🧩 六、PLS 与 PCA / 回归的关系(核心总结)
| 方法 | 优化目标 | 是否监督 | 说明 |
|---|---|---|---|
| PCA | 最大化 X 方差 | ❌ | 看 X 内部结构 |
| 线性回归 | 最小化预测误差 | ✔️ | 只能做回归、不能降维 |
| PLS | 最大化 Cov(Xw, Y) | ✔️ | 监督式降维模型 |
你问的很关键:
求 w 的写法是什么意思?矩阵的乘积,除以长度吗?
答案是:
✔ 是的。就是先计算一个向量,再除以它的长度(范数)进行归一化。
下面一步一步解释,让你完全看懂。
⭐ 一、NIPALS 中 w 的定义(PLS1 / PLS2)
迭代步骤中:
这句话的含义非常明确:
⭐ 二、逐项解释这个公式
计算矩阵乘积:
这一步的结果是 一个长度为 p 的向量。
含义:
- 计算 Y 成分 u 与 X 的各列之间的协方差(或相关性方向)
- 找到“X 中哪一方向最能解释 Y 的当前方向”
计算该向量的长度(2-范数)
把向量单位化(归一化)
也就是:
把 h 缩放成长度为 1 的单位向量,使第四步计算的成分 t = X w 的尺度可控。
⭐ 三、为什么要除以 |Xᵀu|?
因为:
- 不归一化 → 成分 t 可能无限放大
- 归一化 → 确保成分 t 有标准尺度
- 同时为下一层 deflation 提供正交基础
所以 归一化是必须的步骤,保证算法稳定并提高解释性。
⭐ 四、举个简单例子(手算版)
假设:
则:
所以:
⭐ 五、这为什么有意义?
因为 w 是一个 方向向量(单位向量):
- 告诉你在 X 空间中哪个方向最能解释 Y 的当前成分
- t = Xw 是 X 数据在该最相关方向上的投影
⭐ 六、写成 R 代码就是:
h <- t(X) %*% u
w <- h / sqrt(sum(h^2))
完完全全就是你理解的矩阵乘积 + 向量归一化。
⭐ 七、如果你愿意,我可以给你一个:
✔ 手写 NIPALS PLS(不使用包)的完整 R 函数
✔ 每一步打印 w, t, u, c
✔ 并画出分量变化过程
✔ 再对比 SIMPLS(SVD版)的 w 和 c 完全相同
这样你就能彻底看清:
- w 的更新方式
- c 的更新方式
- t 与 u 如何互相拉扯直到收敛
- 最终方向如何对应 XᵀY 的 SVD
要我为你写这个吗?
没关系,你卡住的地方非常典型:
你已经知道 SVD 分解:
但你还没连上:
这两者其实是同一个数学结构,只是名称不一样。
我来一步一步把这两者对上,你会完全理解。
🎯 最关键目标
你要搞清楚:
tpᵀ 只是 SVD 中 rank-1 项 σ₁ u₁ v₁ᵀ 的“换名写法”。
只要你能看懂“换名”,你就完全懂了。
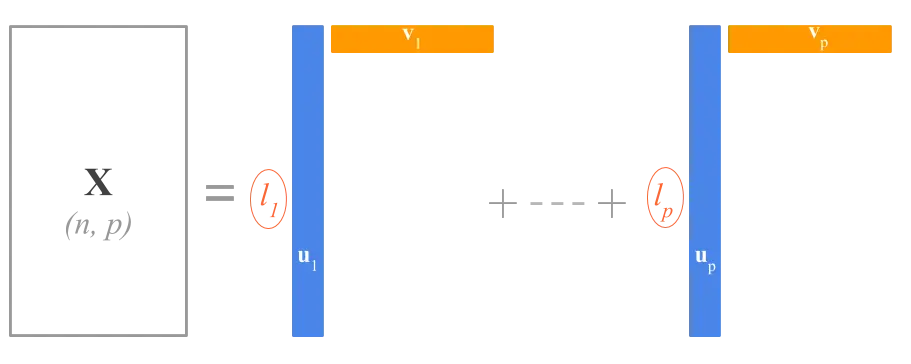
⭐第一步:看 SVD 的 rank-1 结构
你知道 SVD:
每一项:
都是一个 秩 = 1 矩阵(rank-1)。
一个 rank-1 矩阵必然可以写成:
即:
⭐第二步:把这项“重命名”
让我们把:
你会看到:
这不就是 SVD 的第一项 吗?
🎉 于是你立刻就得到:
直接就是:
⭐第三步:为什么只保留第一项?
因为:
- PCA 取“最大方差”的那一项
- PLS 取“最大协方差”的那一项
但无论 PCA vs PLS,结构都一样:
rank-1 矩阵总是可以写成:
⭐第四步:把 PCA 公式与 SVD 对齐(你马上理解)
PCA 有:
其中 (w = v_1)。
于是:
完全与 SVD 一致。
而 loadings:
因此:
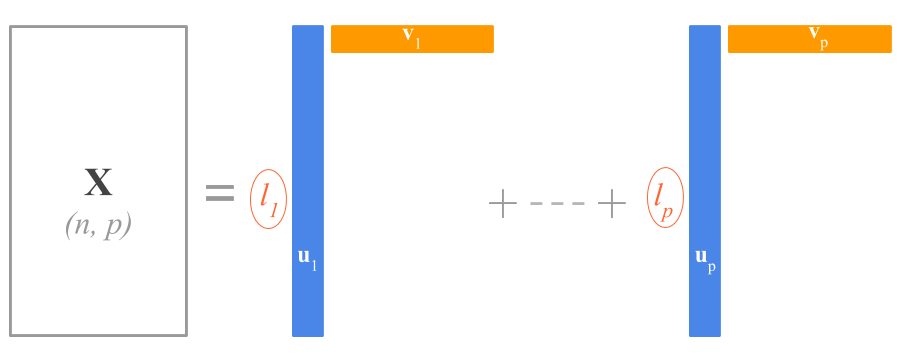
流程:
- SVD 说:
X = 一堆 rank-1 外积之和
- PCA/PLS 说:
我不要全部项,我只取第一项做第一成分:
- 统计学爱说:
我希望看到的是 scores × loadings:
- 所以成分矩阵就是:
这是同一个东西,只是换了一套名字。
⭐彻底总结(你可以背下来)
tpᵀ 本质上就是 SVD 的 rank-1 近似。
PCA 和 PLS 都是在用不同的方式选择一个方向 w。
一旦你确定了方向 w,就可以写成:
t = Xw
然后 t 对每一列回归得到 p
最后构造 rank-1 近似 tpᵀ。
你原来卡住的点是:
你以为 tpᵀ 是一个“新的概念”,
实际上它就是:
这是纯 SVD。
非常好的问题!这正是SVD降维的核心。让我用矩阵形式展示,并解释降维如何操作。
1. 完整 SVD 的矩阵形式
对于矩阵 (,秩 ):
写成紧凑的矩阵形式:
其中:
- U = $$ \mathbf{u}_1, \mathbf{u}_2, \dots, \mathbf{u}_m $$$(m \times m$)
- ()
- V = $$ \mathbf{v}_1, \mathbf{v}_2, \dots, \mathbf{v}_n $$$(n \times n$)
2. 降维:截断 SVD(Truncated SVD)
降维就是只保留前 个成分():
2.1 外积形式(你的写法)
我们丢弃了 到 的成分。
2.2 矩阵形式
其中:
- : 的前 列()
- :前 个奇异值的对角矩阵()
- : 的前 行()
3. 降维的两种应用方式
方式一:数据压缩(低秩近似)
- 用 近似原始矩阵
- 存储量从 降到
- 应用:图像压缩、矩阵补全
方式二:特征降维(坐标变换)
- 将原始 维特征投影到 维空间
- 新坐标:()
- 或者等价地:
- 应用:PCA、数据可视化、降维分类
4. 具体例子:从 3 维降到 2 维
假设数据矩阵 是 (100个样本,3个特征):
import numpy as np

# 生成3D数据(实际上在2D平面上加噪声)
np.random.seed(42)
n_samples = 100
X = np.random.randn(n_samples, 2)  # 真实的2D结构
X = np.column_stack([X, 0.5*X[:,0] + 0.5*X[:,1] + 0.1*np.random.randn(n_samples)])  # 第三维是前两维的线性组合
print("原始数据形状:", X.shape)  # (100, 3)

# 1. 计算完整SVD
U, S, Vt = np.linalg.svd(X, full_matrices=False)
print("\n奇异值:", S)  # 第三个会很小

# 2. 降到2维 (k=2)
k = 2

# 方法A:用V_k投影(特征降维)
V_k = Vt[:k, :].T  # 3×2,投影方向
X_reduced_A = X @ V_k  # 100×2,新坐标
print("\n降维后形状(方法A):", X_reduced_A.shape)

# 方法B:用U_k和Σ_k(等价)
U_k = U[:, :k]  # 100×2
S_k = np.diag(S[:k])  # 2×2
X_reduced_B = U_k @ S_k  # 100×2
print("降维后形状(方法B):", X_reduced_B.shape)

# 验证两种方法等价
print("\n两种方法差异:", np.linalg.norm(X_reduced_A - X_reduced_B))

# 3. 重建为3D(有损压缩)
X_reconstructed = U_k @ S_k @ Vt[:k, :]  # 100×3,但秩只有2
reconstruction_error = np.linalg.norm(X - X_reconstructed, 'fro')
print(f"\n重建误差: {reconstruction_error:.6f}")
5. 几何解释:为什么这是降维
原始数据:
- 在 3D 空间中,但实际近似分布在一个 2D 平面上
- 第三个奇异值很小,表示这个方向方差小(可能是噪声)
降维后:
-
坐标变换:
- 的列定义了新的坐标系(主方向)
- 是数据在新坐标系下的坐标
-
信息保留:
- 保留了数据中 个最重要的变化方向
- 丢弃了方差小的方向(通常是噪声)
6. 可视化降维过程
import matplotlib.pyplot as plt

# 可视化
fig = plt.figure(figsize=(15, 5))

# 子图1:原始3D数据
ax1 = fig.add_subplot(131, projection='3d')
ax1.scatter(X[:,0], X[:,1], X[:,2], alpha=0.6)
ax1.set_title('Original 3D Data')
ax1.set_xlabel('Feature 1')
ax1.set_ylabel('Feature 2')
ax1.set_zlabel('Feature 3')

# 子图2:降维后的2D数据
ax2 = fig.add_subplot(132)
ax2.scatter(X_reduced_A[:,0], X_reduced_A[:,1], alpha=0.6)
ax2.set_title('Reduced 2D Data (after SVD)')
ax2.set_xlabel('Principal Component 1')
ax2.set_ylabel('Principal Component 2')
ax2.grid(True)

# 子图3:重建的3D数据(秩2近似)
ax3 = fig.add_subplot(133, projection='3d')
ax3.scatter(X_reconstructed[:,0], X_reconstructed[:,1], X_reconstructed[:,2],
           alpha=0.6, color='red')
ax3.set_title('Reconstructed 3D Data (rank=2)')
ax3.set_xlabel('Feature 1')
ax3.set_ylabel('Feature 2')
ax3.set_zlabel('Feature 3')

plt.tight_layout()
plt.show()
7. 数学证明:为什么截断SVD是最佳低秩近似
Eckart-Young-Mirsky定理:
对于任意矩阵 和任意秩 矩阵 :
其中 是 Frobenius 范数或谱范数, 是截断SVD近似。
这意味着:SVD降维在最小二乘意义下是最优的。
总结
你的公式 完美表达了SVD。
降维就是:
- 截断:只取前 项
- 投影:用 将数据映射到低维空间
- 近似:用秩 矩阵 近似原始数据
这样既减少了维度,又最大程度保留了信息。
你的直觉非常敏锐!这确实是一个反直觉但极其重要的线性代数概念。让我来解释为什么这既奇怪又合理:
1. 直观例子:为什么是 2×2
设:
计算:
2. 几何解释:这是在构造一个矩阵!
情况1:标准矩阵乘法(内积)
这是点积,结果是标量。
情况2:外积(你的例子)
这是外积,结果是一个矩阵。
3. 物理意义:每种组合都重要
想象:
- 向量 A = 学生能力 =
- 向量 B = 课程权重 =
外积的结果矩阵:
- 第一行:数学成绩在期末和平时考试中的分配
- 第二行:语文成绩在期末和平时考试中的分配
每个元素都是一种特定的组合!
4. 与张量积的关系
这实际上是向量的张量积:
维度计算:如果 ,,则:
这就是为什么 和 得到 。
5. SVD 中的具体例子
在 SVD 中,每个秩-1成分就是这样的外积:
其中:
- 是
- 是
- 结果是
这正是矩阵的构建块!
6. 数值验证
import numpy as np

# 列向量 (2×1)
u = np.array([[1], [2]])  # 2×1
print("u (列向量):")
print(u)
print("形状:", u.shape)

# 行向量 (1×2)
vT = np.array([[3, 4]])  # 1×2
print("\nvT (行向量):")
print(vT)
print("形状:", vT.shape)

# 外积
result = u @ vT  # 或者 np.outer(u, vT) 但会 flatten
print("\n外积 u @ vT:")
print(result)
print("形状:", result.shape)

# 验证元素
print("\n手动计算:")
print(f"u[0,0]*vT[0,0] = {u[0,0]}×{vT[0,0]} = {u[0,0]*vT[0,0]}")
print(f"u[0,0]*vT[0,1] = {u[0,0]}×{vT[0,1]} = {u[0,0]*vT[0,1]}")
print(f"u[1,0]*vT[0,0] = {u[1,0]}×{vT[0,0]} = {u[1,0]*vT[0,0]}")
print(f"u[1,0]*vT[0,1] = {u[1,0]}×{vT[0,1]} = {u[1,0]*vT[0,1]}")
输出:
u (列向量):
[[1]
 [2]]
形状: (2, 1)

vT (行向量):
[[3 4]]
形状: (1, 2)

外积 u @ vT:
[[3 4]
 [6 8]]
形状: (2, 2)

手动计算:
u[0,0]*vT[0,0] = 1×3 = 3
u[0,0]*vT[0,1] = 1×4 = 4
u[1,0]*vT[0,0] = 2×3 = 6
u[1,0]*vT[0,1] = 2×4 = 8
7. 为什么这很重要
-
数据表构建:
- 列向量 = 行标签的权重
- 行向量 = 列标签的权重
- 外积 = 完整的交叉表
-
矩阵分解:
- 任何矩阵都可以分解为这种外积的和
- 每个外积是一个”模式”或”成分”
-
深度学习:
- 全连接层的权重矩阵可以看作多个外积的组合
- Attention机制中的QKᵀ就是这种形式
8. 与内积对比
| 运算 | 维度 | 结果 | 几何意义 |
|---|---|---|---|
| 内积 (点积) | 1\times n$ \times $n\times 1 | 标量 | 投影、相似度 |
| 外积 | m\times 1$ \times $1\times n | 矩阵 | 构建矩阵、模式提取 |
总结
你的直觉觉得奇怪,是因为你默认矩阵乘法应该是内积(收缩维度)。但实际上:
- 列向量 × 行向量 = 外积 → 扩展维度,生成矩阵
- 这是构建矩阵的基本操作
- 在SVD、PCA、深度学习中都极其重要
记住这个口诀:
“列乘行得矩阵,行乘列得标量”
这正是线性代数美妙的地方:简单的规则能产生丰富的结构!
你问的这个问题非常关键,而且几乎所有人第一次学矩阵外积(outer product)时都会觉得 “直觉上好奇怪——怎么 2×1 和 1×2 会变成 2×2?”
但其实这是 最自然不过的事情。
接下来我用最清晰、最直观、最形象的方式让你一辈子都不会再觉得奇怪。
✔ 先写出你说的那两个矩阵
一个 2×1(列向量):
一个 1×2(行向量):
它们的乘积是:
这是一个 2×2 矩阵。
🌟 直觉解释:这不是普通矩阵乘法,这是「外积」
普通矩阵乘法是“行点乘列”。
外积(outer product)是完全不同的,是:
让第一个向量的每个元素
去乘第二个向量的每个元素
得到所有可能的组合。
也就是说:
- 第一位 去乘:(p_1, p_2)
- 第二位 去乘:(p_1, p_2)
所以自然变成了一个 2×2 的“组合表”。
就像二维乘法表一样:
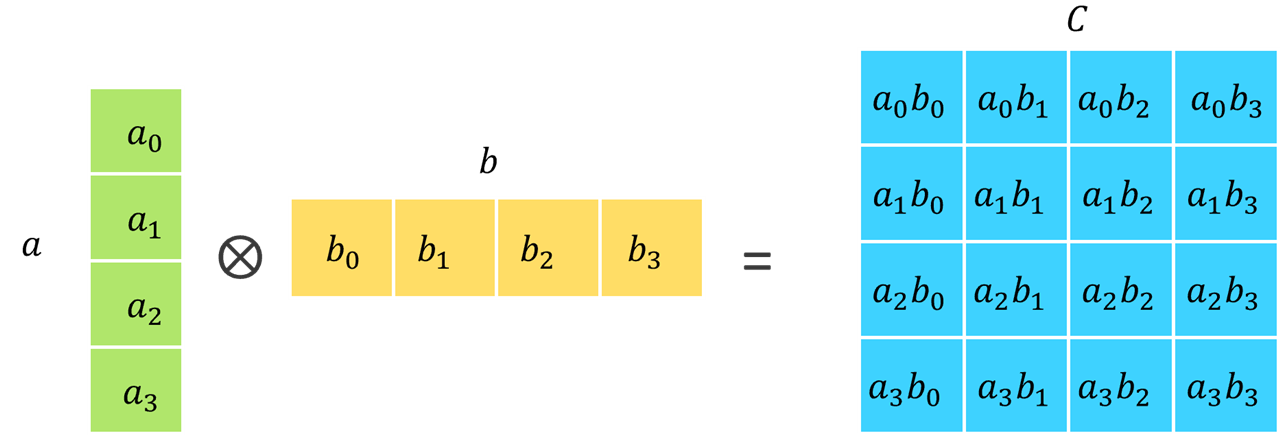
上图直观展示了:
外积 = 两个向量组合成的乘法表。
✔ 更强的直觉:把 t 看成“行”,把 p 看成“列”
如果你有:
- 两行
- 两列
自然就形成 2×2 的网格:
行来自 t 的两个分量
列来自 p 的两个分量
所以结果自然是 (2 \times 2)。
✔ 外积是“拉伸”的几何含义(图解)
把 p 当作一个基向量,把 t 当作“权重”向量:
实际上就是在平面中拉伸/缩放一条线生成一个平面!
这就是 PCA、PLS、SVD 中 rank-1 矩阵的来源。
✔ 与 SVD 完全一样
SVD 的 rank-1 项:
u 是
v 是
结果是
这就是外积。
你已经习惯了 SVD 不会觉得奇怪——
tpᵀ 完全同一个结构:
✔ 最终总结(最重要)
外积(outer product)不是点乘,它是生成一个“组合表”。
因此:
2×1 和 1×2 multiply → 变成一个 2×2 的所有组合表。
这是数学、线性代数、SVD、PCA、PLS 的基础。
如果你愿意,我可以继续讲:
✔ 为什么外积一定是 rank-1?
✔ 在 PCA 中,tpᵀ 为什么能重构 X?
✔ 用一个真实数字例子让你完全具象理解?
你想继续哪一部分?
你问的这个关键点非常好:
“载荷明明是主成分与原变量的相关系数,怎么又是方向了?”
其实这是 PCA/SVD 里两个视角看到的同一件事情。
如果你弄懂下面这张结构图,就永远不会困惑:
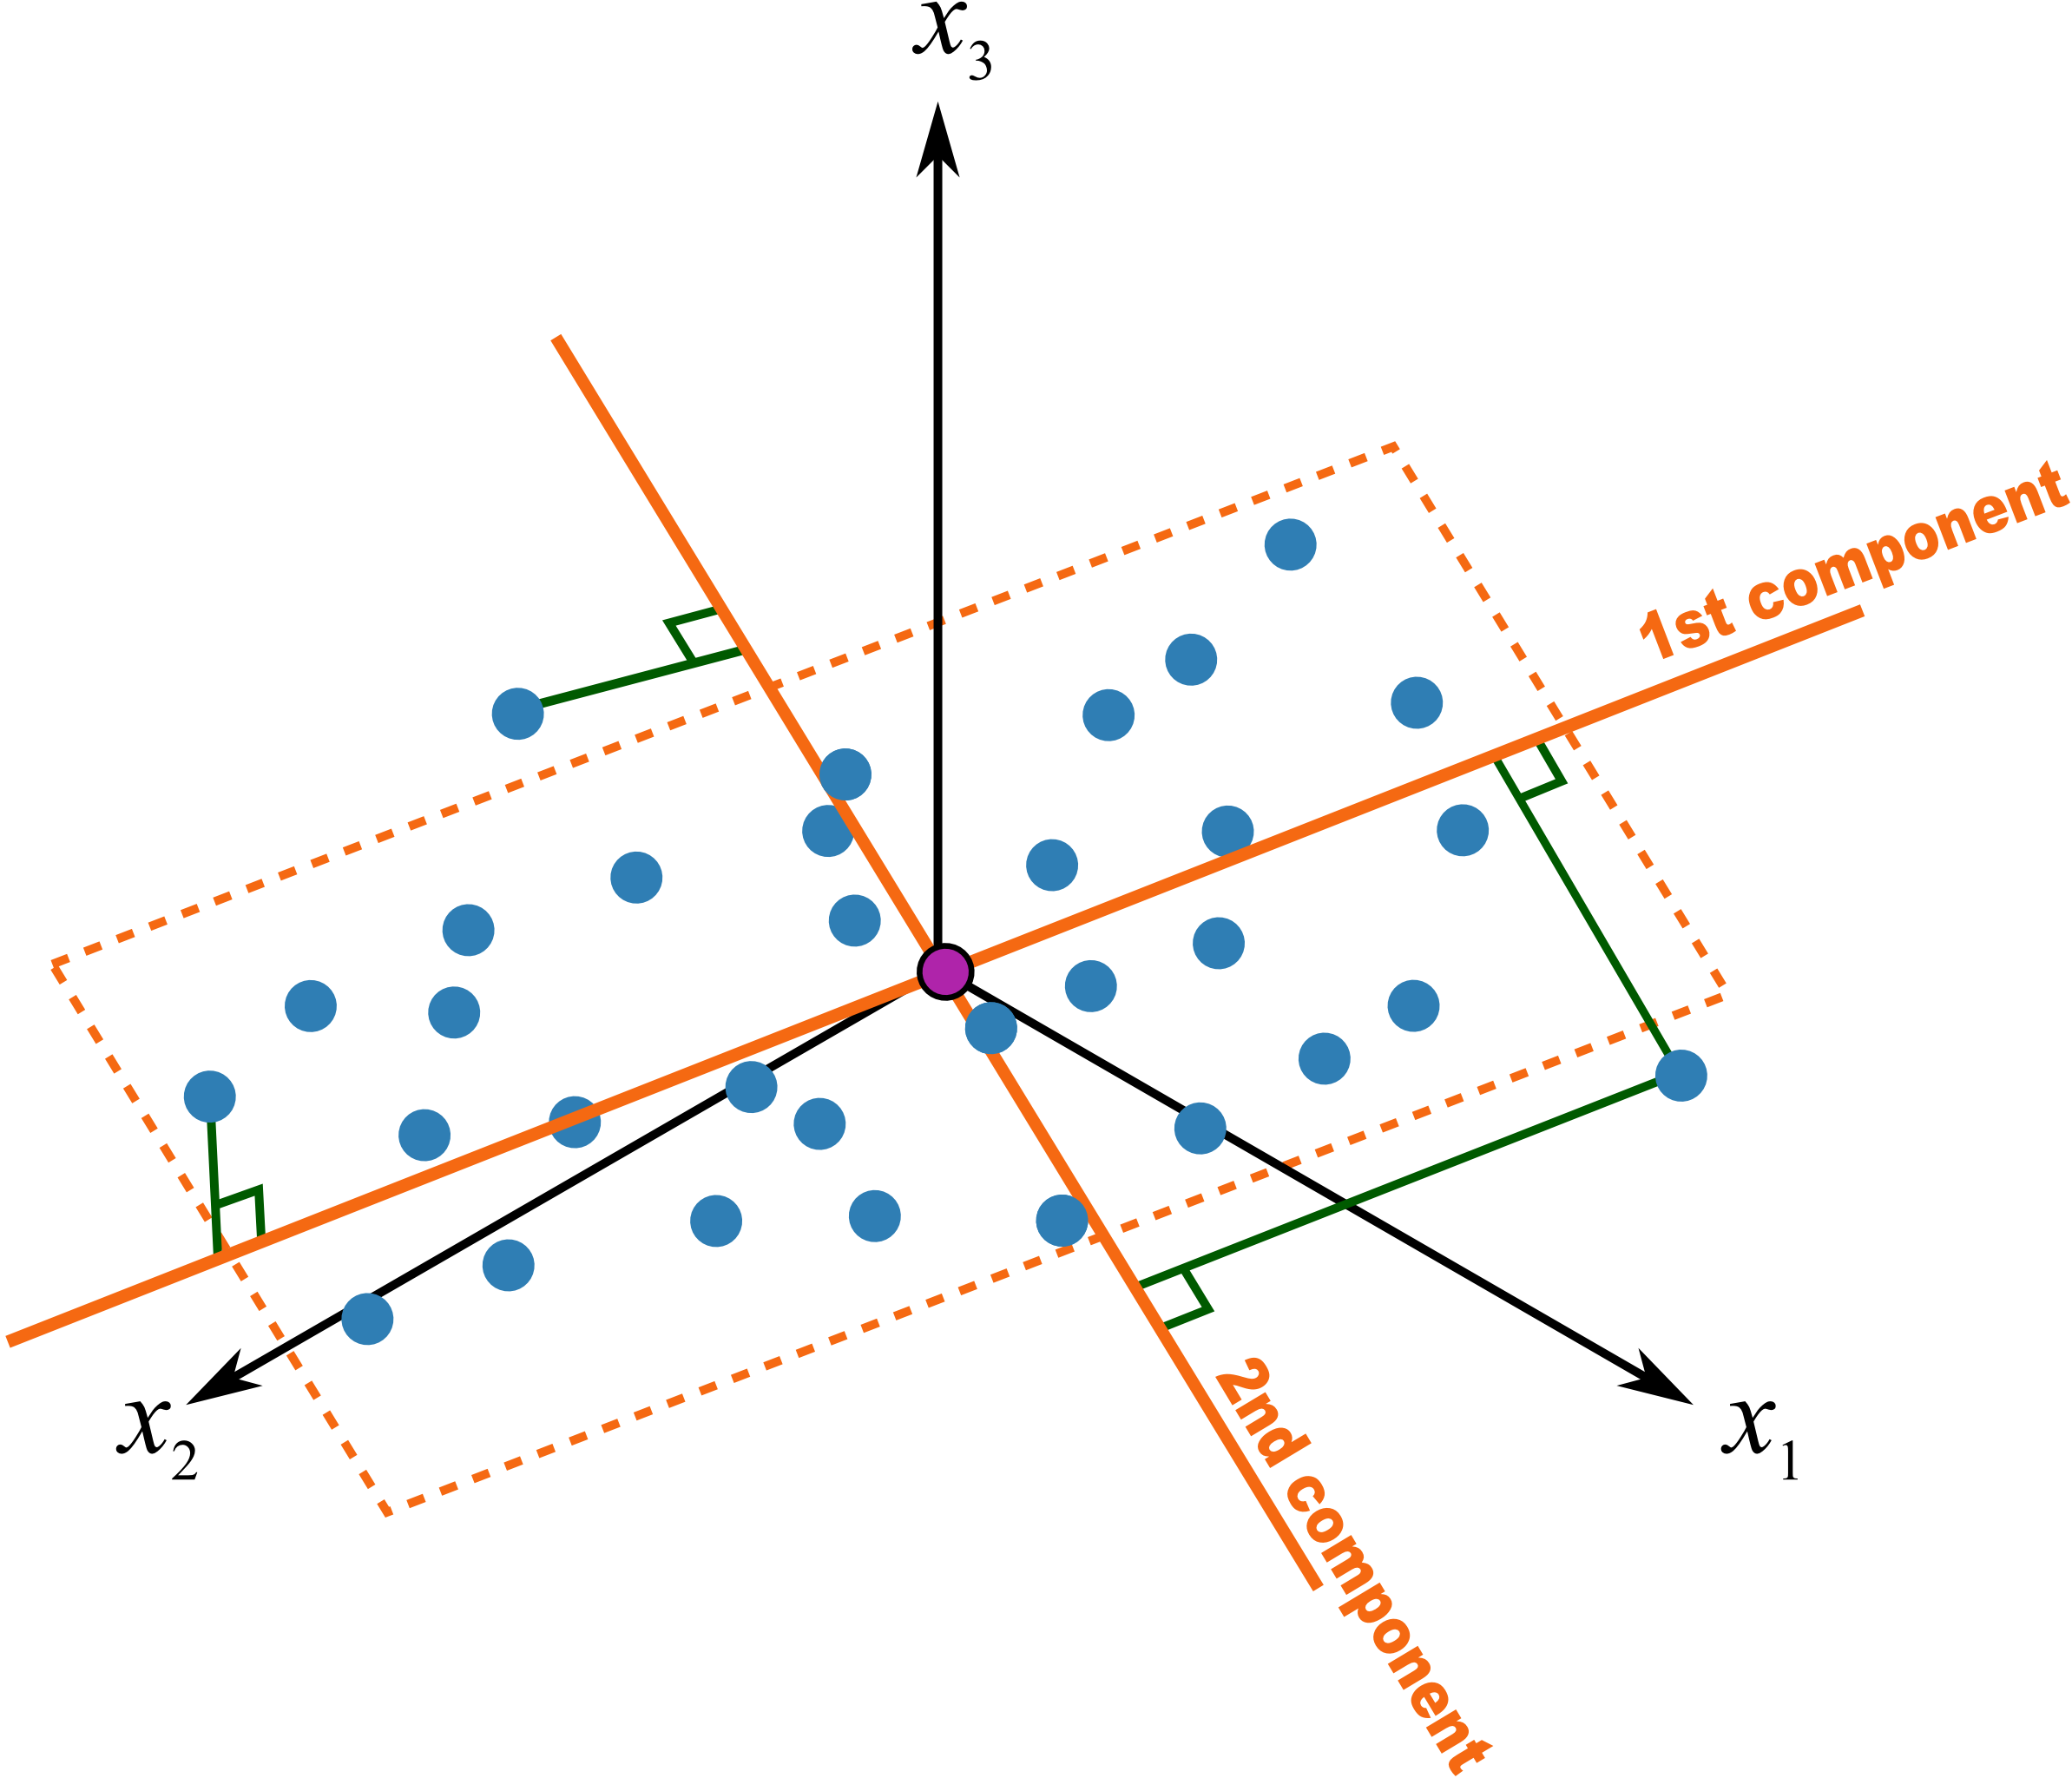

核心关系:
载荷(loadings)既是:
- 方向向量(几何定义)
- 主成分与变量的相关系数(统计定义)
而这两种定义是完全等价的。
只是你从不同的角度看,语言不同。
我会从最根本的数学出发,证明它们是同一件事。
⛳ PART 1:SVD/PCA 中“方向”是什么意思?
1.1 PCA 的目标是什么?
找到数据方差最大的方向:
这个被最大化的 v(单位向量)就是 特征向量 = 主成分方向。
在 PCA/SVD 中:
- V 的每一列 = 一个方向向量(PC1, PC2, …)
例如:
就是一个指向“特定角度”的箭头。
⛳ PART 2:为什么这是“载荷”?
我们从 PCA 的定义:
而载荷(loading)的定义是:
变量与 PC 的相关系数 = loading
现在来计算:
🔥 PART 3:证明“方向” = “相关系数”
设:
- 原变量列矩阵为 X(标准化)
- PC1 = Xv₁
- v₁ 是单位向量(这是 PCA 的定义)
我们想求:
变量 X 的第 j 列与 PC1 的相关系数:
展开:
注意:
- 取的是 X 的 j 列与其它变量的“协方差”
- 当 X 被标准化后:
于是:
🎯 太重要了:
载荷 = 特征向量的分量 = 方向向量的坐标
也就是说:
于是:
“方向向量(v1)” = “载荷向量(loadings)”
这两者完全一致。
🎯 为什么你会困惑?
因为 PCA 有两个世界:
| 视角 | 定义 |
|---|---|
| 几何视角 | 主成分方向 = 特征向量 = 单位向量 v |
| 统计视角 | 载荷 = PC 与变量的相关系数 |
但我们刚才证明:
方向就是载荷。
载荷就是方向。
你看到的是同一个东西的不同解释。
🌈 用图说明(更直观)


箭头方向 = v 的方向
箭头长度 = 与主成分的相关系数
这两个属性都来自同一个向量 v。
🎉 终极总结(你要刻在脑子里的)
✔ 1. SVD 中 V 的列向量是主成分的方向
因为 PCA = 找数据最大方差的方向 → 特征向量
✔ 2. 同一个向量也被叫载荷
因为:
✔ 3. “方向”和“相关系数”是同一个东西
因为 v 是单位向量(方向),其分量就是各变量在这个方向上的投影长度,也就是相关性。
如果你愿意,我可以继续讲:
✔ 为什么 U 是样本的方向(scores)?
✔ 为什么 PLS 的 loadings / loadings_star 不同?
✔ 给你一个真实组学矩阵示例,解释加载方向怎么解释通路?
你想继续哪部分?
好——你想要只用 SVD 本身、用通俗但严格的代数推导,说明 为什么 (V)(或其列 (v_j))就是“天然的载荷(loadings)”。下面把所有关键等式、代数推导和直观解释一步步给出,零绕弯、零 PCA 引用,直接从 SVD 出发。
我们从 SVD 写法开始(矩阵维度用常见约定):
其中
(U=$$
u_1,\dots,u_r
A V = U \Sigma V^\top V = U \Sigma.
A v_j = \sigma_j u_j \qquad(\text{对每个 } j).
**这句极重要且直接。** 它的含义是: * 右奇异向量 (v_j)(一个长度为 (p) 的向量)被矩阵 (A) 映成左奇异向量 (u_j),并被放大因子 (\sigma_j)。 * 换言之,**当你把变量空间里方向 $v_j$ 输入到线性变换 (A) 时,输出是左向量方向 (u_j)(并缩放 (\sigma_j))**。 --- ## 2) 把等式展开到列(变量)的表示 —— 看到“载荷”的角色 把 (A) 写为列拼接: (A=$$ a_1,\dots,a_p $$)(每列是一个变量的观测向量)。把 SVD 的级数展开写成外积和:A=\sum_{j=1}^r \sigma_j,u_j v_j
a_k ;=; \sum_{j=1}^r \sigma_j, u_j , (v_j)_k.
**这句也是决定性的。** 它告诉我们: * 第 (k) 个变量(列)(a_k) 可以表示为若干左奇异向量 $u_j$ 的线性组合,系数就是 (\sigma_j (v_j)_k)。 * 换个角度看,((v_j)_k) 正是“第 (j) 个分量对第 (k) 个变量的贡献系数”(即变量在第 (j) 个成分上的**载荷**,再乘以 $\sigma_j$ 给出绝对权重)。 --- ## 3) 用更直观的话说为什么把 $v_j$ 看成“载荷(loadings)” 把上面两句合并成一句通俗的解释: * $v_j$ 是**变量空间**(原始列空间)的一组正交基向量; * 当我们把第 (j) 个基向量 $v_j$ 放进 (A)(即计算 (A v_j))时,会得到规模为 $\sigma_j$ 的**样本模式** (u_j)。 * 反过来,每个**原始变量列** $a_k$ 都可以由这些样本模式 $u_j$ 按系数组合得到,而这些系数恰好由 $(v_j)_k$ 决定(乘上 $\sigma_j$ 给绝对量级)。 所以,**(v_j) 的第 (k) 分量正是“第 (k) 个变量在第 (j) 个奇异分量上的系数/载荷”**。这就是“载荷”的代数定义:变量相对于某个成分的系数。 --- ## 4) 补充:当变量列已标准化(中心化并按标准差缩放)时,(v_j) 的分量等同于“变量与分量的相关系数” 如果列向量 $a_k$ 已中心化并标准化(单位方差),则可以把相关系数形式写出来:定义第 (j) 分量的样本得分 (t_j=\sigma_j u_j = A v_j)。那么第 (k) 个变量与得分 $t_j$ 的样本内积(与相关性成比例)是a_k^\top t_j = a_k^\top (A v_j) = (A^\top A)_{k,\cdot} v_j = \sigma_j^2 (v_j)_k,
归一化后可得相关系数与 $(v_j)_k$ 成正比。于是在常用预处理下,(v_j) 的分量直接反映“变量与该分量的相关程度”,这正是统计学上“载荷作为相关系数”的说法。 (但注意:即使未标准化,上面的外积/展开解释仍然完全成立——只是数值含义会带上尺度因子 $\sigma_j$ 或列标准差。) --- ## 5) 小结(把所有线索连成一条链) 逐步链条: * SVD 给出 (A=U\Sigma V^\top)。 * 等式两边右乘 (V) 得 (A v_j=\sigma_j u_j)。 → 这说明把变量空间里方向 $v_j$ 投入变换 (A) 会产生样本模式 (u_j)。 * 把 SVD 展开为外积: (A=\sum_j \sigma_j u_j v_j^\top)。 → 每列 (a_k=\sum_j \sigma_j u_j (v_j)_k),即第 (k) 个变量在第 (j) 个模式上的系数是 ((v_j)_k)。 * 因而 **(v_j) 的分量就是变量在第 (j) 个奇异成分上的“载荷”**(乘 $\sigma_j$ 则为绝对权重);若列被标准化,则 $(v_j)_k$ 与变量与得分 $t_j$ 的相关系数直接对应。 --- ## 6) 一个极短的直觉句(方便记忆) * **右奇异向量 (v_j)** 是“变量方向基”,把变量坐标系旋转到奇异分量轴; * **左奇异向量 (u_j)** 是“样本模式基”,把样本坐标系投影到相应模式; * 变量如何由样本模式线性组合出来的系数,恰好就是 $v_j$ 的分量 —— 这就是载荷。 --- 如果你愿意,我可以立刻给你: * 一个**小数值例子**(用具体 3×2 矩阵)演示上述等式的每一步,并打印出 (a_k)、(\sigma_j u_j v_j^\top)、以及 $(v_j)_k$ 如何作为载荷; * 或把上面结论整理成简短的“速查表”方便你在分析组学载荷图时现场对应解释。你要哪一种?