相关系数:当X和Y不相关,通常认为X和Y之间不存在线性关系,但并不能排除X和Y之间可能存在其他关系
协方差就是俩人跳舞的舞步协同程度,如果一起向前走或者向后退,协方差就是正值;如果一个朝前一个朝后,协方差就是负值;如果各自都不动,就是零。
Pearson相关系数
- 什么时候用pearson? 什么时候用spearman?
- 数据无异常值; 箱线图
- 两组数据之间呈线性相关关系; 散点图
- 数据服从正态分布。 QQ图
Spearman相关系数
对两个变量排序以后的rank进行计算 Pearson相关系数,被称为Spearman相关系数。
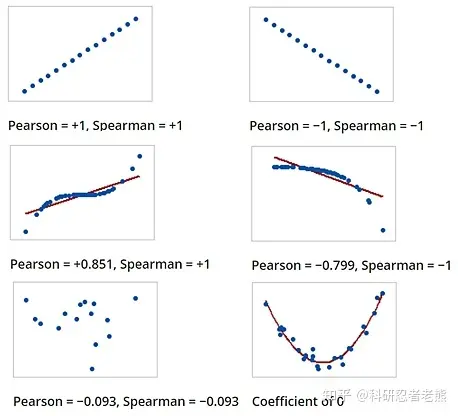
Pearson相关系数只能衡量线性程度,而 Spearman相关系数则偏重考察两个变量是否有正相关或者负相关
Pearson相关假设数据集在同一条直线上,而Spearman只要求单调递增或者递减(比如最常见的log scale单调变换),所以Pearson的统计效力比Spearman要高。我们要强调的是,Pearson相关系数要求统计资料要是连续型变量,并且符合正态分布,而Spearman相关系数没有这个要求,Pearson相关系数在出现奇异值,或者长尾分布的时候稳定性差,不太靠,而Spearman要相对稳健很多。
pearson:衡量线性相关的程度,要求正态分布,并且没有长尾,但是转录本一般都有长尾;
spearman:排序,衡量单调性,比pearson更稳健,如右下图,增加一个点就有了相关性
相关系数的标准化
相关系数,最好是先做出散点图,再利用这些数学工具去分析,否则容易得出错误的结果。
covariance 协方差
相关系数只是协方差绑定到范围[-1,1]的标准化版本。
方差: 衡量自身和自身的关系
协方差:衡量两个数据数据之间的关系
协方差矩阵: 对角为方差。
在统计学中,方差是用来度量单个随机变量的离散程度,而协方差则一般用来刻画两个随机变量的相似程度
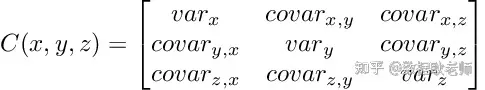
df <- read.delim("~/project/afterasale/30F276DQ/protein_detail.xls")
data.raw <- df[9:20]
data.raw=data.raw[apply(data.raw,1,sd)!=0,]

cor_df <- cor(data.raw, use = "pairwise.complete.obs",method = "spearman")
p <- pheatmap::pheatmap(cor_df, scale="none", show_rownames = T,show_colnames = T, cluster_rows = T, cluster_cols = T,display_numbers = T)


ggsave(plot=p,"~/project/afterasale/30F276DQ/spearman_correlation.pdf")
ggsave(plot=p,"~/project/afterasale/30F276DQ/spearman_correlation.png")
协方差解释
某一时刻不一定 X,Y 同向变化,;协方差是用了很多数据抵销了
多个(x-)(y-) 累加,会正负抵消。如果总体为正绝大多数为正。要把变化幅度对协方差的影响,从协方差中剔除掉
如果左右两个计算的协方差相差10000倍,数据的波动范围影响了协方差。
协方差除以标准差(变量的变化幅度) 剔除对协方差的影响。协方差标准化了,反应两变量每单位的变化程度。标准差反映了波动信息
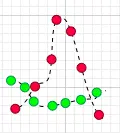
如图:左右的协方差在去除波动信息后,协方差一致。 重点剔除波动信息(偏离平均值的多少)
当他们的相关系数为1时,说明两个变量变化时的正向相似度最大,即,你变大一倍,我也变大一倍;你变小一倍,我也变小一倍。也即是完全正相关(以X、Y为横纵坐标轴,可以画出一条斜率为正数的直线,所以X、Y是线性关系的)
除以标准差就是剔除了 变化幅度
相关性矩阵
correlation distance matrix (1 − r2) 的优点,为什么不直接用距离矩阵
相关性距离矩阵 (1 - r^2) 的优点:
- 可解释性:相关性距离矩阵可以反映变量之间的线性关系程度。当r接近1时,表示两个变量高度正相关,距离接近0;当r接近-1时,表示两个变量高度负相关,距离也接近0;当r接近0时,表示两个变量没有线性关系,距离接近1。这种度量具有直观的可解释性。
- 线性关系的考虑:相关性距离矩阵可以捕捉到线性关系的强度和方向,因此对于强烈依赖线性关系的数据集可能更为合适。
相关性距离矩阵 (1 - r^2) 的限制:
- 局限于线性关系:相关性距离矩阵只能捕捉到线性关系,而忽略了非线性关系。如果数据中存在非线性关系,那么相关性距离可能无法提供准确的相似性度量。
- 对异常值敏感:相关性距离受到异常值的影响,因为它是基于相关系数计算的。异常值可能导致相关系数产生不准确的估计。
- 依赖于数据的分布:相关性距离矩阵假设数据服从正态分布,当数据不满足这个假设时,相关性距离可能不适用。
使用距离矩阵的优点:
- 不受线性假设的限制:距离矩阵不依赖于线性关系的假设,因此能够更好地捕捉非线性关系。
- 对异常值较为鲁棒:距离矩阵相对不太受异常值的干扰,因为它是基于距离而不是相关系数计算的。
- 更通用:距离矩阵的应用更加广泛,适用于各种数据类型和问题领域。
虽然 是单调的,但在 计算协方差 时,确实可能因为数值比例不一致而导致相关系数比你想象的要小。
1. 为什么会“部分抵消”
皮尔逊相关系数的分子是协方差:
对于 :
- 当 负且 时, 的变化很小(变平缓)
- 当 正且 时, 的变化很快(变陡峭)
这样一来,正区间的贡献会非常大,负区间的贡献较小,即使符号一致,它们在标准化(除以方差)时会失衡,导致最终 r 不是 1。
2. 数字例子
假设我们取 :
| 乘积 | ||||
|---|---|---|---|---|
| -2 | -8 | -2 | -8 | 16 |
| -1 | -1 | -1 | -1 | 1 |
| 0 | 0 | 0 | 0 | 0 |
| 1 | 1 | 1 | 1 | 1 |
| 2 | 8 | 2 | 8 | 16 |
结果接近 1,但 不是 1,因为 的增长率和 不成固定比例,导致最佳拟合直线有残差。
- 是单调的,所以符号不抵消,相关性很高
- 但它是曲线,每段的斜率不同,和直线的比例关系不一致
- 计算协方差时,本质上是在找一个单一斜率来匹配全局趋势,这个斜率无法同时贴合平缓和陡峭的区域 → r 略小于 1
相关性检验的非零假设?=0
因为总能得到一个相关性,但是这个相关性是否是因为随机抽样的得到的呢
在进行相关性检验时,通常使用的是Pearson相关系数来衡量两个连续变量之间的线性相关性。使用t检验来评估Pearson相关系数是否显著不同于零。
在这种情况下,t检验的零假设(H0)是:总体的Pearson相关系数等于零,即样本数据中观察到的相关性是由随机因素引起的,而不是真正的线性关系。非零假设(H1)则是:总体的Pearson相关系数不等于零,即样本数据中存在着真实的线性相关性。