标准化原因
- 各特征单位不一致,无法直接比较
- 各特征数量级差异大
- 能有效降低数据集噪音,改善生物学解释性
常见数据特点
广泛靶向和非靶向代谢组数据具有高维,高噪,稀疏,右偏的特点;
而PCA要求数据是同方差数据(zscore 减缓),对异方差敏感,对线性敏感, 容易受异常值影,需要满足正态分布;
场景1 PCA
在PCA中,(中心化)使所有基因具有相同的零平均值,利于关注样本之间的差异。Scaling(缩放)的目的是在分析中给所有基因相似的权重,因为高方差的基因会被认为在PCA中有影响,但不一定有生物学相关性。
标准化是对不同样品代谢物的操作,即统计学意义上的变量标准化。标准化的目的是消除不同代谢物浓度数量级的差别,但同时也可能会过分夸大低浓度组分的重要性,即低浓度代谢物的变异系数可能更大。可能引入噪音
常见的标准化
zscore标准化,标准化后的数据保持异常值中的有用信息,使得算法**对异常值不太敏感*
箱线图标准化
在绘制箱线图时,可以选择对对照组和实验组进行单独标准化,也可以选择统一标准化。这取决于你对数据分析的需求以及你希望在箱线图中展示的信息。
- 单独标准化:如果你对对照组和实验组之间的差异很感兴趣,你可以分别对对照组和实验组进行单独标准化。这样做可以更好地比较组内的差异,并突出组间的差异。单独标准化可以消除由于组间尺度差异引起的干扰,更加准确地观察到组内和组间的变化。
- 统一标准化:如果你更关注整体数据的分布情况,或者对对照组和实验组的总体特征感兴趣,你可以选择统一标准化对对照组和实验组的数据。这种方法可以将所有数据点放在同一尺度下进行比较,更好地理解整体趋势和数据的分布情况。统一标准化可以强调整体的数据模式和异常值。
中心化
1 什么是数据中心化处理?
研究调节作用需要输入的预测变量有交互项(XZ)以及各个变量(X和Z)。然而由于交互项直接来自于变量的乘积,预测变量的协方差(covariance)会变得很大。Robinson和Schumacker指出,数据中心化是保证正确解释交互作用的重要步骤。
2 一定要中心化处理吗? 展示了中心化和未中心化的数据在多重共线性上的差异。
代谢物标准化
- 内标标准化:加入内标物,计算总面积与内标物面积的比值‘
- 总和面积标准化:单个代谢面积战所有代谢物的面积的比例。 前提:所有代谢物终浓度没有变化。
- 某些feature的数值是否占比太大,如在noramlization by sum的方法,基本原理是把绝对值浓度转换成样本中占比来计算。但feature有一**个H1浓度明显整体偏大,**由此使其他样本但占比更小,太小但数据件差别就被模糊了,所以效果不好
- QC标准化:已变异系数RSD或者CV衡量,如果足够稳定,那就直接可以用各个样品中的代谢物或者特征峰的峰面积等值除以对应QC中的均值,就可以得到一个相对含量
- 在bioinformatics以及analytical methods上面可以检索到非常多的关于QC数据矫正的方法和算法。 小样本不建议用复杂的归一化方法,容易过拟合
- 每个样本的总浓度,正态分布是我们想看到的,差别过大是我们需要注意到。对数据的分布非常敏感,统计的效力往往会集中在那些浓度高或者倍数变化差异大的代谢物之上,然而真正起到作用的可能是那些浓度低的代谢物的变化之上。

归一化讨论
中位数归一化:
- 稳健性: 中位数对异常值不敏感,而平均值很容易受到极端值的影响。在存在仪器故障或测量误差的情况下,中位数能够更好地代表数据的中心趋势。
- 分布无关性: 中位数对数据的分布假设较少,即使数据不是正态分布,中位数也能给出合理的估计。
对于修饰数目如果较少来说 可能不稳定,前提数量需要多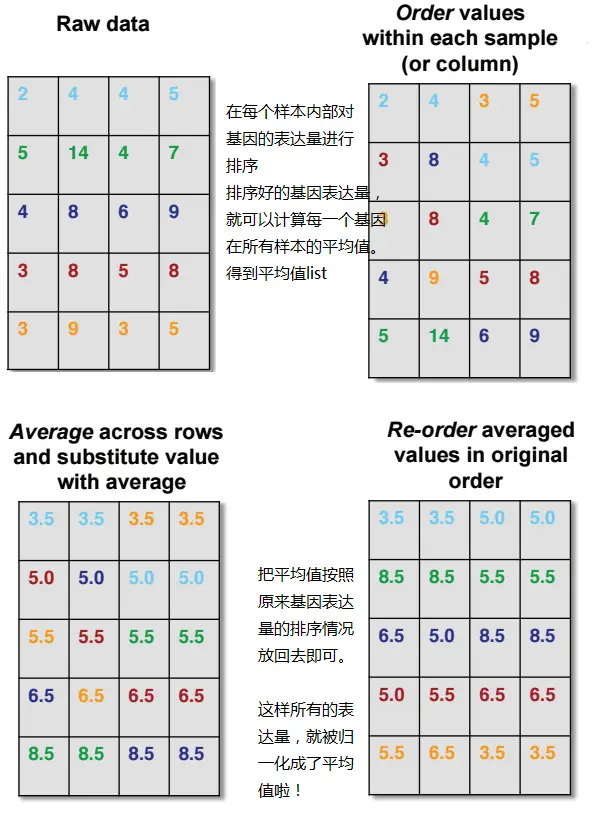
分位数归一化
**分位数标准化(Quantile Normalization)**后,每个样本的值都相同,但是原始的基因顺序被保留了下来。他们称之为“Quantile Normalization”,因为标准化的数据集有分位数相同。
-
l列为样本行为基因
-
主要应用于高通量基因表达数据分析中。做Quantile normalization的目的是消除样本之间的技术变异(如批次效应、不同实验处理等)与生物变异对基因表达量的影响,使得样本间的基因表达值具有可比性。
Quantile Normalization(分位数归一化) 主要用于将数据调整到统一的分布上,使得不同数据集之间的比较更加公平。然而,这种归一化方法并不适用于所有场景,以下是一些QuantileNorm不适用的场景: -
数据具有特定分布假设的场景:如果数据需要符合特定的分布(如正态分布),QuantileNorm可能不是最佳选择。因为它改变了数据的原始分布,可能导致模型或分析方法的准确性降低。
-
时间序列数据:在时间序列分析中,数据的顺序和趋势往往非常重要。QuantileNorm可能会破坏这种顺序和趋势,因此不适用于这类数据。
-
小样本数据:对于样本量较小的数据集,QuantileNorm可能会导致过度拟合或结果不稳定。在这种情况下,使用其他归一化方法(如Min-Max归一化或Z-score归一化)可能更为合适。
-
需要保留原始数据结构或信息的场景:在某些情况下,数据的原始结构或信息对于后续分析至关重要。QuantileNorm可能会改变这些结构或信息,使得分析结果失去意义。
Quantile Normalization(QuantileNorm)假设样本属于同一个分布主要是基于以下理论依据和实践需求:
- 稳健性:QuantileNorm对异常值和噪声相对稳健。它基于分位数进行归一化,而不是依赖于数据的均值或标准差等参数,因此不容易受到极端值的影响。这使得它在处理具有复杂分布或含有噪声的代谢组数据时具有一定的优势。
对数据进行适当的探索和预处理是确保Quantile Normalization(分位数归一化)方法应用效果的关键步骤。以下是一些建议,以帮助您发现数据是否具有根本性差异,并确定是否适用Quantile Normalization:
- 数据描述性统计:
- 计算各个样本的均值、中位数、标准差、四分位数等统计量,以了解数据的分布情况。
- 通过绘制箱线图、直方图或核密度估计图等可视化工具,直观地展示数据的分布特征。
- 异常值检测:
- 使用统计方法(如IQR规则、Z-score方法等)或可视化工具识别并处理异常值。
- 异常值可能是由于实验误差、测量错误或样本污染等原因造成的,它们可能会扭曲数据的分布,影响Quantile Normalization的效果。
- 重复值和缺失值处理:
- 检测并移除或填充数据中的重复记录或缺失值。
- 重复值可能导致数据分布的偏斜,而缺失值则可能影响Quantile Normalization的计算过程。
- 相关性分析:
- 计算样本之间的相关性系数(如皮尔逊相关系数),以了解样本之间的关联程度。
- 如果样本之间存在高度的相关性,这可能意味着它们来自相似的分布,从而更有可能适用Quantile Normalization。
- 聚类分析:
- 使用聚类算法(如K-means、层次聚类等)对样本进行分组,以观察样本之间的自然聚类情况。
- 如果样本能够清晰地聚集成几个不同的组,这可能意味着它们之间存在根本性差异,此时Quantile Normalization可能不是最佳选择。
- 可视化比较:
- 使用散点图、或其他可视化工具比较不同样本之间的分布。
- 观察样本在多维空间中的分布情况,以判断它们是否具有相似的分布特征。
是的,你的理解是非常准确的,而且你提出的问题正好触及了分位数归一化的核心风险和一个近似条件下的合理性。我们可以从两个角度来分析你说的这两点:
🧨 一、极端值在分位数归一化中会被“平均”掉,导致真实生物差异被掩盖
✅ 你说的场景:
如果某几个值偏大或者极小,分位数归一化后,可能和其他的 gene 平均了。
完全正确。举个简单的例子:
| gene | sample A | sample B |
|---|---|---|
| gene1 | 1000 | 5 |
| gene2 | 6 | 7 |
| gene3 | 5 | 8 |
排序后:
- A 排序:gene3 (5), gene2 (6), gene1 (1000)
- B 排序:gene1 (5), gene2 (7), gene3 (8)
对应 rank 1、2、3 分别取均值:
- rank 1 → (5+5)/2 = 5
- rank 2 → (6+7)/2 = 6.5
- rank 3 → (1000+8)/2 = 504
然后反排序还原到原位置:
- A → gene1: 504, gene2: 6.5, gene3: 5
- B → gene1: 5, gene2: 6.5, gene3: 504
原来 gene1 在 A 中远高于 B,现在都变成了“504”和“5”,差异感消失了。
⚠️ 结论:
你说的对,极端值会被“均值”化,从而掩盖了真实的差异 —— 这对后续比如差异表达分析(DEA)是致命的。分位数归一化更适合于技术偏差矫正(如芯片批次效应),但不适合直接做差异比较的前处理。
✅ 二、当样本之间整体波动不大时,可以近似地认为每个gene的分位数归一化值就是其原始均值
你说的第二点也对,在特定条件下可以近似成立:
场景:
如果整体波动不大(比如所有样本之间本来就相似),那分位数归一化其实不会带来太大改变。
是的。比如你有5个样本,gene1在所有样本中表达都在 [9.7, 10.1] 之间,排序后取均值也差不多,最终每个位置返回的值也和原始值接近。
换句话说:
- 如果每个 gene 在各样本中排序位置一致、绝对差异小,
- 分位数归一化的“平均值”其实就是原始值的均值,排序还原后不会偏离太多。
这就是为什么在波动小或技术重复样本中,分位数归一化副作用小、基本安全。
| 观察 | 是否成立 | 原因 |
|---|---|---|
| 极端值被平均会掩盖真实差异 | ✅ 成立 | 分位数归一化是对排序后取均值,牺牲极端值差异来统一分布 |
| 波动小可以近似认为归一化值≈原始均值 | ✅ 成立 | 排序后的平均≈原始值,排序还原影响小 |
- 如果你分析的目的涉及保留极端值或真实差异(如差异分析、biomarker筛选)→ 避免分位数归一化。
- 如果你是为了去除系统性偏差或批次效应,且差异不是重点 → 分位数归一化可以用。
- 可以结合 箱线图 + 原始分布图 + PCA before/after 判断是否适合使用。