OPLS-DA的改进
PLS回归的目标是找到两个矩阵(X和Y)之间的线性关系,同时考虑X和Y的内部结构。OPLS-DA通过将PLS分解为与Y相关的成分和与Y无关的正交成分来提高模型的性能。这种分离使得模型更加简洁和解释性更强。
- 与Y相关的成分:这些成分捕捉了X中与目标变量Y相关的系统方差。
- 正交成分:这些成分捕捉了X中与Y不相关的方差。
OPLS-DA的实现过程
-
标准化数据:对X和Y进行标准化处理,以消除变量尺度的影响。
-
构建PLS模型:使用PLS方法找到X和Y之间的最大共变的投影方向。
-
正交化:将X分解为与Y相关的部分(预测成分)和与Y无关的部分(正交成分)。
-
迭代过程:
- 提取与Y相关的成分:从X中提取与Y相关的预测成分。
- 提取正交成分:从剩余的X中提取正交成分,使得这些成分与Y不相关。
- 更新X:从X中移除已提取的成分,重复上述步骤,直到达到预定的成分数量或达到某个停止准则。
-
模型评估:通过交叉验证或外部验证评估模型的性能。常用的评估指标包括预测准确性、敏感性、特异性等。
协方差越大,表示两个变量之间的线性关系越紧密。在PLS(Partial Least Squares)模型中,我们通过最大化协方差来寻找最佳的投影方向,以便在高维数据中找到解释变量 和响应变量 之间最强的线性关系。
PLS中的协方差最大化
在PLS模型中,我们试图通过以下步骤来最大化 和 之间的协方差:
-
计算协方差:
- 对于两个变量 和 ,协方差计算公式为: \
-
主成分提取:
- 在PLS中,我们通过寻找一个或多个方向(主成分),使得这些方向上的 和 之间的协方差最大化**
-
优化目标:
- 目标是找到使 X \) 和Y$ 之间的协方差最大化的主成分方向。
如何最大化协方差
PLS模型通过以下数学过程来实现协方差的最大化:
-
初始化:从数据中选择一个方向 ,使得该方向上 和 的协方差最大。
-
计算主成分:
- 在每一步中,PLS寻找一个主成分 ,使得 在 中的投影与 的投影之间的协方差最大化。
-
计算相关性:
- 主成分 可以通过对 和 的协方差矩阵进行特征值分解来计算。
- 这意味着我们计算出方向 ,它能最大程度上解释 和 之间的相关性。
-
正交化:
- 在提取了一个主成分后,我们从数据中移除与该主成分相关的部分,然后在剩余的部分中重复上述过程,以提取更多的主成分。
PLS模型的基本原理
- 线性回归与主成分分析的结合:
- PLS结合了主成分分析(PCA)和线性回归的特点。在每一步中,PLS寻找能同时解释 和 的方向(主成分),同时确保这些方向能最大化 和 之间的相关性。
Squares)中,负荷矩阵(loading matrix)的含义和作用是非常重要的。以下是对负荷矩阵的详细解释,以及它的意义和如何解释负荷值。
好,我们分两步来拆开 OPLS-DA(Orthogonal Partial Least Squares Discriminant Analysis)里的流程,结合你的两个问题,把“为什么要两次 SVD”和“最后怎么得到 X→Y 的线性关系”解释清楚。
- PLS结合了主成分分析(PCA)和线性回归的特点。在每一步中,PLS寻找能同时解释 和 的方向(主成分),同时确保这些方向能最大化 和 之间的相关性。
-
目标:在高维 X(特征矩阵)中找出与 Y 高度相关的方向(预测成分),并把与 Y 无关的变化(正交成分)分离出去。
-
核心步骤:
- 找到一个 X 的方向 (权重向量),使得 X 投影到这个方向(得分向量 )后,与 Y 尽量相关。
- 同时计算 Y 在自己空间里的方向 ,得到得分向量 。
- 用 建立 X 与 Y 的线性关系。
- 把与 Y 无关的 X 部分剔除(正交信号校正),迭代提取多个成分。
你的第一个问题:为什么要 两次 SVD
第一次:从 的协方差矩阵取方向
-
我们先构造协方差矩阵:
-
对 做 SVD:
- 的第一列给出了 X 方向的最大相关向量
- 的第一列给出了 Y 方向的最大相关向量
但是,这里只是基于协方差的最大相关方向,还没直接得到最终的 t 和 u,因为:
- 是 X 空间的方向,但我们还要确保 与 Y 的投影 真正匹配。
- 在实际数据中,Y 可能是多维的(比如 one-hot 编码的类别),t 需要重新与 Y 对齐。
第二次:在 和 之间再做 SVD
-
得到 后,我们把 Y 在它自己的空间中找到一个方向,使得这个方向与 t 的相关最大。
-
换句话说,是在 和 之间做:
的 SVD,以得到 (Y 的得分向量)。
-
这样做的意义是:
- 保证 t 与 u 是在各自空间中“最强相关”的一对投影(典型相关分析的思想)。
- 为后续计算回归系数 做准备。
- 这也是把 PLS 回归的“交替提取权重”过程显式化。
你的第二个问题:计算出 后,怎么建立最终的 X→Y 线性关系
在 OPLS(包括 PLS1/PLS2)中,建模关系是:
-
X 模型(得分-载荷分解):
其中:
- (得分向量)
- (载荷向量)
- E 是残差
-
Y 模型(得分-载荷分解):
其中:
- (Y 载荷向量)
- F 是残差
-
回归系数的推导:
-
把 代入 得:
-
所以整体回归系数矩阵:
当有多对成分时,(PLS 标准公式)。
-
最终预测:
-
-
OPLS-DA 特别之处:
- 它会先提取预测成分(与 Y 有关的部分),然后分离出正交成分(与 Y 无关但存在于 X 的变化)。
- 正交部分从 X 中剔除后,再用预测成分建线性模型 → 提高判别清晰度。
- 第一次 SVD:在 的协方差空间里找最大相关方向(初步权重)。
- 第二次 SVD:在 t 和 Y 中再找最匹配的方向(得 u),确保得分向量对齐。
- t, u → 最终线性关系:通过载荷向量 回推,得到 ,从而建立 的线性预测。
-
计算初始权重向量 和 :
- 选择最大协方差方向。
-
计算预测成分 和 :
-
计算负荷 和 :
-
更新矩阵 和 :
-
重复步骤:
- 继续计算新的成分,直到满足停止条件。
so key还是SVD
- 两者共同帮助评估模型的整体效果,但它们分别关注不同的方面:输入数据的解释和输出数据的预测。
在PLS(Partial Least Squares)回归模型中,计算主成分得分矩阵 和响应变量的主成分得分矩阵 的主要目的是为了获得回归系数矩阵 ,从而建立预测模型。这个过程并不是简单的最小二乘回归,而是结合了降维和回归的特点,来更好地处理高维数据中的共线性问题。
为什么不是简单的最小二乘回归?
在PLS模型中,直接使用最小二乘回归并不能有效地处理以下问题:
-
数据的高维性和共线性:
- 在高维数据中,特征之间的共线性可能导致最小二乘回归模型的不稳定和过拟合。PLS通过降维来解决这些问题,使得模型在处理数据时更为稳定。
-
预测能力和解释能力:
- PLS通过主成分分析提取了数据中最重要的信息,这有助于提高预测能力。最小二乘回归仅仅对特征进行线性拟合**,不考虑特征之间的内在结构。**
-
建模复杂性:
- PLS模型通过同时优化输入特征和响应变量的主成分,使得模型能够更好地解释数据中的关系。最小二乘回归不具备这种能力,尤其是在特征维度很高的情况下。
OPLS-DA的模型验证 permutation Test图
- OPLS适合处理多重共线性
- predi=50% 前10个组分需要达到
模型验证 permutation Test 图的横坐标表示模型的准确率,纵坐标表示200次 permutation Test 中200个模型的准确率的频数,箭头表示本OPLS-DA模型准确率所在的位置。
其中R2X和R2Y分别表示所建模型对X和Y矩阵的解释率, Q2表示模型的预测能力,理论上R2、Q2数值越接近1说明模型越好,越低说明模型的拟合准确性越差。
通常情况下 , R2、Q2高于0.5较好,高于0.4即可接受。
从图中可以看出Q2为0.994 , R2Y为1 , R2X为0.685 , Q2和R2Y的P值均为0.005 ,说明 permutation Test 中只有1个随机分组模型结果优于本OPLS-DA模型,一般情况下P<0.05时模型最佳。
置换检验解释率P值大于0.2,能说明模型过拟合吗?
置换检验解释率的P值大于0.2可能表明模型未能显著地超越随机模型,但不能直接说明模型存在过拟合。过拟合是指模型过度地适应了训练数据中的噪音或特定特征,导致在新数据上的预测能力下降。
置换检验通常用于检验模型是否能显著地解释数据中的模式或结构,如果P值大于显著性水平(通常为0.05或更小),则表示模型的解释能力可能不显著。 表示没有显著差异
-
VIP值的阈值:
- 常规的VIP值阈值是1,表示变量对模型的重要性超过平均水平。
- VIP值 > 1:变量对组间区分有较强的贡献。
- VIP值 > 2 或更高:说明变量对模型的贡献非常显著。
- VIP值 > 4:极高的重要性,表明该变量对于区分组间差异是关键的。
-
VIP > 4 的特殊性:
- VIP值如此高的变量在统计上通常是非常显著的。
- 它可能是模型中主要的驱动变量,用于区分组间的差异。
OPLS-DA建模时,将X矩阵信息分解成与Y相关和不相关的两类信息,其中与Y相关的变量信息为预测主成分,与Y不相关的变量信息为正交主成分,通过去除不相关的差异来筛选差异变量。
PLS偏最小二乘,PLS是一种统计模型。是一个回归方程。 (Partial Least-Squares,PLS)基于预测变量和响应之间协方差的潜在变量回归方法,已被证明可以有效地处理具有多重共线预测变量的数据集,如质谱检测。
对于PLS-DA的评价:有监督模型容易出现的问题过度拟合。因此需要对模型进行检测。
R²Y 和 Q²Y 的含义
-
RY2 这是模型对响应变量 YYY 的解释能力,表示自变量 X Y之间的关系有多强。它是通过比较模型预测的 YYY 值与实际观察到的 YYY 值之间的差异来计算的。高 值表示模型在训练集上的拟合较好,能够较好地解释数据中的变异。
-
QY2 是通过交叉验证来评估模型的预测能力,它反映了模型在新的(未见过的)数据集上的预测性能。通常,交叉验证会将数据划分为多个子集,逐一用不同的子集来训练和测试模型,然后通过计算预测误差来。高的 值表示模型具有较强的泛化能力。
R²Y 高而 Q²Y 低的情况:
-
过拟合:
-
数据问题:
- 训练集的数据可能包含不具代表性或偏倚的样本,导致模型在训练集上拟合得很好,但在实际应用中无法有效推广。
- 另外,数据的多样性不足或噪声较多,也可能导致 RY2R^2_YRY2 高,而 QY2Q^2_YQY2 低。
-
模型复杂度过高:
- 如果模型使用了过多的成分或参数(比如过多的潜在变量),即使模型在训练集上具有很好的拟合度,它也可能对训练数据的噪声进行了拟合,从而丧失了对新数据的预测能力,导致 低。
-
数据分布不均或不平衡:
OPLSDA 错误可能性
当我们拿到一个分的很开的OPLS-DA模型时,切莫匆忙得出“两组之间有明显差异”的结论。因为这个模型极有可能是一个过拟合的模型。
那么如何才能判断一个OPLS-DA模型的好坏以及如何判断OPLS-DA模型是否过拟合呢?
过拟合的模型导致 VIP值可能对某些变量高估。
OPLS-DA作为一个有监督的模型,意味着模型使用了两组分类信息作为分类的Y变量,也就是说模型事先知道哪些样品是哪组的,然后开始建模,其第一主成分(也叫预测主成分)呈现的是两组之间的差异信息。其第二主成分呈现的是同组内的差异信息,故而我们看到的图大概率都是能分得很好的。
第一主成分(t1)
- 最大化Y变量的相关性:第一主成分t1是从自变量矩阵X中提取的,其目的是最大化与因变量矩阵Y的相关性,t1是找到能够最有效地区分不同类别(由Y变量定义)的方向。
- 解释X变量中的变异:第一主成分还解释了自变量X中最大的一部分变异。这意味着t1捕捉了数据中最主要的变化模式,同时与分类信息Y有强关联。
第二主成分(t2)
- 正交于第一主成分:第二主成分t2也是从自变量矩阵X中提取的,但与t1正交(不相关)。这意味着t2捕捉的是X中与第一主成分不重叠的变异。
- 解释额外的X变量变异:t2解释了X中与t1正交的部分变异,通常是次要的变化模式。这些模式对Y的解释可能没有t1强,但仍然有助于更全面地理解数据结构。
- 提高模型解释力:在散点图中,t2可以帮助进一步区分类别,特别是在t1不能完全分离不同类别的情况下。t2提供了额外的维度来观察数据,从而提高模型的解释力。
第一主成分(t1)
- 反映组间差异:OPLS-DA的设计初衷就是为了最大化类别之间的差异。在模型中,第一主成分(t1)是通过优化选择的方向,使得类别标签(Y变量)在这个方向上的分离最大化。
- 解释最大变异:在OPLS-DA中,t1主要捕捉的是与类别信息(Y变量)相关的变异。这意味着t1方向上的变异主要是那些能将不同类别的样本区分开的特征。
- 类间分离效果显著:在得分图上,t1轴上的样本分布通常显示出不同类别的显著分离,即不同类别的样本在t1方向上会形成不同的聚类。
第二主成分(t2)
- 反映组内差异:第二主成分(t2)是正交于t1的方向,它捕捉的是与第一主成分无关的变异。这部分变异通常与组内差异相关。
- 解释次要变异:t2解释的是自变量X中剩余的变异,这些变异虽然不与类别信息(Y变量)直接相关,但仍然存在于数据中,可能是由于样本的个体差异、实验噪声等因素引起的。
- 类内分布特点:在得分图上,t2轴上的样本分布显示的是同一类别内部的变化,即同一类别的样本在t2方向上可能有不同的分布特征,但不会显著影响类间的分离。
-
组间差异(t1):
- 主成分t1:最大化了不同类别样本之间的差异,因此在t1方向上可以观察到明显的类间分离。
- 解读:如果t1方向上各类别样本的分布明显不同,则表明模型在类别区分上是有效的。
-
组内差异(t2):
- 主成分t2:捕捉的是与类别区分无关的剩余变异,通常是样本内部的差异和噪声。
- 解读:如果同一类别样本在t2方向上有较大分布,则表明该类别内部存在显著的个体差异或实验噪声。
在实际的生物医学研究中,例如代谢组学或蛋白质组学:
- t1(组间差异):可以帮助研究者识别出不同疾病状态或处理条件下的显著差异特征。
- t2(组内差异):可以帮助研究者理解同一疾病状态或处理条件下的个体差异,揭示样本的异质性。
OPLSDA 构建失败的原因
因为第一正交成分不显著。通俗解释来说,就是在建立模型时,第一成分无法很好地解释原始数据中的方差(变量间的差异),无法有效地对不同类别的样本进行区分。这种情况可以出现在数据尺度差异较大、存在较多噪声或冗余变量等情况下。
解决这种情况的方法可以包括:
-
数据预处理:在进行 OPLSDA 模型构建之前,可以对原始数据进行基础预处理,例如数据标准化、缺失值填充等操作,以有效降低噪声干扰和变量冗余。
-
特征筛选:对于存在大量变量的高维数据,可以使用特征选择的方法来选出最具有区分性的变量作为分析的依据,从而减少模型参数的数量,增加模型的和可解释性。
-
数据质量问题:第一主成分不显著可能是因为数据集本身的问题,比如数据缺失、异常值等,这些问题可能会导致模型训练结果不准确
-
模型设定问题:在建立 OPLS DA 模型时,如果模型参数设置不合理,比如选择的变量过多或过少,可能会导致第一主成分不显著。
-
样本数量不足:如果数据集中样本数量不足,可能会导致第一主成分不显著,因为样本数量过少可能导致数据集中的噪声影响主成分分析的结果。
-
第一主成分不显著的意思:无法解释原始数据的方差,无法有效区分不同组。
-
- 软件自动选择主成分的个数。OPLS-DA失败,是因为第一成分没有意义。(没有意义可能是预测能力过低)会观察到。原因:样本过少。解决方法:1. 增加样本数 2.进行特征筛选
没有意义的原因:
- 残差平方和过大:残差平方和(Residual Sum of Squares, RSS)过大表明模型未能很好地拟合数据,可能因为模型没有捕捉到数据中的主要变异来源。这样第一主成分的解释力就会很低,导致其没有意义。
- 数据预处理不当:数据在进行OPLS-DA之前通常需要进行预处理,如标准化等。如果数据预处理不当,可能导致模型的主成分无法有效解释数据中的变异。
- 数据中噪声过多:如果数据中噪声过多,主要成分可能会被噪声淹没,导致第一主成分没有意义。噪声可以来自实验误差、环境干扰等。
- 样本之间的变异过大:如果样本之间的变异过大,超出了模型的解释能力,可能导致第一主成分无法有效地区分不同组别。
- 组间差异不显著:如果不同组之间的差异本身就不显著,模型难以找到有效的分离主成分,导致第一主成分解释力不强。
预测的数据将会和原始数据作对比得到预测残差平方和(Predicted residual sum of squares, PRESS)。为方便起见。Q2越大表示模型的预测能力越好。对于生物学样本,Q2≥0.4是比较理想的,Q2≥0.2往往也可以接受,只是模型比较弱。软件在自动建模(Autofit)时,会根据Q2决定模型所用的主成分或Orthogonal component个数(OPLS-DA模型)。当Q2停止增长时,模型将不再增加主成分。
Q2:根据残差平方和预测能力
- Corr.Coeffs./p(corr) (Correlation Coefficient),是样本得分值t和变量X间的相关系数-Corr(t, X),代表了变量的可靠度。该值没有固定阈值,通常设定对应的P值 < 0.05。
- VIP (Variable importance in the projection),为变量对模型的重要性,描述了每一个变量对模型的总体贡献,通常设定阈值为VIP >1。
进行OPLS-DA建模分析,模型的质量用7折交叉验证(7-fold cross validation)进行检验;然后用交叉验证后得到的**R2Y(模型对分类变量Y的解释度)和Q2(模型的预测性)
**对模型有效性进行评判;最后通过置换检验(permutation test),随机200次改变分类变量Y的排列顺序得到不同的随机Q2值,从而对模型有效性做进一步的评估
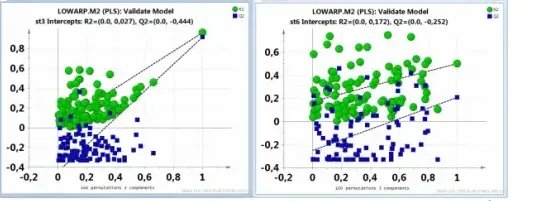
permutation test(置换检验),以确定模型是否过拟合。一般需检验模型的Q2值和R2值。对于Q2,要求置换检验结果的在y轴上的截距不超过0.05,方可认为模型没有过拟合。置换检验的基本原理:将真实分类结果(标签)屏蔽,重新随机赋予分类结果(标签),再进行建模。
Corr.Coeffs./p(corr) (Correlation Coefficient),是样本得分值t和变量X间的相关系数-Corr(t, X),代表了变量的可靠度。该值没有固定阈值,通常设定对应的P值 < 0.05。
R2Y=0.909,Q2Y=0.672,说明模型的可解释很强,可预测性尚可。根据经验,Q2Y最好不要低于0.4。
除了采用交叉验证这种内部验证的形式之外,我们还可以采用置换检验(permutation test)这种外部验证的方式。
总结一下就是两点:
- 原始的R2Y和Q2Y(最右边的两个点)总是大于左边那些置换后对应的值(左边那些散点)。 其他的七折交叉都对原始的数据有一定的偏离
- 看截距,根据经验判断,优秀的模型R2Y的截距不超,0.3-0.4,Q2Y的截距不超过0.05(通常为负值)
置换检验图 外部验证:数据打乱,然后建模
VIP的意义与Loading Score非常类似,物质的VIP越大,那么这个物质对样本之间能在(O)PLS-DA图中主成分1上分开的贡献就越大,去掉这些物质,样本在图上就区分不开了。
纵坐标是模型分类效果出现的频数,即本模型对数据进行200次随机排列组合实验,若Q2 的p= 0.02,说明在此次Permutation检测中共有4个随机分组模型的预测能力优于本OPLS-DA模型,若R2Y的p= 0.545,说明在此次Permutation检测中共有109个随机分组模型其对Y矩阵的解释率优于本OPLS-DA模型。一般情况下,p< 0.05 时模型最佳。
置换检验
p
ermImodels are computed after random permutation of the Y response and the proportion of the corresponding Q2Y values above the Q2Y from the initial model (without permutation) are computed and indicated in the summary statistics (which are not the same) as the pQ2 value.
This proportion is expected to be low for a valid (significant) model. )(随机打乱应该没啥模式)
For example, ifpermIis set to 20 (default) and all Q2Y values of the models with randomized responses are below the Q2Y from the initial model, pQ2 =() (1 + 0) / 20 = 0.05. It is very important thatpermIis set to at least 20 and that the resulting pQ2 is below 0.05 for an (O)PLS(-DA) model to be used
oplsda <- opls(df, as.factor(df$y), predI = 1, orthoI = NA, permI = 0)
偏最小二乘回归
x1 x2 求t
通过t对y回归
- 应用数据特征:数据变量多,样本少;变量之间贡献性高
实现
- 首先分别利用x1 x2 x3 线性组合出u1,y1 Y2 y3线性组合出v1
- 要求u1,v1 相关性尽可能大;保持尽可能大的方差
- 建立u1和y的回归方程
- 从而转化为回归问题,X Y的矩阵的特征向量示所求的相关系数
- xnew=X-回归得到的ynew=Y-回归得到的值,重新对xnew ynew回归预测,交叉验证
- 交叉验证:去除第i个点,重新建模,然后计算i带入减去第i 个样本的残差值
参考
特征选择
使用 biosigner 可以通过以下步骤进行:
-
输入基础数据和响应变量,例如样本亚群,生物特征等;
-
进行特征筛选,包括基于 univariate 或 multivariate 统计分析的方法、基于机器学习的方法、基于领域知识的方法等;
-
进行特征筛选后,使用 OPLSDA 等模型进行分析和建模,得到最佳分类或预测模型。
- 准备数据:导入基础数据和响应变量,可以使用 data.frame 或 matrix 格式。其中,样本数据应该按行排列,特征数据应该按列排列,而且特征的列名和样本的行名应该分别和响应变量对应。
data <- read.csv("data.csv", header = T, row.names = 1) y <- read.csv("response.csv", header = F)- 特征选择:使用
selectVars()函数进行特征筛选。该函数使用 univariate 或 multivariate 统计分析方法进行特征选择,并返回最优的特征集合。可以指定特征的数目或者筛选阈值来进行特征选择。
library(biosigner)
set.seed(123)
sig <- selectVars(t(data), y, method="ttest", B=100, nb.sv=2, stat.filter=0.05, cor.filter=0.8)
其中,
method参数表示使用的特征选择方法,可以选择 ttest(双样本 t 检验)、wilcox.test(Wilcoxon-Mann-Whitney U 检验)等方法。nb.sv参数表示正交化矢量的数目,stat.filter表示假阳性率的设置,cor.filter表示特征之间的相关性筛选阈值。B参数用于进行 bootstrap 操作,并计算 p 值等统计指标。- 建模和性能评估:使用
opls()函数进行建模和交叉验证,使用perf()函数对模型的性能进行评估和比较,例如查看模型的 R2Y 和 Q2 值,画出 VIP 图等。
model <- opls(data[,sig$selected],y, ortho=2)
perf(model)
其中,
selected参数为selectVars()函数返回的最优特征组合。
Q2Y最好不要低于0.4。
除了VIP值,还可以求最终模型中各变量的系数(又称PLS-BETA值)和Corr.Coeffs,以及二者对应的p值**。**
可综合VIP值和Corr.Coeffs值筛选变量(V-Plot),或者综合PLS-BETA值和Corr.Coeffs值筛选变量(S-Plot)。
-
原始的R2Y和Q2Y(最右边的两个点)总是大于左边那些置换后对应的值(左边那些散点)。
-
看截距,根据经验判断,优秀的模型R2Y的截距不超,0.3-0.4,Q2Y的截距不超过0.05(通常为负值)
在很多的实际的项目中,尤其是临床样品的检测项目,能满足两条斜线的斜率为正,且Q2Y的截距不超过0.05就很好了。所以可以看出图2的置换检验结果also good,但不是很理想,有一定的过拟合,要警惕结果的假阳性。
- Peak intensities(峰强度)是质谱图中峰的相对强度或高度,反映了代谢产物在质谱中的信号强度。相对丰度
- Spectral bins:代谢组学中的”谱段”(spectral bins)是指在质谱图中的不同质荷比范围内的数据区域。这些区域通常对应于不同的代谢产物或化合物的离子片段。通过分析这些谱段,研究人员可以了解样本中不同代谢产物的存在和相对丰度,从而识别可能与特定生物学过程或疾病相关的生物标志物。
数据分析
检查数数据
-
检查有无特殊字符
-
检查有无缺失值
-
填充
-
数据缺失的原因
- 仪器检测不出来
- 提峰算法的限制
- 解卷积解不出来不能将重叠的峰全部提出来
缺失值过滤
根据样本或分组内缺失值的比例。例如:将QC样本中缺失超过50%的峰去除;或将样本中缺失**值超过80%的峰去除。
https://www.omicsolution.org/wukong/NAguideR/ 代谢组 包NormalizeMets
偏离值过滤
RSD<0.3
归一化
各样品间方便比较
1. 内标标准化:内标标准化通常选择RSD最小的内标(Internal Standard, IS),用样品中代谢物的峰面积()除以该样品中对应的内标物的峰面积
2. 面积和标准化面积和标准化是将样品中所有代谢物的峰面积相加,得到该样品代谢物峰面积的总和
logtransform
右偏,右边尾长,平均数靠近右侧,平均数大于中位数大于众数,正偏态。右偏分布是指数据中的大多数观测值集中在数值较低的一侧,同时存在一些极端值或离群值偏向于数值较高的一侧,导致分布呈现向右延伸的特征。这种分布也被称为正偏态分布。
在代谢组学中,质谱和核磁共振(NMR)等技术产生的数据常常呈现右偏分布的特征。例如,在质谱数据中,存在一些代谢物的浓度或强度较高,而大多数代谢物的浓度或强度较低,这导致了右偏的分布特征。
与传统多元线性回归模型相比,偏最小二乘回归的特点是:
(1)能够在自变量存在严重多重相关性的条件下进行回归建模; ?这是如何解决的
(2)允许在样本点个数少于变量个数的条件下进行回归建模;
(3)偏最小二乘回归在最终模型中将包含原有的所有自变量;
(4)偏最小二乘回归模型更易于辨识系统信息与噪声(甚至一些非随机性的噪声);?去除相关的信息吗
(5)在偏最小二乘回归模型中,每一个自变量的回归系数将更容易解释。
缺点
- 不适用于非线性数据;
- 预测精确度较低;
- 可能会出现过度拟合(下面的正则化模型可以抵消这个影响);
- 分离信号和噪声的效果不理想,在使用前需要去掉不相关的特征; 使用前需要去掉
不了解数据集中的特征交互
https://blog.csdn.net/weixin_44333889/article/details/119420315
,多重共线性的原因还可能包括:
- 数据不足。在某些情况下,收集更多数据可以解决共线性问题。
- 错误地使用虚拟变量。(比如,同时将男、女两个虚拟变量都放入模型,此时必定出现共线性,称为完全共线性)
与传统多元线性回归模型相比,偏最小二乘回归的特点是:
(1)能够在自变量存在严重多重相关性的条件下进行回归建模;
(2)允许在样本点个数少于变量个数的条件下进行回归建模;
(3)偏最小二乘回归在最终模型中将包含原有的所有自变量;
(4)偏最小二乘回归模型更易于辨识系统信息与噪声(甚至一些非随机性的噪声);
(5)在偏最小二乘回归模型中,每一个自变量的回归系数将更容易解释。
在计算方差和协方差时,求和号前面的系数有两种取法:当样本点集合是随机抽取得到时,应该取1/(n-1);如果不是随机抽取的,这个系数可取1/n。
通过一次投影得到t建立和y的关系,建立回归方程
最大似然估计:似然:通过实验对参数估计的过程。 发生许多事件,让这个事件可能性最大的参数值,比如 某种概率 或者均值等。这是一种估计过程,设计到参数的评价指标
重点:OPLSDA
- 为什么R2要普遍大于Q2也就是蓝点大于红点?
过程:通过建模所用样本得到这个模型后,然后在用该模型去预测其他样本的分组。
第一步:因为R2代表的模型对样本分组的解释度。
第二步:Q2代表模型的预测度,也就是用R2得到的模型去预测其他分组。
先有解释,后有预测,预测效率一般低于解释的效率
总结bioinformatics-3637343-061023-0708-61.pdf smica的用法
- 计算XY的协方差矩阵,通过找到使得两者相关性的最大方向w
也就是CCA是投影后的变量相关性最大,而PLSDA第一步就是协方差投影后最大- 将X投影到w方向得到t w是通过迭代得到的 而不是拉格朗日, w是迭代得到的
- 计算t和Y的协方差矩阵,找到两者相关性最大的方向c, 将y投影到c之后得到方向u,这一步保证y和c的方向相关性最大
- 分解t为T+O,这是通过和Y的计算得到的
- 计算载荷矩阵,得到u t分别与x,y变量的关系
- 计算u=tB得到回归系数矩阵,描述 u t之间的关系
- 最后一步y和x与xb 的回归建立关系
最小二乘 https://blog.csdn.net/weixin_44333889/article/details/119420315
1. *PLS 中的得分与回归系数
- X轴(t1)和 Y轴(t2)上的差异:如果得分图中不同类别的样本在 X轴和 Y轴上有明显的分离,则说明 PLS-DA 模型能够有效地将不同类别区分开来,模型分类效果较好。
- X轴(第一主成分得分):表示与类别变量Y 最相关的变异方向,是最能区分不同类别样本的方向。
- Y轴(第二主成分得分):表示与第一主成分正交的变异方向,捕捉数据中的次要差异,对进一步的类别区分有帮助。
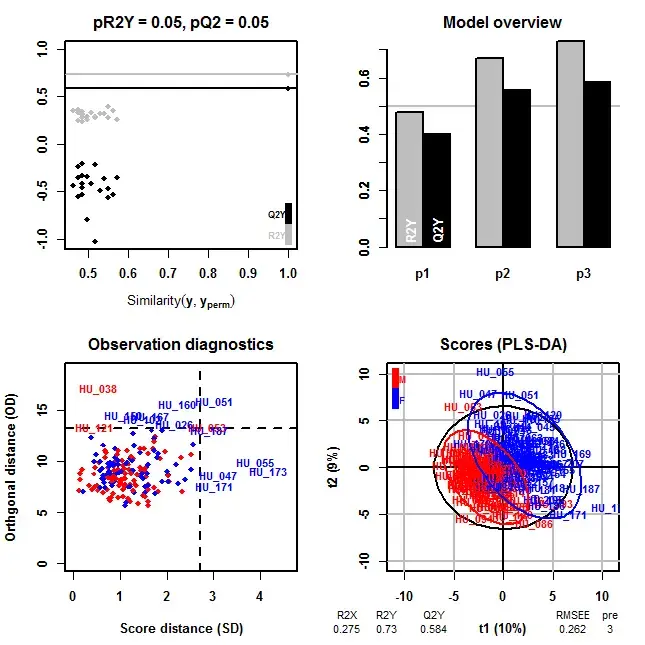
1. R解释度
2. 第三个是 离群值 是投影后的 看样子是计算了距离
names(aTributes(sacurine.plsda))   描述了所有的opls的结果的属性

对于归一化方式 要看模型的解释度才知道他行不行

可以使用PCA score1剔除异常点 或者holling test也可以剔除
predI=5 指的是提取 5个主成分