微生物中的标准化方法
- 按列总和标准化(Column-wise Sum Scaling)
- 按列总和标准化的目的是使得每个代谢物的总和或总丰度相同。如果一个代谢物在某个样本中的丰度值为 20,而在另一个样本中的丰度值为 200,按列总和标准化后它们的比例可能就可以得到平衡。这使得各个代谢物的贡献不会因为其原始丰度的差异而显得不相称。
- 这种方法有助于消除不同代谢物在绝对丰度上的差异,使得它们具有相对可比性。
- 行Z-score标准化(Row-wise Z-score Normalization)
- 这种方法对代谢物的量纲差异进行了处理,但它并不能直接解决数据中的偏态分布问题,尤其是在代谢物的丰度差异较大时。这种方法通常用于:
- 去除样本之间的尺度差异,使得每个样本在不同代谢物上的贡献被平衡。
- 消除不同样本在数量级上的差异,使得分析不受单个样本的极端值影响。
- Hellinger变换
Hellinger变换,作为一种对数变换的替代方法,专门用于处理包含大量零值或偏态分布的数据它的优点在于:
- 能够处理零值:Hellinger变换通过平方根的方式使得零值不会造成问题(不像对数变换会因为零值而引起负无穷的问题)。
- 平衡数据的相对丰度:Hellinger变换使得每个数据点处于[0,1]范围内,从而有效地减少了大值的主导作用,有助于减少异常值对分析的影响。
- Hellinger变换不仅适用于稀疏的计数数据,而且对于相对丰度数据的分析也十分有效。
微生物中CCA的标注
在典型对应分析(CCA)中,对数据进行预处理(如Hellinger变换)是常见的做法,特别是对于物种丰度数据或代谢组学数据这类相对丰度数据。然而,通常情况下,在进行环境因子分析时,不会对环境因子(例如气候、土壤性质等)使用Hellinger变换
-
Hellinger变换的适用数据类型通常用于处理包含相对丰度的计数数据:
- 相对丰度数据:如物种丰度数据、代谢组学中的代谢物浓度数据,这类数据常常是相对比例数据,且包含很多零值。
- 偏态分布数据:例如,某些代谢物或物种在大多数样本中浓度为零,只有在某些样本中出现较高浓度。
- 计数数据:Hellinger变换能够有效处理具有零值和较大浓度差异的数据,使得数据变得更加适合多变量分析。
-
环境因子的特点通常具有以下特点,与生物或代谢物丰度数据不同:
- 连续变量:环境因子通常是连续的实数变量,而非计数数据。例如,温度、湿度、pH值等变量通常具有一定的物理意义,是连续的实值。
- 无零值问题:环境因子通常没有零值,或者零值的情况不常见。对于这些变量,Hellinger变换(其主要解决零值问题的方式)并不适用。
- 量纲和尺度差异较小:环境因子虽然可能具有不同的量纲(如温度是摄氏度,湿度是百分比),但它们通常在物理上可以直接解释,因此不需要像丰度数据那样进行归一化或变换。 -
环境因子常用的预处理方法
- Z-score标准化:Z-score标准化是对环境因子进行标准化的常见方法: 这种方法有助于消除不同环境因子尺度的差异,使得它们对模型贡献的权重变得可比。
- 最小-最大归一化:将每个环境因子的值转换为[0, 1]区间,减少不同量纲的影响。这对于某些数据集来说是一个有效的预处理方法。
- Box-Cox变换或对数变换:如果环境因子存在显著的偏态分布(如某些值远大于其他值),可以对这些因子进行对数变换或Box-Cox变换,使得数据分布更接近正态分布,有助于提高模型的稳定性。
- 主成分分析(PCA)
如果环境因子间有较强的相关性,进行PCA降维也可以帮助去除多重共线性问题,将多个相关的环境因子合成少数几个主成分,从而减小冗余,简化模型。
vegan包中参数比较
如果你的数据已经进行了Hellinger变换(对于物种丰度数据)和Z-score标准化(对于环境因子数据),那么在进行**典型对应分析(CCA)**时,scale 选项应该设置为 FALSE。
- 物种丰度数据(
varespec):- Hellinger变换已经将物种丰度数据标准化到[0, 1]范围内,并且通过平方根变换减小了极端值的影响,使得不同物种之间的相对丰度差异被更好地平衡。Hellinger变换的效果相当于已经进行了一次标准化处理。
- 环境因子数据(
varechem):- 你已经对环境因子数据进行了Z-score标准化,这意味着每个环境因子的均值已被调整为0,方差已被调整为1,数据的尺度差异已被消除。因此,环境因子的尺度已经统一。
- 同样,由于你已经对环境因子进行了标准化,不需要再次标准化,因此
scale = TRUE对环境因子数据也没有必要。
- 由于物种丰度数据和环境因子数据已经经过适当的预处理(Hellinger变换和Z-score标准化),再进行
scale = TRUE标准化会导致重复标准化,这样可能改变数据的分布和方差,从而影响分析结果。
如果你的数据没有经过Hellinger变换(尤其是物种丰度数据),而你直接在典型对应分析(CCA)中使用 scale = TRUE,这种做法可能会不太适合,尤其是在物种丰度数据的处理上。原因在于标准化(如 scale = TRUE)和Hellinger变换的作用和目标不同,具体如下:
-
Hellinger变换 vs Z-score标准化
- Hellinger变换:这是一种针对计数数据(如物种丰度数据)专门设计的变换方法,尤其适用于包含大量零值或偏态分布的相对丰度数据。Hellinger变换的目的是通过平方根变换将数据转换为[0,1]的范围,减轻零值和高丰度数据对分析的影响,同时保留数据的相对比例关系。它特别有助于处理物种丰度数据中常见的零值问题。
在**cca()中,scale = TRUE的作用是对数据进行标准化,即将数据中每个变量(每一列)转化为零均值和单位方差。这适用于具有相同单位和量纲的数据**,而物种丰度数据通常有不同的分布和零值问题。
-
对于环境因子(
varechem),如果它们的尺度差异较大(比如温度、pH、湿度等),scale = TRUE是有意义的,因为它可以消除量纲差异,让不同环境因子对CCA分析的贡献相等。 -
对于物种丰度数据(
varespec),如果你没有对数据进行Hellinger变换,而直接使用scale = TRUE,可能会遇到以下问题:- 零值问题:物种丰度数据中通常包含大量零值,使用Z-score标准化时,零值会被转化为负值,这可能不符合丰度数据的实际性质。
- 尺度不均衡:物种丰度数据的分布通常是偏态的,很多物种的丰度接近零,少数物种的丰度较高。直接进行Z-score标准化可能会导致一些丰度较低的物种过于偏移,反而失去了它们的原始相对丰度信息。
- 失去相对丰度信息:Z-score标准化会使物种丰度数据的单位变为标准差,这可能丧失了物种之间相对丰度的重要信息。
3. 不经过Hellinger变换时的选择
如果你的物种丰度数据没有经过Hellinger变换,而你又想使用**scale = TRUE**,通常不是最理想的做法。因为:
- Hellinger变换可以有效地处理零值和数据的偏态分布,保持相对丰度信息;
- Z-score标准化(
scale = TRUE)对物种丰度数据来说可能会不适当,尤其是当数据中有大量零值时。
如果你的数据没有经过Hellinger变换,你有两个选择:
-
先进行Hellinger变换,再使用
scale = FALSE:- 物种丰度数据经过Hellinger变换后,可以保持数据的相对丰度信息,且Hellinger变换会减轻零值和高丰度的影响。这时,你可以直接进行CCA分析,并设置
scale = FALSE,因为Hellinger变换已经完成了数据的标准化。
cca_result <- cca(varespec_transformed, varechem, scale = FALSE) - 物种丰度数据经过Hellinger变换后,可以保持数据的相对丰度信息,且Hellinger变换会减轻零值和高丰度的影响。这时,你可以直接进行CCA分析,并设置
-
对环境因子使用
scale = TRUE,物种丰度数据使用scale = FALSE:- 对环境因子使用
scale = TRUE(Z-score标准化)是合适的,因为它们通常没有经过任何标准化处理,且具有不同的尺度。 - 对物种丰度数据保持原始数据(或使用Hellinger变换处理)并选择
scale = FALSE,避免标准化引起的相对丰度信息丢失。
cca_result <- cca(varespec, varechem, scale = TRUE) # 对环境因子标准化 - 对环境因子使用
- 如果物种丰度数据没有经过Hellinger变换,直接使用
scale = TRUE,可能会导致不合适的标准化,尤其是当数据中有很多零值时,可能会失去相对丰度的信息。 - 最佳做法是:
- 如果物种丰度数据没有经过Hellinger变换,最好在进行CCA前先使用Hellinger变换,或者直接选择
scale = FALSE,避免不必要的标准化。 - 对环境因子使用
scale = TRUE,使其具有相同的尺度和量纲。
- 如果物种丰度数据没有经过Hellinger变换,最好在进行CCA前先使用Hellinger变换,或者直接选择
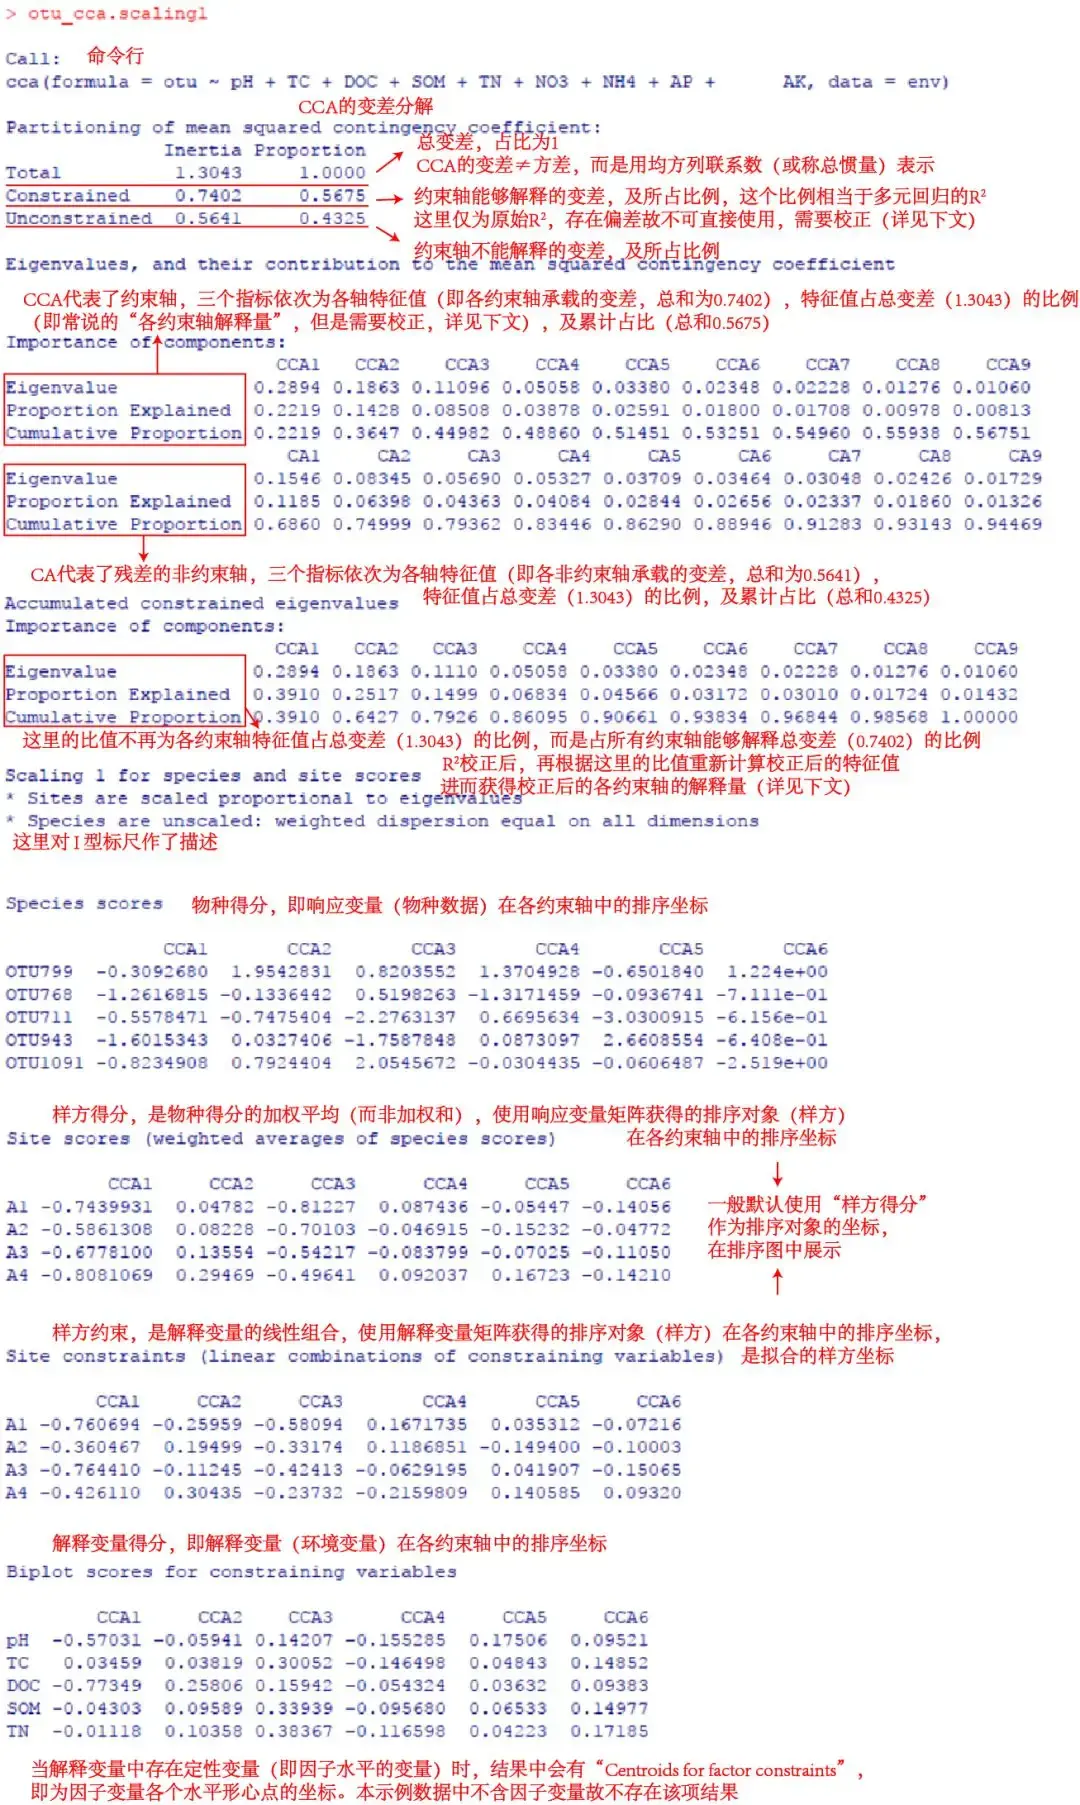
不建议直接在原始数据集中提取,因为这样提取的坐标数值未经标尺缩放处理,不利于反映生物学问题
otu_cca$CCA$u[ ,1:4]
otu_cca$CCA$v[ ,1:4]
otu_cca$CCA$biplot[ ,1:4]

#若对典范特征系数(即每个解释变量与每个约束轴之间的回归系数)感兴趣 coef() 提取 CCA 典范系数
cca_coef <- coef(otu_cca)
在这里,I型标尺中,样方得分是物种得分加权平均,故排序图中物种通常分布在样方范围之外;
II型标尺中,物种得分是样方得分的平均值,并按出现该物种的所有样方中该物种丰度加权,故排序图中样方通常分布在物种范围之外。
如果在进行模型置换检验时结果不显著,通常意味着你的模型没有显著地解释观测数据的结构。具体来说,这可以说明以下几种可能性:
- 物种和环境之间的关系较弱或不存在
- 解决方案:你可以考虑检查环境变量是否恰当、数据是否完备,或者是否需要引入其他未考虑的变量来解释物种分布。
- 环境变量选择不合适
- 解释:如果所选的环境变量不能很好地解释物种的分布,置换检验就可能不显著。这可能意味着你选择的环境变量不是物种分布的主要驱动因素,或者这些环境变量本身没有较强的变异性,导致模型无法有效捕捉物种分布的变化。
- 解决方案:可以重新考虑选择的环境变量,检查是否漏掉了某些关键的环境因子,或者可以尝试使用不同的数据处理或标准化方法。
-
样本量过小或数据质量差
- 解释:样本量过小或数据质量差也可能导致置换检验不显著。小样本量意味着统计检验的功效较低,可能导致无法发现真实的、微弱的关系。数据质量差(例如测量误差过大)也会影响结果的显著性。
- 解决方案:增加样本量或提高数据质量,减少噪声,可能帮助显著性检验更有力。
-
模型过于复杂,过度拟合
- 解释:如果你使用了一个过于复杂的模型,可能会导致模型在拟合数据时出现过度拟合,难以在置换检验中显示出显著性。在这种情况下,模型可能很好地拟合了训练数据,但无法有效地预测新的数据或解释样本之间的变异性。
- 解决方案:考虑简化模型,降低模型的复杂性,使用交叉验证等方法来避免过度拟合。
-
物种分布模式由非环境因素主导
- 解释:物种的分布可能不主要受环境因素的影响,可能更多地受其他因素(如生物互动、历史因素等)影响。这意味着环境变量对物种分布的解释力较弱,无法在统计检验中表现出显著性。
- 解决方案:考虑加入生物学交互因素(例如,物种间竞争、捕食等)或其他潜在影响因素进行建模。
-
数据变异性不足
- 解释:如果物种数据本身的变异性很小(例如,物种的丰度在大部分样地中非常接近或相同),即使环境变量对物种有影响,也可能难以在统计检验中表现出来。
- 解决方案:检查数据的变异性,看看是否需要进行数据转换(如标准化、对数转换等)或对数据进行更精细的处理。
- 置换检验的统计功效低
- 解释:置换检验的统计功效可能受到样本量、检验次数等因素的影响。如果样本量太小或者置换次数不够多,可能会导致检验无法发现显著性差异。
- 解决方案:增加置换次数(如增加到9999次或更多),或者增加样本量,以提高检验的统计功效。
判断使用CCA还是RDA
PCA 适用场景:如果您的数据是线性关系,并且您关心的是数据中 方差的最大化 。PCA 会帮助您理解样本之间的 线性差异。
DCA 适用场景:如果您的数据中存在 非线性梯度(比如环境因素对物种丰度的影响不是简单的线性关系),并且您关心的是去除这种 非线性梯度的影响,那么 DCA 会比 PCA 更适合。特别是对于 生态学数据,如物种丰度、环境梯度等,DCA 能够帮助您更准确地识别 样本的真正差异,而不是被非线性梯度所扭曲。
5DCA 的核心意义
对于您的问题,DCA 的核心意义在于:它不是单纯地看样本的差异大小,而是通过 去趋势化 来去除那些由 非线性环境梯度(如干旱、温度变化等)引起的影响,确保样本之间的差异更加准确地反映物种的 真正响应,而不是环境因子导致的非线性影响。
DCA 适用于数据中存在 非线性梯度 的情境,尤其是生态数据,去除非线性梯度后揭示样本的 真正差异。
如果数据中的差异是由 非线性梯度 造成的,PCA 可能无法有效地揭示样本的差异,而 DCA 更适合。
因此,虽然 PCA 也可以显示样本的差异,但对于有 非线性环境梯度 的数据,DCA 更能帮助您揭示 样本间的真实差异,并去除由环境梯度造成的非线性影响。
e. DCA的结果
- 如果在使用 DCA 进行分析时,发现数据中的梯度(例如第一主轴的长度)较长,并且这些梯度难以用 线性模型 描述,那么可以认为数据中可能存在 非线性梯度。
a. 为什么 DCA 主要用于非线性数据?
-
DCA 主要用于去除 非线性梯度。在生态学研究中,物种和环境之间的关系往往不是简单的线性关系。例如,某些环境因素(如土壤湿度、温度等)对物种丰度的影响可能表现为 阈值效应,即环境因子值达到一定范围后,物种的丰度才会发生显著变化。这种关系通常是 非线性 的,而 DCA 正是用来 去除非线性梯度,强调物种之间的 真正差异。
-
如果数据本身没有明显的 非线性关系,而是由 线性因素(如线性环境梯度或其他线性因素)引起的变化,那么 DCA 可能会不必要地 复杂化 结果,因为它去除的是 非线性梯度的影响,而这对于线性数据来说并不适用。
b. 如果数据是线性的,应该使用什么方法?
- RDA(冗余分析):对于线性数据,使用 RDA 更加合适。RDA 假设自变量和响应变量之间的关系是 线性 的,它通过将响应变量(例如物种丰度)投影到自变量(例如环境变量)空间上来解释数据的变异。如果数据呈现线性关系,RDA 会有效地提取出主要的环境梯度并揭示物种丰度的变化。
c. DCA 不适用于线性数据的原因
- DCA 的非线性去趋势化过程:DCA 通过去除数据中的 非线性梯度,强调物种间的 真正差异,尤其适用于那些具有复杂环境影响的情形。如果数据本身就是线性的,使用 DCA 可能会导致 过度拟合,甚至扭曲数据中的 线性结构,从而掩盖了实际的线性关系。
3. 总结
-
判断数据是否为非线性:通过 散点图、回归分析、残差分析 等方法来评估数据是否呈现非线性模式。如果发现数据中存在 非线性梯度 或 非线性关系,则可以选择 DCA。
-
DCA 对线性数据的适用性:如果数据是由 线性因素 导致的变化,那么 DCA 可能不是最佳选择。您应选择 RDA(冗余分析)或 PCA 来更好地分析和解释数据。DCA 更适合处理 非线性梯度 的数据,特别是在生态学研究中。
简而言之,DCA 主要用于 非线性数据,如果您的数据关系是线性的,使用 RDA 或 PCA 会更加合适。
DCA(Detrended Correspondence Analysis,去趋势对应分析) 是一种用于降维和探索多维数据结构的方法,尤其适用于处理生态学中物种丰度和样本之间的相似性分析。DCA的核心目的是去除数据中的趋势(通常是梯度),以便更好地理解和分析群落间的结构和分布。DCA结合了**主成分分析(PCA)和对应分析(CA)**的思想,并在其基础上引入了去趋势化的步骤。它主要通过以下几个步骤来处理和转换数据:
-
对应分析:它本质上是一种适用于矩阵数据的降维方法。具体地,CA用于寻找行和列之间的关系,并将数据投影到低维空间中,同时保持原始数据的相对关系。
-
- 给定一个样本与物种的二维数据矩阵 (行表示样本,列表示物种的丰度或频数),首先计算列和行的标准化(或者说频数化),将数据转换为包含相对比例的矩阵。
-
- 然后对该标准化矩阵进行奇异值分解(SVD,Singular Value Decomposition),从而得到其特征值和特征向量。
-
- 接着,将样本和物种分别投影到低维空间中,通常选择前几个主成分作为新的低维坐标系。
-
2. 去趋势化(Detrending)
在许多生态学数据中**,样本之间的差异**通常是沿着一个或多个梯度变化的,比如环境梯度或物种多样性梯度。梯度的存在可能会掩盖群落之间的真实结构,因此,去趋势化(Detrending)是DCA的关键步骤。
去趋势化的过程:
- 在CA投影的基础上,DCA通过对每个样本的坐标进行线性回归分析,计算出沿着主要梯度方向的趋势(即样本在梯度上的线性变化)。
- 然后,DCA将每个样本的坐标进行修正,去除这些梯度趋势,从而得到一个新的空间,这个空间更专注于反映样本之间的相对差异。
去趋势化的作用是确保样本间的变异更多反映物种的真正差异,而非由环境或其他潜在梯度因素引起的变异。
3. 构建去趋势后的低维空间
去趋势化后,DCA通过将残差(去掉梯度后的部分)再次进行降维,最终得到一个去除了主要趋势影响的低维表示。这有助于强调样本之间的非线性差异,尤其是在群落生态学中,物种之间的关系往往呈现出非线性。
您的理解方向是对的!可以将 DCA 看作是一种 去趋势化 的方法,通过去除环境梯度的影响,从而让物种丰度表的样本变异更多地反映物种之间的真实差异,而不是由于环境因素的梯度效应引起的差异。
具体来说,DCA 通过调整和去除 环境因素的梯度,使得丰度数据的变化主要反映物种间的组成差异。下面我详细解释一下这个过程:
1. DCA 的目标:去除环境梯度的影响
在生态学数据中,物种的丰度通常受到 环境因素(如 pH、温度、湿度、光照等)的影响。不同的环境梯度可能导致物种在样本中的丰度表现出某种趋势或变化模式。这些梯度通常是 线性或非线性 的(例如,某个物种可能在某个环境范围内迅速增加,或者另一个物种在某个条件下消失)。
DCA 的目标之一就是 去除环境因素的梯度影响,使得样本之间的变异更多地反映 物种组成的差异,而不是环境梯度的变化。换句话说,DCA 通过去趋势化的过程,调整所有环境因素的影响,使物种丰度表反映的是物种之间的真正差异,而不是环境梯度带来的效应。
2. 环境梯度对物种丰度的影响
在没有去趋势化的情况下,环境因素的梯度可能主导样本间的差异。例如:
- 样本间的环境梯度:样本间可能有显著的环境差异(如土壤 pH 变化),而这些变化直接影响到物种的丰度。
- 物种对环境梯度的响应:某些物种在某些环境条件下(如低 pH)表现得非常丰富,而在其他环境条件下(如高 pH)则显著减少。这种变化形成了 梯度效应。
如果我们不去除这些环境梯度的影响,DCA 的分析可能会将环境差异与物种差异混淆,导致物种的真正分布模式被环境梯度所掩盖。
3. DCA 中的去趋势化过程
DCA 通过以下几个步骤 调整 环境因素的梯度,确保样本的差异更多反映 物种的真正差异:
-
非线性梯度的去除:如果环境梯度对物种丰度产生非线性的影响(例如,物种丰度在某个环境变量范围内快速变化),DCA 会通过去趋势化的步骤去除这些 弯曲的梯度。这意味着,DCA 会去除那些由于环境梯度引起的非线性效应,使物种丰度的差异变得更加线性,便于进一步分析。
-
物种和样本的排序:去趋势化后,DCA 通过 对样本进行排序(例如,主成分分析)来最大化样本间的差异。这时,样本间的变异会更多反映 物种组成的差异,而非环境梯度的影响。通过这种方式,DCA 就是将物种丰度数据中的 环境因素的影响 调整到了一个更“平坦”的水平,从而使物种间的真正差异更加明显。
4. DCA 结果的意义
-
样本之间的差异:通过去趋势化,DCA 中样本的差异主要来自于物种丰度的不同,而非简单的环境变化。换句话说,样本之间的差异主要反映 物种的组成差异,而不是环境梯度所引起的物种丰度的变化。
-
物种间的差异:DCA 通过去趋势化之后,物种之间的差异也会更加突出。每个物种的 位置 反映了其对潜在环境梯度的响应,去趋势化后,物种之间的分布变得更加直观和明显,便于进一步分析物种的生态需求和适应性。
-
可以理解为,DCA 会 调整所有环境因素的梯度,将其对物种丰度表的影响调整到一个 统一的水平,从而确保样本间的变异 更多反映物种的真正差异,而不是单纯受环境因素梯度变化的影响。
-
通过去趋势化,DCA 会去除环境梯度的非线性影响,使得样本间的差异更加清晰地体现为 物种组成的差异,这有助于我们揭示物种如何在环境梯度的影响下进行分布。
这种调整使得 DCA 成为一种有效的工具,可以在没有明确环境数据的情况下,基于物种丰度数据揭示潜在的环境梯度及其对物种分布的影响。
DCA 仅去除非线性梯度,而不是所有的梯度。这样做的目的是消除那些 非线性环境效应,使得我们更好地看到物种分布中 真正的生态梯度,并帮助分析物种和样本之间的关系。
线性梯度(即物种对环境的线性响应)不会被去除,因为这些梯度反映了环境对物种分布的稳定、可预测的影响,这对后续分析(如 CCA 和 RDA)非常重要。
DCA 去趋势化后样本的接近性 是因为去除了 非线性梯度的影响,样本之间的差异更多地反映了物种组成的差异,而不是受到复杂环境因素的影响。
DCA的核心思想
- 梯度去除:去趋势化(Detrending)是DCA的关键,它通过去除数据中的线性梯度,使得数据更加适合揭示样本之间的相对差异,而不是梯度的影响。去趋势化处理后的数据更加平稳,便于识别物种群落结构中的细节。
- 非线性降维:DCA既保留了数据中的主要变化模式,又去除了梯度效应,使得分析能够专注于样本之间的差异,而不受大尺度环境梯度的主导影响。
- 基于对应分析(CA):DCA实际上是在CA的基础上加入了去趋势化的步骤,保持了CA的优点,同时在去除趋势后,能够更加精准地揭示生态群落的复杂性。
DCA的数学步骤概述
- 标准化数据:通过对物种丰度数据进行标准化或转换,使其具有相对比例(如列百分比)。
- 对应分析(CA):使用奇异值分解(SVD)对标准化后的数据进行降维,寻找物种和样本之间的主要结构。
- 趋势提取:使用回归分析提取数据中的主要梯度趋势,通常是线性趋势。
- 去趋势:从CA投影的结果中去除趋势成分,得到去除梯度后的数据表示。
- 二次降维:对去趋势后的数据再次进行降维,得出新的低维坐标系,以便进一步分析样本之间的相似性和差异。
在 DCA(Detrended Correspondence Analysis,去趋势对应分析)中,线性回归分析的目的是去除数据中的趋势成分,通常是沿着数据中的某个主要梯度(如环境梯度或物种梯度进行的。具体来说,DCA在步骤中使用线性回归来计算每个样本的坐标在主梯度方向上的变化趋势,并从中去除这些趋势,以便揭示数据中剩余的非线性部分。
DCA中的线性回归
在DCA的去趋势步骤中,对于每个降维后的样本坐标,线性回归用于拟合样本沿某个梯度的变化趋势,然后去除这个趋势。
具体来说,线性回归的Y和X分别是:
-
Y(因变量):这是样本在对应分析(CA)降维后的坐标(或投影坐标)。具体来说,它是样本在低维空间中的位置,通常表示为样本的主坐标分量,例如,第一主成分或第二主成分的坐标值。这些坐标表示了样本的相对位置,反映了样本间的相似性。
-
X(自变量):这是用来表示梯度(趋势)的变量。在DCA中,这通常是样本在环境梯度或物种梯度上的位置或者是某种外部因素(如环境变量、空间位置等)。这个梯度通常是一个潜在的影响因子,可以通过CA分析获得。X通常是样本在该梯度方向上的排序或者可以代表与该梯度相关的外部因素。
线性回归的目标
通过回归分析,DCA拟合出样本在该梯度方向上的趋势。拟合的线性模型是:
其中:
- 是样本 的坐标(通常是CA降维后的第一主坐标或第二主坐标,表示样本在低维空间中的位置)。
- 是样本 在梯度方向上的值,表示梯度或环境变量。
- 和 是回归模型的系数,表示线性趋势。
- 是误差项,表示去趋势后的样本坐标。
你提出的疑问非常好!确实,物种丰度表(通常是行表示样本、列表示物种)本身并不直接包含环境梯度的明确信息。然而,**DCA(Detrended Correspondence Analysis)**和类似的排序方法(如 PCA)正是通过分析物种丰度数据本身中的模式,间接揭示环境梯度对物种分布的影响。
因此,物种丰度数据本身可能间接反映了环境梯度,即物种组成的变化可能与环境条件(尽管未在数据表中显示)密切相关。
2. DCA 是如何工作的
DCA 通过对物种丰度数据进行排序,尝试揭示物种数据中的梯度模式,而这些梯度通常代表环境因素的影响。
- DCA 的目标是将物种的丰度数据映射到一个新的空间,使得样本(行)之间的差异可以通过物种组成的变化来反映。在这个过程中,DCA 会自动识别出数据中的 环境梯度效应,即使环境数据(如 pH、温度等)没有明确列在丰度表中。
- 去趋势(Detrending)是 DCA 的一个关键步骤,它会 去除数据中的非线性梯度(例如弯曲效应),使得剩余的梯度变得线性,便于后续分析。这些梯度通常与环境因素(如 pH、湿度等)有关,尽管它们并没有直接出现在数据中。
4. DCA 结果的解释
虽然物种丰度表本身不包含环境梯度,但 DCA 输出的**样本坐标(Y)**实际上是样本在这些潜在环境梯度上的投影。你可以通过 DCA 的排序图来 推测环境梯度,并进一步探讨 物种如何随这些隐性环境梯度变化。
-
样本坐标(Y):这表示样本在低维空间中的位置,通常是基于物种组成的差异。如果你在 DCA 结果中看到一些样本在空间中彼此接近,这些样本的物种组成比较相似,可能也受到了相似环境因素的影响。
-
物种坐标(X):这些代表物种在梯度空间中的位置,物种与样本之间的关系在这个空间中表现为物种和样本的距离关系,反映了物种对潜在环境梯度的响应。
5. 总结:DCA 的环境梯度效应
- 虽然物种丰度表本身不包含环境梯度数据,但 物种丰度表能够反映出样本之间由于环境梯度导致的物种分布差异。
- DCA 在这种情况下,通过对物种丰度数据进行排序分析,揭示了物种在样本之间的变化模式,而这种变化模式通常与潜在的环境梯度相关。
- DCA 输出的结果(如样本的坐标和物种的主成分)可以帮助我们理解物种是如何在环境梯度上进行分布的,尽管这些环境信息在数据表中没有明确列出。
因此,DCA 是通过分析物种丰度数据本身中的梯度变化,间接揭示了物种如何响应环境梯度的影响,即使这些环境变量在输入数据中并未显示。
如何理解第一主轴的长度与去除非线性梯度的关系
第一主轴长度较长,意味着数据中 依然存在显著的梯度效应,这种梯度可能是 非线性的 或者 线性 的。DCA 会去除掉由非线性梯度引起的变异,但如果样本间的梯度主要是 线性 的(即环境因子和物种丰度之间的关系是线性的),那么去趋势化后,第一主轴仍然会有较长的长度,且这种变异主要来自于 环境变量的线性影响。
如果数据中存在强烈的非线性梯度,DCA 的第一主轴也可能表现出较长的长度,因为去除非线性影响后的梯度仍然较强。这表明样本间的差异是由于 非线性环境因素(例如某个环境因子对物种的影响呈现曲线型的变化)所主导的。
如果第一主轴的长度较长,这通常表示 样本之间的差异较大,即环境变量在样本间的影响比较显著。换句话说,样本之间的物种组成变化主要是由环境因子(如 pH、温度等)驱动的。
3. 模型拟合和统计显著性
在多变量分析中(如 CCA 或其他回归模型),不同的标准化方法会影响模型的拟合效果和统计显著性。你可以使用统计模型来比较不同标准化方法下的模型表现。
-
方差解释度(R²):通过比较不同标准化方法后模型的 R² 值,看看哪种方法能更好地解释数据的变异。较高的 R² 值意味着该方法在捕捉数据的主要结构方面表现更好。
# CCA 分析后的 R² 比较 cca_result_log <- cca(log_transformed_data ~ env_data) cca_result_hellinger <- cca(hellinger_transformed_data ~ env_data) summary(cca_result_log)$r.squared summary(cca_result_hellinger)$r.squared -
置换检验:在 CCA 或其他统计模型中,你可以通过置换检验来评估不同标准化方法下模型的统计显著性。如果标准化方法选择得当,置换检验的 p 值应较低,表明模型能够更好地捕捉到真实的生态学信号。
anova(cca_result_log, permutations = 999)
anova(cca_result_hellinger, permutations = 999)
为什么通常不建议在 CCA 分析前 就做 VIF 检查:
- 变量之间的相关性本身就可能是重要的信息。在 CCA 分析前进行 VIF 检查并去除共线性较高的变量,可能会导致你丧失一些生态学上重要的变量。
- CCA 基于 特征值分解 来寻找最佳的组合轴,通常情况下,即使自变量之间有较强的相关性,CCA 仍然能够找到有效的组合方向。
- VIF 主要用于评估 线性回归模型 中自变量之间的多重共线性,它检测的是 自变量之间的线性相关性。而 CCA 是一种降维分析方法,关注的是变量与响应数据(比如物种组成)之间的关系,主要关心的是环境变量和响应变量之间的相互作用,变量之间的多重共线性并不一定会严重影响模型的解释力。
预先选择变量
,筛选环境因子是一项重要的预处理步骤
来筛选显著的环境因子
spe.adonis <- adonis2(t(spe) ~ ., data = env)
spe.adonis
adonis2() 是 vegan 包中的函数,用于进行 PERMANOVA(Permutational Multivariate Analysis of Variance)。它通过置换检验的方法,评估不同的 环境因子(独立变量)是否对 物种丰度数据(或其他多变量数据,如代谢物浓度)产生显著影响。
t(spe):spe是你分析的物种丰度数据或其他响应矩阵。由于adonis2()默认按列进行分析,因此需要使用t(spe)来转置数据,使样本成为行,物种或变量成为列。这样,样本之间的距离会被计算,并用来与环境因子相关联。- PERMANOVA 是一种基于置换的多变量方差分析方法,它通过计算组间差异与组内差异的比值来评估环境因子对样本的影响。
- 它的目的是确定某些环境因子是否显著影响了物种丰度或其他响应数据的变异。
4. spe.adonis 输出结果:
运行 adonis2() 后,spe.adonis 对象将包含以下信息:
- R²:每个环境因子对样本变异的解释比例。R² 越大,说明该环境因子越能解释数据中的变异。
- P 值:每个环境因子的显著性检验结果。P 值越小,表示该环境因子与物种数据之间的关系越显著。通常,P 值小于 0.05 或 0.01 表示显著性。
- F 统计量:F 统计量衡量了组间差异与组内差异的比值,用于判断组之间的差异是否显著。
假设你运行了 adonis2(),结果可能类似于以下形式:
Permutation test for adonis
Terms added sequentially (first to last)

              Df SumsOfSqs  MeanSqs F.Model   R2      Pr(>F)
env1           1    150.21   150.21   3.456  0.32  0.001 ***
env2           1     95.75    95.75   2.168  0.20  0.035 *
Residuals     18    145.35     8.08         0.48
Total         20    391.31
解释:
-
Df:每个环境因子的自由度。
-
SumsOfSqs:每个环境因子解释的平方和。
-
MeanSqs:每个因子的平均平方和。
-
F.Model:F 统计量,用于检验组间差异是否显著。
-
R²:每个环境因子对物种数据变异的解释度。
-
Pr(>F):P 值,检验该环境因子的显著性。
-
R² 和 P 值 是分析结果的关键,帮助你判断哪些环境因子对数据变异有显著影响。