基本思想
SVM(支持向量机)一种有监督的算法,可以判定样本分类。
基本思想:
-
使得所有的样本点距离决策边界最大化
-
软:允许某些点出错
-
硬:不允许样本出错
-
前置条件需要知道距离公式,先写二维 然后写出向量
-
使用方程构建分割面
-
要求max 最大化 两个分类之间的面的距离最大
-
找到最关键的点,要求最关键的点距离分类面最大,异常值会影响?
所以key是支持向量
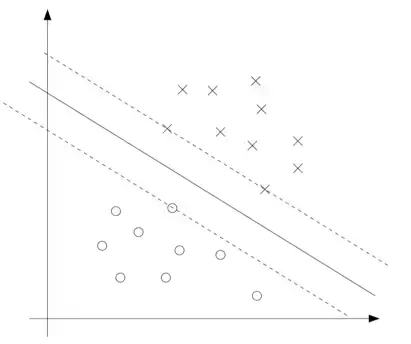
SVM的目标是找到一个超平面,这个超平面能够很好的解决二分类问题,所以先找到各个分类的样本点离这个超平面最近的点,使得这个点到超平面的距离最大化,最近的点就是虚线所画的。由以上超平面公式计算得出大于1的就属于打叉分类,如果小于0的属于圆圈分类。
这些点能够很好地确定一个超平面,而且在几何空间中表示的也是一个向量,那么就把这些能够用来确定超平面的向量称为支持向量(直接支持超平面的生成),于是该算法就叫做支持向量机(SVM)了。
- wx+b 的意义? 这是距离公式相关,距离公式用到了这个形式,实际上这个可以是对距离公式 特定情况下单简化
- 如何得到目标函数的? 因为有两个点 一个大 一个小 你如何统一呢?
- 分开写出两个点的函数
- 统一成一种形式
w 是法向量 也就是垂直于某个面或者某个线的向量
1. f(x)=ax+b 也就是有x 能确定 y, x,y就能画线 推广就是平面
2. +b 就是移动平面,最后需要找到一个合适的b 距离两个最远
法向量的证明是根据 点乘证明的,我现在是标量的思维,证明首先需要写为向量的形式SVM2
图解机器学习 | 支持向量机模型详解
机器学习经典算法之SVM - 程序员姜小白 - 博客园
Site Unreachable
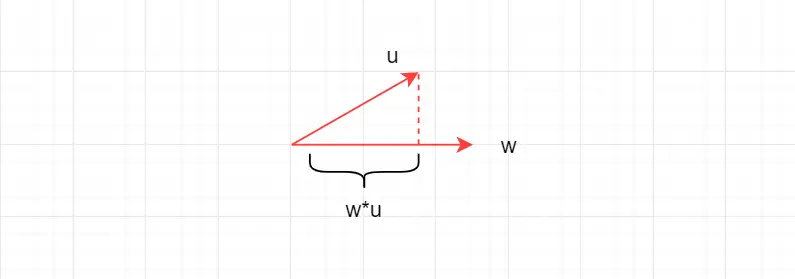
向量的点乘
向量a · 向量b = |a| * |b| * cos(θ) 在几何上的意义:
-
投影:这个公式实际上计算了向量b在向量a方向上的投影的长度(,然后乘以向量a(或向量b)的长度。投影是一个标量(没有方向的量),它表示了向量b在向量a方向上的“分量”的大小。
-
方向:点积的结果是一个标量,没有方向。如果点积为正,说明两向量的夹角在0°到90°之间,即它们是“同向”的(或至少不是反向的)。如果点积为负,说明两向量的夹角在90°到180°之间,即它们是“反向”的。如果点积为0,说明两向量垂直。
1. SVM 的基本形式
分类模型可以写成:
- :一个样本的特征向量(p 个基因的表达值)
- :每个特征的权重(与 gene 相关)
- :偏置项
- w 和 gene 的关系?
-
- :拉格朗日乘子(非支持向量样本的 α_i 为 0)
- :支持向量的特征向量(即表达数据)
- :标签(如 +1 / -1)
-
每一维 是对所有支持向量中 **第 j 个基因** 的某种加权和
-
因此:w 中的每个分量对应一个基因,它反映了这个基因在分类中的重要性
-
我们利用 w 的平方值: 作为特征重要性指标 即 gene_j 越重要,w\j 越大(正负无所谓),说明它对分类边界贡献越大
-
每次删除 w\j 最小的 gene,即贡献最小的特征
- b(偏置项)有什么意义?
- b 决定分类超平面的位置,是决策函数的截距
- 和 gene 本身无直接联系,是由支持向量决定的常数项
| 项目 | 含义 | 是否是基因 |
|---|---|---|
| 支持向量 | 训练样本中最关键的那些样本点 | ❌ 样本,不是基因 |
| w(权重向量) | 每个 gene 的分类权重 | ✅ 每一维对应一个 gene |
| b(偏置项) | 分类器的截距 | ❌ 不直接表示 gene |
标准硬间隔 SVM 问题(线性可分)
假设我们有一组训练样本:
- ,其中 ,
优化目标是:
✅ 1. 是什么?
它是样本点 到超平面的“带符号距离”乘以 。
换句话说,它表示:
- 如果为正,点在平面正侧;
- 如果为负,点在平面负侧;
- 值越大,点离平面越远。
✅ 2. 为什么乘上 ?
我们希望:
- 正样本在平面的一侧(即 )
- 负样本在平面的另一侧(即 )
统一写法:
若 :不等式是
若 :变成
所以乘上 ,就能统一写成:
✅ 3. 为什么是“≥ 1”,而不是“≥ 0”?
-
其实决策边界是
-
但我们想让离边界最近的点刚好满足:
-
这组点称为支持向量
-
所以我们把“要求所有点在支持向量之外”写成:
也就是说,我们人为把 margin 的边界固定在 ±1 上,以便能计算出明确的“间隔”宽度 =
“如果不加约束,最小化 会怎样?为什么必须加约束?”
我们希望找到一个能够正确分离正负样本的超平面,并且让它尽可能离两类样本远(最大间隔)。
这个“尽可能远”在数学上被表达为:
这是因为:
- 间隔宽度 =
- 所以最大化间隔 ⇔ 最小化
但如果没有约束条件会怎样?
如果你只最小化 ,而不加任何约束条件,你会得到什么?
这是一个标准的凸优化问题。如果没有限制,那显然 就是最小值 —— 距离为零。
但这没有任何分类能力,因为超平面退化了,它连个方向都没有了。
约束条件的作用是?
加入约束:
它的作用是:
要求所有样本都被“正确分类”,而且必须离超平面有足够的距离(至少为 1)。
也就是说,这个优化问题就变成了:
- 找一条平面,能把样本正确分开
- 同时这条平面要尽可能“平滑”,离所有点都远
| 项 | 含义 |
|---|---|
| 控制“间隔最大”,也就是让平面尽量离两边远(几何目标) | |
| 确保分类正确、并且边界两侧有 margin(分类目标) |
✅ 软间隔 SVM(如果样本线性不可分)
如果数据不能被完美分开,就引入松弛变量 :
这样允许部分点“违反”margin,但有惩罚。
SVM 的约束 是在保证每个样本在 margin 外侧,从而实现最大间隔分类。这个形式统一了正负类的处理,并使支持向量能被精确地定义为“刚好达到等于 1”的点。
一、线性SVM中的支持向量与基因的关系
当使用 线性核(kernel=“linear”) 时,SVM的决策函数为:
其中:
- 是权重向量(每个基因/特征对应一个权重)
- 是偏置项(决定分类超平面的偏移)
- 是输入样本(基因表达数据)
1. 支持向量(Support Vectors)
- 它们通常是靠近决策边界的样本(即最难分类的样本)。
- 支持向量不直接对应某个基因,但它们的基因表达模式影响了 的计算。
2. 权重 (决定基因重要性)
- 是一个向量,维度 = 基因/特征数量,每个元素 对应第 个基因的权重:
- 越大 → 该基因对分类的影响越大(可能是关键靶基因)。
- → 该基因高表达倾向于某一类(如癌症组)。
- → 该基因高表达倾向于另一类(如正常组)。
3. 偏置
- 是一个标量,调整决策超平面的位置,与基因无直接关系。
- 它仅影响分类的全局偏移,不参与特征选择。
二、非线性SVM(如RBF核)的情况
当使用非线性核(如RBF核)时:
其中:
- 支持向量 仍为样本,但无法直接得到 (因为数据被映射到高维空间)。
- 基因重要性 需要通过其他方法评估:
- 排列重要性(Permutation Importance):随机打乱某基因的值,观察模型性能下降程度。
- 基于模型的方法(如SVM-RFE的非线性核版本)。
三、SVM-RFE如何利用 筛选基因?
在 线性SVM-RFE 中,递归特征消除(RFE)的步骤如下:
- 训练线性SVM,计算权重 。
- 按 排序基因,移除权重最小的基因(最不重要的特征)。
- 重复 直到剩余指定数量的基因。
# 训练线性SVM
svm_model <- svm(X_train, y_train, kernel = "linear")

# 提取权重向量 w(仅适用于线性核)
w <- t(svm_model$coefs) %*% svm_model$SV
w <- as.vector(w)
names(w) <- colnames(X_train)

# 按重要性排序
gene_importance <- sort(abs(w), decreasing = TRUE)
head(gene_importance, 10) # 显示前10个最重要的基因- 但支持向量的基因表达模式会影响权重 。
-
权重 直接关联基因重要性
- 在线性SVM中, 衡量基因对分类的贡献。
- 适用于特征选择(如SVM-RFE)。
-
非线性SVM需间接评估基因重要性
- 无法直接获取 ,需依赖排列重要性或基于模型的方法。
-
偏置 与基因无关
- 仅影响决策超平面的偏移,不参与特征选择。
五、注意事项
- 标准化数据:SVM对特征尺度敏感,务必标准化(如Z-score)。
- 线性核优先:若目标是特征选择,线性核(
kernel="linear")更合适。 - 高维数据:当基因数 >> 样本数时,SVM可能过拟合,建议先进行初步过滤(如方差筛选)。
通过分析 ,可以识别对分类最关键的靶基因,进而指导后续生物学实验验证。
SVM中核函数的作用与高维空间线性可分性
在支持向量机(SVM)中,核函数(Kernel Function)的核心目的是将原始低维数据映射到高维空间,从而使得原本线性不可分的数据在高维空间中变得线性可分。此时,在高维空间中可以使用线性超平面进行分类。以下是详细解释:
1. 为什么需要核函数?
(1) 低维空间的线性不可分问题
在原始特征空间中,数据可能是非线性可分的(例如异或问题、环形分布数据)。
示例:
- 二维空间中,两类数据点呈环形分布,无法用一条直线分开。
(2) 高维空间的线性可分性
通过核函数将数据映射到更高维的空间后,数据可能变得线性可分。
数学原理:
- 设原始空间为 ,映射函数 ()。
- 在高维空间 中,存在一个超平面 能完美分隔两类数据。
2. 核函数如何实现“高维线性可分”?
(1) 核函数的本质
核函数 隐式计算高维空间的内积,避免显式映射 :
常见核函数:
- 线性核:(无映射,直接在原始空间分类)。
- 多项式核:。
- 高斯核(RBF):。
(2) 高维空间中的线性求解
在高维空间中,SVM仍求解一个线性超平面,但超平面对应于原始空间的非线性边界。
优化问题:
约束条件:
- 是高维空间的权重向量, 是映射后的特征。
4. 核函数的实际效果
(1) 线性核 vs. 高斯核
| 核函数 | 映射后的空间 | 分类边界 | 适用场景 |
|---|---|---|---|
| 线性核 | 原始空间(无映射) | 直线/超平面 | 数据本身线性可分 |
| 高斯核 | 无限维空间 | 复杂的非线性边界 | 数据非线性可分 |
5. 注意事项
- 计算复杂度:
- 高斯核需要计算所有样本对的相似度,时间复杂度 ,大数据集需用近似方法(如随机傅里叶特征)。
- 过拟合风险:
- 高斯核的 过大时,会拟合噪声(需交叉验证调参)。
- 可解释性:
- 高维空间的超平面无法直接解释,需依赖特征重要性分析。
- 核函数的作用:将数据隐式映射到高维空间,使得线性分类器(如SVM)可以解决原始空间中的非线性问题。
- 高维线性可分性:Cover定理保证映射后数据更可能线性可分,此时SVM仍求解线性超平面。
- 核选择:
- 数据简单 → 线性核(高效且可解释)。
- 数据复杂 → 高斯核(灵活但需调参)。
1. 支持向量是异常点/离群点怎么办?
SVM 的决策边界 高度依赖于支持向量。如果这些支持向量恰好是异常点或离群点,模型将学到不合理的边界,严重影响泛化能力。
解决方案:
-
使用软间隔(Soft Margin)SVM:
- 允许某些点违背边界(即“容错”),通过 惩罚参数 C 控制。
- 小 C:容忍更多错误 → 更平滑的边界(抗噪能力强)。
- 大 C:尽量避免错误 → 更贴合训练数据(更容易过拟合)。
-
使用鲁棒核函数(如 RBF):
- 非线性映射可以降低离群点的影响。
-
预处理:检测并去除离群点
- 如基于 z-score、孤立森林(Isolation Forest)、LOF(Local Outlier Factor)等。
-
考虑使用鲁棒SVM变种:
- 如 ν-SVM 或 Least Squares SVM(LS-SVM)。
⚖️ 2. 类别不平衡(Class Imbalance)
SVM 默认假设各类样本同等重要,但在类别不平衡下,少数类极易被“忽视”。
-
类权重调整(Class Weights):
class_weight = 'balanced'(在sklearn.svm.SVC中);- 或手动指定每类权重,如
class_weight={0: 1, 1: 10}; - 本质是对误分类代价加权。
-
过采样/欠采样:
- 如 SMOTE(合成少数类样本);
- 随机欠采样多数类,避免其主导模型。
📐 3. 是否需要特征缩放(Scaling)?
SVM 对特征尺度非常敏感,尤其是使用核函数(如 RBF)的情况:
- 若某些特征值远大于其他特征,会主导距离计算,影响支持向量选择。
- 不同量纲混合会让核函数失效。
| 问题 | 建议措施 |
|---|---|
| ❗ 数据量大 | SVM 训练慢,考虑使用 线性核 + SGD 或 近似方法(如 LinearSVC) |
| ❗ 特征维度高 | SVM 能应对高维,但要防止维数灾难(使用PCA/特征选择) |
| ❗ 核函数选择 | RBF 是默认首选,但线性、poly 也可试;使用 网格搜索调参 |
| ❗ 多分类问题 | SVM 是天然二分类,可通过 OvO 或 OvR 拓展 |
| 问题 | 是否注意? |
|---|---|
| 特征是否缩放 | ✅ 必须 |
| 异常点是否处理 | ✅ 推荐 |
| 类不平衡是否处理 | ✅ 需要 |
| 核函数与参数是否调优 | ✅ 网格搜索 |
| 是否考虑计算效率(大样本) | ✅ 考虑简化模型或使用核近似 |
支持向量机(SVM)中异常点、数据不平衡及数据标准化的综合处理
1. 异常点(Outliers)的影响与处理
(1) 异常点如何干扰SVM?
- 成为支持向量:异常点可能因距离超平面过近而被选为支持向量,扭曲决策边界。
- 导致过拟合:模型可能过度适应这些异常点,降低泛化能力。
(2) 处理方法
① 软间隔(Soft Margin)
通过调整正则化参数 ( C ) 控制对异常点的容忍度:
- ( C ) 较大:严格分类,异常点影响大(过拟合风险)。 可以理解
- ( C ) 较小:允许更多误分类,减少异常点干扰(鲁棒性增强)。
from sklearn.svm import SVC
model = SVC(C=0.1, kernel='linear')  # 较小的C对异常点更鲁棒
② 异常点检测与剔除
- 统计方法:Z-score、IQR(四分位距)识别离群点。
- 聚类方法:DBSCAN、孤立森林(Isolation Forest)隔离异常点。
from sklearn.ensemble import IsolationForest
clf = IsolationForest(contamination=0.05)
outliers = clf.fit_predict(X)
X_clean = X[outliers == 1]  # 剔除异常点
③ 鲁棒核函数
- 高斯核(RBF):通过非线性映射可能减弱异常点影响,但需调参(如减小 (\gamma))。
model = SVC(kernel='rbf', gamma=0.1, C=1)2. 类别不平衡问题
(1) 不平衡数据对SVM的影响
- 多数类主导决策边界,少数类被忽视。
- 模型可能倾向于预测多数类,导致少数类召回率低。
(2) 解决方法
① 类别权重调整
通过 class_weight 参数为少数类分配更高权重:
model = SVC(class_weight='balanced')  # 自动按类别频率调整权重
# 或手动指定
model = SVC(class_weight={0: 1, 1: 10})  # 少数类(1)权重为10
② 重采样(Resampling)
- 过采样少数类:SMOTE(合成少数类样本)。
- 欠采样多数类:随机剔除多数类样本。
from imblearn.over_sampling import SMOTE
smote = SMOTE()
X_resampled, y_resampled = smote.fit_resample(X, y)
③ 评估指标优化
- 使用 F1-score、AUC-ROC 而非准确率(Accuracy)。
from sklearn.metrics import classification_report
print(classification_report(y_test, y_pred))
3. 数据标准化(Scaling)的必要性
(1) 为什么SVM需要标准化?
- 距离敏感:SVM基于间隔最大化,涉及距离计算(如欧氏距离、核函数)。
- 特征量纲差异:若特征尺度不同(如年龄∈[0,100],收入∈[0,1000000]),收入会主导模型。
(2) 标准化方法
① Z-score标准化
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
② Min-Max归一化
from sklearn.preprocessing import MinMaxScaler
scaler = MinMaxScaler()
X_scaled = scaler.fit_transform(X)
③ 核函数与标准化的关系
- 线性核:必须标准化。
- 高斯核(RBF):必须标准化(因含 (|x_i - x_j|
- 多项式核:建议标准化。
4. 其他关键注意事项
(1) 核函数选择
- 线性核(
kernel='linear'):特征与目标线性相关时使用。 - 高斯核(
kernel='rbf'):非线性问题,需调参 (\gamma)(值越小,决策边界越平滑)。 - 多项式核(
kernel='poly'):适合显式的多项式关系。
(2) 超参数调优
- 网格搜索(GridSearchCV):优化 ( C )、(\gamma)、核函数等。
from sklearn.model_selection import GridSearchCV
params = {'C': [0.1, 1, 10], 'gamma': [0.1, 1, 'scale']}
grid = GridSearchCV(SVC(), params, cv=5)
grid.fit(X_scaled, y)
best_model = grid.best_estimator_
(3) 高维数据中的过拟合
- 特征选择:使用递归特征消除(RFE)或L1正则化(LinearSVC)。
from sklearn.feature_selection import RFE
selector = RFE(SVC(kernel='linear'), n_features_to_select=10)
X_selected = selector.fit_transform(X_scaled, y)
5. 完整处理流程示例
- 数据清洗:检测并剔除异常点(如用IsolationForest)。
- 标准化:对特征进行Z-score标准化。
- 处理不平衡:过采样(SMOTE)或设置
class_weight。 - 模型训练:选择核函数(如RBF)并调参((C)、(\gamma))。
- 评估:使用F1-score和AUC-ROC验证模型。
from sklearn.pipeline import Pipeline
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from imblearn.over_sampling import SMOTE
from imblearn.pipeline import make_pipeline

# 构建完整流程
pipeline = make_pipeline(
    StandardScaler(),
    SMOTE(),
    SVC(kernel='rbf', class_weight='balanced', C=1, gamma='scale')
)
pipeline.fit(X_train, y_train)| 问题 | 解决方法 |
|---|---|
| 异常点 | 软间隔(调整 (C))、异常点检测剔除、鲁棒核函数(如RBF)。 |
| 类别不平衡 | class_weight='balanced'、SMOTE过采样、使用F1-score评估。 |
| 数据标准化 | Z-score或Min-Max标准化(必须做!)。 |
| 核函数选择 | 线性问题用线性核,非线性问题用RBF/多项式核。 |
| 过拟合 | 减小 (C)、特征选择、交叉验证调参。 |
你提到的对 SVM 核函数 的理解里有一些正确点,但也混杂了一些不准确的地方,我来帮你梳理一下:
1. 核函数的真正作用
- 本质:核函数是一个“相似度函数”,它可以在不显式计算高维映射的情况下,得到样本在高维空间的内积。
- 为什么需要核:很多情况下数据在原始空间是不可分的,但在高维空间可能线性可分。核方法让我们能“隐式”地进入高维空间,而不需要真的去算高维坐标。
公式:
其中 是映射函数。核函数的作用就是直接计算 和 的内积。
2. 关于“欧式距离加和”的部分
-
部分正确:
-
某些核函数(如高斯核/RBF核)确实用到了 欧式距离:
在这里,欧式距离刻画了两个点在输入空间的相似度,距离小 → 相似度大。
-
-
但并不是所有核都这么做:
- 线性核:,只是内积;
- 多项式核:,是多项式扩展;
- Sigmoid核:。
所以,不能说“所有维度的欧式距离加和就是核”,更准确地说是 不同的核函数刻画不同的相似度。
3. 小结
- ✔ 你说的“变换到高维” → 对的;
- ❌ “每个样本所有维度用欧式距离加和” → 只对部分核(RBF)成立,不是核的通用定义。
要不要我帮你整理一张 常见核函数对比表(线性、多项式、RBF、Sigmoid),直观展示它们和“欧式距离”的关系?
问得非常好!这个问题直击SVM最核心的几何直觉。y_i(wx_i + b) 这个表达式有一个非常精妙和强大的几何意义:它直接表示的是样本点到决策超平面的“带符号的函数距离”,或者说“几何距离的符号倍数”。
让我们把这个几何意义拆解清楚。
1. 首先,理解 wx_i + b 本身的几何意义
对于任何一个样本点 x_i,计算 f(x_i) = wx_i + b:
- 如果
f(x_i) > 0,说明该点位于超平面wx + b = 0的“正侧”。 - 如果
f(x_i) < 0,说明该点位于超平面wx + b = 0的“负侧”。 |f(x_i)|(绝对值)的大小,正比于该点到超平面的几何距离。值越大,点离超平面越远。
2. 现在,乘以它的标签 y_i
标签 y_i 不是别的,它就是样本本身的“正确答案”,取值 +1 或 -1。
所以,y_i(wx_i + b) 的几何意义是:
用一个样本点的真实类别(
y_i)去“校正”模型对其位置的判断(wx_i + b)。
我们可以分两种情况看:
情况一:分类正确时
- 样本是正类 (
y_i = +1),并且模型也认为它在正侧 (wx_i + b > 0)。
y_i(wx_i + b) = (+1) * (一个正数) > 0 - 样本是负类 (
y_i = -1),并且模型也认为它在负侧 (wx_i + b < 0)。
y_i(wx_i + b) = (-1) * (一个负数) > 0
结论:只要分类正确,y_i(wx_i + b) > 0。并且这个值越大,说明这个点离决策边界越远,分类的“确信度”越高。
情况二:分类错误时
- 样本是正类 (
y_i = +1),但模型认为它在负侧 (wx_i + b < 0)。
y_i(wx_i + b) = (+1) * (一个负数) < 0 - 样本是负类 (
y_i = -1),但模型认为它在正侧 (wx_i + b > 0)。
y_i(wx_i + b) = (-1) * (一个正数) < 0
结论:只要分类错误,y_i(wx_i + b) < 0。
3. 在SVM优化目标中的几何意义:函数间隔
在SVM中,我们希望不仅仅是分类正确,还要最大化“间隔”(Margin)。这个“间隔”被定义为所有样本点中,离决策边界最近的那个点的距离。
y_i(wx_i + b) 这个量,被称为样本点 (x_i, y_i) 相对于超平面 (w, b) 的函数间隔(Functional Margin)。
- 它的符号代表了分类是否正确。
- 它的绝对值大小代表了分类的确信程度(点离边界有多远)。
SVM的核心优化目标可以理解为:找到参数 w 和 b,使得所有样本中最小的那个函数间隔尽可能大。
约束条件 y_i(wx_i + b) >= 1 的几何意义:
我们要求所有样本点的函数间隔至少为1。这意味着我们不仅仅要所有点分类正确(函数间隔 > 0),还要求每个点都离决策边界有“至少为1个单位(按当前w的模长衡量)”的“安全距离”。那些函数间隔恰好等于1的点,就是支持向量,它们决定了这个“安全通道”的宽度(即最终的几何间隔)。
总结与类比
一句话总结:y_i(wx_i + b) 的几何意义是“带符号的距离”,它将分类的正确性和确信度统一到了一个单一的数值上。
一个简单的类比:
想象你在一条双车道马路上开车,超平面 wx+b=0 是马路中间的分界线。
wx_i + b告诉你你的车离中线的距离(比如+2米,你在左边车道)。y_i是交通规则(y_i=+1代表“你应该在左车道”,y_i=-1代表“你应该在右车道”)。y_i(wx_i + b)的结果就是:- 一个正数:表示你不仅在了正确的车道,还和安全线(中线)保持了一段距离。数值越大,你离危险的中线越远,越安全。
- 一个负数:表示你跑到了错误的车道上,违章了!
SVM的目标就是画一条最宽的“安全通道”(间隔),确保所有车辆(样本点)都不仅在自己正确的车道里,而且离中线至少有1米的安全距离(>=1)。
好问题!这个地方其实是 SVM 里很多人一开始最容易卡住的点。我们拆开看:
1. 的几何意义
-
它代表点 到超平面的有符号距离(差一个常数因子)。
-
具体来说:
这个值如果是正的,说明点在超平面的一侧;如果是负的,说明在另一侧;如果是零,点正好在超平面上。
2. 乘上标签 的作用
-
标签 。
-
如果我们直接看 ,正类点希望它落在正侧,负类点希望它落在负侧。
-
但如果写成 ,就统一了判断标准:
- 若 ,要求 。
- 若 ,要求 。
这样,所有点都满足:
换句话说: 表示点到超平面的有符号距离,方向被“校正”了。
3. 几何意义总结
-
:点在超平面哪一边、离超平面有多远。
-
乘上 :统一了“正确侧”的方向。
- 如果结果大于 0 → 点在自己应该在的那一边;
- 如果结果小于 0 → 点在错误的一边(分类错误)。
-
结果的数值大小:就是点和超平面的“间隔 margin”(差一个 的缩放)。
👉 所以,几何直观上可以这么想:
- 是点到直线/超平面的带方向距离;
- 乘上 之后,就是“距离 + 正负标签校正”,它告诉你:这个点离超平面有多远,并且是不是站在正确的一边。
要不要我帮你画一张二维直观图:直线 ,然后展示两个点(正类和负类),再标出来 是怎么“校正方向”的?
非常棒的问题 👍,说明你已经抓住了 SVM 几何约束里的关键!我们一步步来拆解:
1. 是什么?
这是 超平面(二维时就是一条直线)的方程,它把空间分成两半:
- → 一侧;
- → 另一侧。
仅用 “大于 0 / 小于 0” 就能实现分类(正类、负类)。
2. 那为什么要写成 或 ?
这是因为 SVM 不仅要分类正确,还要留出 margin(间隔)。
-
如果我们只要求:
那么只保证点在“正确的一边”,但离边界可以很近,甚至几乎贴在超平面上 → 没有间隔。
-
SVM 的目标是:
这样会强制点 至少离超平面有一个单位的距离,从而留出一个 margin 带。
这里的 “1” 不是特殊的神奇数字,它只是一个 缩放规范化:
- 我们可以把约束写成 (任何正数都可以),
- 但最后通过缩放 和 ,把它归一化成 1。
3. 有什么差异?
-
用 0:
- 分类能成功,但 margin 不受约束;
- 学出来的超平面不是最大间隔的,泛化能力差。
-
用 1 / -1:
- 分类正确的同时,保证支持向量在 margin 的边界上;
- 优化目标 就能直接对应到几何间隔大小。
4. 几何直观
-
超平面:
-
间隔边界:
-
支持向量:正好落在这些边界上。
-
Margin 宽度:
✅ 小结:
- 如果用 0 → 只是分类边界,没有 margin。
- 如果用 ±1 → 明确划出 margin,支持向量刚好在这两条边界上,间隔被最大化。
要不要我帮你画一张二维示意图:
直线 ,两条平行边界 ,以及正负样本的分布 → 直观看 margin 和支持向量?