- 通过求导解决最小值问题
过程:
第一步,明确自己现在所处的位置
第二步,找到相对于该位置而言下降最快的方向
第三步, 沿着第二步找到的方向走一小步,到达一个新的位置,此时的位置肯定比原来低
第四部, 回到第一步
第五步,终止于最低点
梯度是损失函数对需要求解的模型参数的导数。
重点:需要理解泰特展开
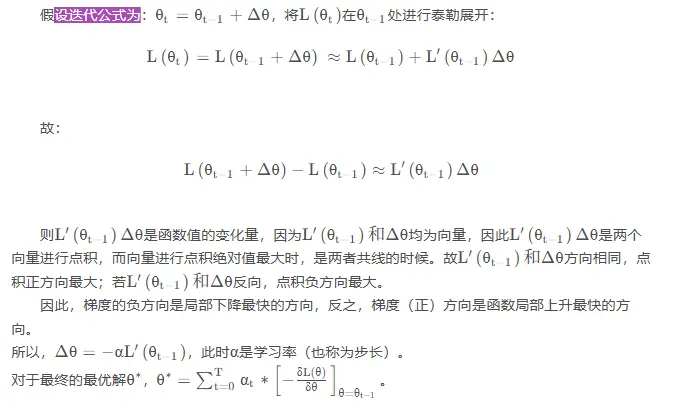
较大的函数=较小的函数 + 参数的导数 这能够说明
梯度下降本身是迭代
- beta=beta- 损失函数的偏导
当导数为 0:
-
你站在平的地方
-
这个点可能是:
- 一个 最低点(谷底)
- 一个 最高点(山顶)
- 或一个 拐点(比如马鞍)
这些点统称为:驻点(stationary point)
- 梯度与导数的关系
- 在多维函数中(比如神经网络的损失函数),我们用 梯度(gradient) 来描述每个变量方向上的导数
- 梯度是一个向量,指向函数上升最快的方向
梯度下降算法核心公式:
-
:模型参数(比如权重)
-
:损失函数的梯度(就是各参数的导数)
-
:学习率(步子多大)
-
每个参数 就像你在山上的一个方向(比如“往东”、“往南”)
-
你在每个方向上测一下坡度(偏导)
-
然后你在每个方向上都往“最陡的下坡方向”走一点点
假设损失函数是:
目标是最小化它。
导数是:
如果初始值 ,
则:
用学习率 :
所以你看到 beta1 从 0.1 增加到 0.68,正是因为导数是负的。
你提出的问题非常核心,它触及了梯度下降算法的一个关键点:我们怎么知道找到的“坡底”是真正的最低点?
首先,让我们澄清一个重要的数学概念:导数(或偏导数)等于0的点,是函数的 极值点。它可能是局部最小值,局部最大值,或者鞍点。它不一定就是全局最小值。
因此,当梯度下降算法找到一个梯度为0的点时,算法会停止更新,因为它无法确定下一步的方向。但我们并不能保证这个点就是我们想要的全局最优解。
一个实际的数值例子
假设我们的损失函数是一个简单的三次函数:
这个函数有两个极值点。让我们来求它的导数,并找到导数为0的点。
- 求导数:
- 令导数等于0:
这个一元二次方程有两个解,分别是 和 。
3. 计算损失函数的值:
- 当 时,
- 当 时,
从计算结果可以看出,当 时,损失函数的值是 ,而当 时,损失函数的值是 。因此, 才是这个函数的真正极小值点。
梯度下降过程
假设我们使用梯度下降来优化这个函数,并不幸地将初始值设在了 附近。
- 初始点:
- 计算梯度:
- 更新:由于梯度是正数,梯度下降会减小 的值。它将朝着 的方向移动。
如果初始点设在了 附近。
- 初始点:
- 计算梯度:
- 更新:由于梯度是负数,梯度下降会增大 的值。它将朝着 的方向移动。
如果梯度下降的初始点靠近 这个局部最小值,那么它就会收敛到 。在这个点,导数等于 ,算法就会停止。它会“认为”自己找到了最优解,但实际上它陷入了局部最优,错过了 这个更低的点。
结论
梯度下降算法并不知道全局的函数图像。它只根据当前位置的梯度信息来更新参数。如果它在一个局部最小值处,梯度为0,它就会停止,因为它已经没有更小的方向可以走了。这就是为什么初始值、学习率和损失函数的形式对于梯度下降的结果至关重要。
这个公式的直观意义,其实就是一句话:
你站在山坡上,想知道往哪边走才能下到谷底。导数告诉你坡的方向,负号让你往反方向走,η 决定你迈多大一步。
我们一点点拆开看。
1. 导数 f'(x) 是什么?
在一维函数 f(x) 里,f'(x) 就是曲线在 x 这一点的斜率。
f'(x) > 0:曲线在这里是上升的,往右走函数值变大。f'(x) < 0:曲线在这里是下降的,往右走函数值变小。f'(x) = 0:这里平了,可能是谷底或山顶。
我们要找的是最小值(谷底),所以希望函数值变小。
2. 为什么是 x - η × f'(x)?
情况一:f'(x) > 0
说明当前点在上坡,往右走会越走越高。
为了下山,应该往左走,也就是让 x 变小。
公式:x_new = x - η × 正数
因为 η 是正数,f'(x) 也是正数,所以减掉一个正数,x 就变小了 → 往左走 ✅
情况二:f'(x) < 0
说明当前点在下坡,往右走会越走越低。
为了下山,应该往右走,也就是让 x 变大。
公式:x_new = x - η × 负数
减一个负数等于加一个正数,所以 x 变大了 → 往右走 ✅
情况三:f'(x) = 0
说明这里已经平了,可能是谷底。
公式:x_new = x - η × 0 = x
x 不变,停在这里,正好是我们要找的最小值附近。
所以,负号的作用就是:导数指向上升方向,我们偏要往反方向走,才能下降。
3. 学习率 η 是干什么的?
η 是你每步迈多大。
η太小:每次只挪一点点,下山很慢。η太大:一步跨太远,可能直接冲过谷底,甚至越走越高。
你可以把 η 想成“步幅”。
f'(x) 的绝对值越大,说明坡越陡,这一步就应该迈得越大;坡越缓,步子就越小。
而 η 就是统一控制这个步子大小的系数。
4. 用 f(x) = x² 走一遍
f(x) = x² 的导数:f'(x) = 2x
最小值在 x = 0。
假设从 x = 3 开始,学习率 η = 0.1。
- 当前
x = 3
导数f'(3) = 6(正数,说明在上升,应该往左走) - 更新:
x_new = 3 - 0.1 × 6 = 3 - 0.6 = 2.4
果然往左走了,靠近 0。
再从 x = -3 开始:
- 当前
x = -3
导数f'(-3) = -6(负数,说明在下降,应该往右走) - 更新:
x_new = -3 - 0.1 × (-6) = -3 + 0.6 = -2.4
果然往右走了,也靠近 0。
不管从左边还是右边,公式都自动把你往谷底推。
5. 一句话总结
x_new = x - η × f'(x) 的直观意义:
看看当前点的坡度,如果坡是向上的,就往左退一点;如果坡是向下的,就往右进一点。退多少、进多少,由坡的陡峭程度和学习率共同决定。反复这样做,就会一步步滑到谷底。
这就是梯度下降最朴素的思想:顺着下坡方向,小步走。
求导 可以看作这段距离的斜率,然后斜率增加多少,函数可能增加的最快
| 你的问题 | 回答 |
|---|---|
| 每个特征都有方向吗? | ✅ 是的,每个参数对应一个“方向”(偏导方向) |
| 偏导最大的方向就是下降的方向? | ✅ 梯度是所有偏导组成的向量,我们往负梯度方向下降 |
| beta 是怎么变的? | 每次迭代都用:beta ← beta - 学习率 × 偏导 来更新 |
| beta1 会从 0.1 到 0.2 吗? | ✅ 如果导数是负的,学习率合理,它就会往上增加 |
✅ 1. 梯度下降是“怎么停止”的?
| 停止条件 | 含义说明 |
|---|---|
| 梯度变得非常小 | 即 ,说明已经到了平缓区,接近最低点了(像站在山谷中间) |
| 损失函数变化非常小 | 当前和上一轮损失差别很小,比如 < 1e-6,说明已经“几乎不再优化”了 |
| 达到最大迭代次数 | 为了防止陷入死循环(比如无法收敛),通常设置最多跑多少步 |
| 验证集误差开始上升(早停) | 用于防止过拟合(神经网络常用) |
while norm(grad) > 1e-6 and iter < 10000:
    theta = theta - eta * grad
✅ 学习率 η 是什么?
学习率(learning rate)控制每次“下山”走多远
它和导数一起决定每一步更新的“步幅” 有一个自适应的过程
更新公式:
- 导数告诉你:当前坡有多陡,方向在哪
- 学习率告诉你:你在这个方向上跨多远
| 问题类型 | 学习率过小/过大表现 |
|---|---|
| 收敛太慢 | 学习率太小 |
| 收敛不了 | 学习率太大(来回跳) |
| 损失发散 | 学习率极大,导致数值不稳定或爆炸 |
| 卡在局部极小 | 学习率太小,不足以逃离浅坑 |
- 常用初始值:
η = 0.01、0.001等 - 深度学习中:经常用自适应学习率算法(如 Adam、RMSProp)
- 有时使用“学习率衰减”:随着训练进行,逐步减小学习率
| 你问的点 | 关键解释 |
|---|---|
| 什么时候停止? | 当梯度很小、损失变化小、达到最大迭代次数等 |
| 学习率的意义? | 控制每一步走多远,与导数共同决定更新步伐 |
| 导数和学习率关系? | 导数 = 方向,学习率 = 步幅,两者乘积 = 本次更新量 |
| 跨太多会不会出问题? | 会!跨太远可能跳过谷底,造成震荡或发散 |
- :斜率(导数),指向损失函数上升最快方向
- :学习率(控制每一步走多远)
🧠 2. 学习率太大为什么会“跳过最小值”?
- 如果步子刚好(学习率适中)→ 你稳稳下山,靠近山谷 ✅
- 如果步子太大(学习率太大)→ 你可能跨过谷底,反而爬上对面山坡 ❌
- 再下一步你又跨回来 → 来回跳 → 无法收敛,甚至发散
我们从 开始:
情况一:学习率合适(α = 0.1)
→ 越来越接近 0 ✅
情况二:学习率过大(α = 1)
→ 你来回跳,一直在 1 和 -1 之间震荡 ❌
🎯 目标函数(损失函数)
最常见的是均方误差(MSE):
我们要做的是:找到能使 J 最小的 w 和 b。
化参数**
你说的第 1 步完全正确:
✅ “初始化 w 和 b,得到一个确定的 J 的值”
- 初始化 (比如设为 0 或随机小值)
- 然后可以计算当前参数下的损失
步骤 2:计算 J 对 w 和 b 的偏导数(梯度)
你说的第 2 步的表述需要更精准一点:
❗“计算 J 下降最快的 w_i” —— 更精确地说是:
计算损失函数对参数的偏导(梯度)
也就是:
这些偏导就是损失函数在当前点对 w 和 b 的“变化敏感度”。
步骤 3:沿着梯度的反方向更新参数
更新规则如下(乘以学习率 ):
这一步也叫“梯度下降更新”——你说的“乘以步长”说的是学习率 ,很好。
🚨 为什么是“反方向”?
因为梯度表示的是函数上升最快的方向,我们要下降 J 值,所以要沿梯度的 负方向 移动。
🔄 重复这个过程直到收敛
-
一次更新叫“一步”或“一轮”(epoch)
-
重复更新直到:
- J 函数变化很小(趋于稳定),或
- 达到指定轮数