- 样本协方差
- 分解协方差得到
- 得到特征向量
目标:方差最大的方向
PX=Y
X为原来的样本

注意到 的列向量:
为什么说PCA是投影?
因为PCA中思想设计到了矩阵的乘法,矩阵的乘法和点积相关。

yi 实际生是Pi与xi对应列的点积,也就是相当于是在对应向量上的投影。所以的行向量事实上就是一组新的基。
矩阵的协方差有什么特性?
对角线上的元素是对应的观测变量的方差。
非对角线上的元素是对应的观测变量之间的协方差。
在对角线上的元素越大,表明信号越强,变量的重要性越高;元素越小则表明可能是存在的噪音或是次要变量。
在非对角线上的元素大小则对应于相关观测变量对之间冗余程度的大小。

为什么要优化协方差矩阵?
- 信息冗余(非对角线,用相关性表示是否信息冗余)
- 对角线的部分 需要最大,让其波动最大。
目标:
- 样本矩阵对角线之和最大,方差最大(协方差矩阵对角化问题上)
- 样本矩阵非对角线为0,避免信息冗余
使用拉格朗日求导,得到结,也就是满足找到样本矩阵的特征向量时,结果满足
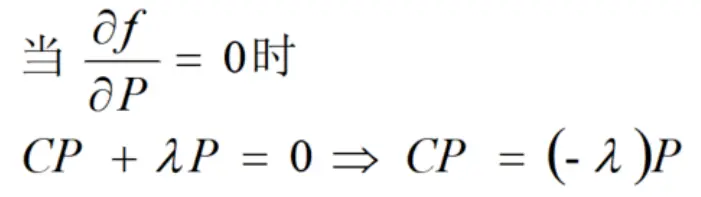
协方差矩阵C是一个是对称矩阵,在线性代数上,实对称矩阵有一系列非常好的性质:第一、实对称矩阵不同特征值对应的特征向量必然正交;第二、设特征向量λ重数为r,则必然存在r个线性无关的特征向量对应于λ,因此可以将这r个特征向量单位正交化。由两条性质可知,一个n行n列的实对称矩阵一定可以找到n个单位正交特征向量
Q:** 为什么组间样本之间相关性高但是PCA显示组间样本各自聚成1类?
-
样本间的特征差异显著:例如,如果在一组样本中,某些特征在样本间变化较大,而其他特征变化较小,那么PCA可能会在第一主成分上捕获到这种差异,从而导致样本在PCA空间中有明显的分离。
-
样本间存在高的Pearson相关性:Pearson相关性是一种衡量两个变量之间线性关系强度和方向的统计指标。如果在样本中,多个特征之间存在高的Pearson相关性,即它们之间呈现线性关系,那么这些特征可能会在PCA中共同构成一个主成分,从而导致样本在PCA空间中有明显的分离。当多个特征之间存在高度线性关系时,PCA可以捕获到这种关系,并将其映射到主成分上,使得样本在主成分空间中有明显的分布差异。
-
异常值(Outliers):数据集中可能存在一些异常值,这些异常值可能会对 PCA 分析结果产生显著影响。如果数据集中存在差异较大的异常值,它们可能会在 PCA 分析中被视为主要的方差来源,从而导致差异较大的主成分。同时,这些异常值可能与其他数据点具有高度的相关性,从而导致相关性较高的主成分。
-
数据量级不同:如果不同特征的数据量级不同即其取值范围差异较大,那么在进行 PCA 分析时可能会出现差异较大但相关性高的情况。这是因为在 PCA 分析中,不同特征的方差会被归一化【0-1】,但如果某些特征的数值范围较大,那么它们可能会在 PCA 分析中对主成分的贡献产生较大影响,从而导致差异较大的主成分。
-
明显的PCA分组:尽管样本在高维空间中的相关性较高,但是在PCA降维后的低维空间中,由于主成分的选择,样本可能在不同的主成分上有较大的投影差异,从而导致PCA分组明显。这可能意味着PCA成功地将高维数据映射到了低维空间,并保留了数据的主要信息
主成分
作用:
1.提取主要的信息成分噪声
2.它可以用于合并特征。当有一些信息相关性非常大的时候(也就是轴特别近的时候),我们可以用主成分分析法把它们合并成一个特征;
通俗理解:
以RNA-seq为例,每个样本中有很多基因,每个基因作为一个特征,那么有上千个特征。如果通过基因的数值变化评价,如果评价该样本得病潜在的风险有多大呢?
PCA 分析 则通过线性组合,将原始特征M1 M2 M3组合成了新的特征 N1 N2 N3 ,并且每个新的特征之间两两不相关,也就是 N1 不能通过N2 和N3 加权的得到(不能组合出新路)。
直观理解
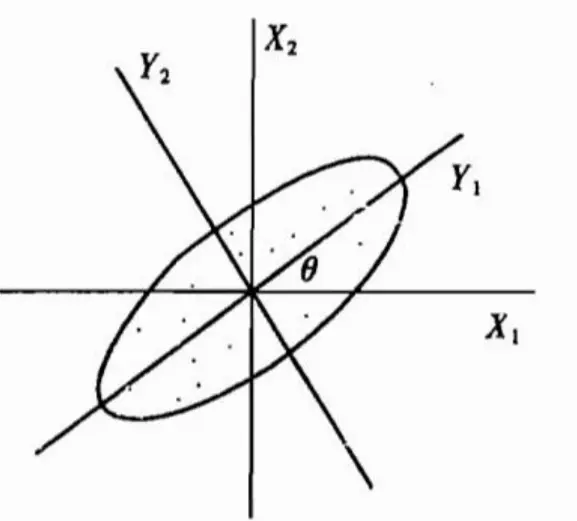
如果有N个观测,如果沿着椭圆的长轴和短轴看,短轴变化不大,长轴变化大,可以用长轴反映原来的样本的差异。这也就要求每个维度或者PCA反应独立的信息
单独看椭圆的长轴,就可以反映出PCA的信息,这就是PCA的直观理解

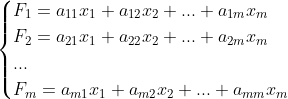


1.行为观测值 列为向量;如果知道系数,那么可以用F保存信息
- 要求Fi Fj 协方差为0,保证二者拥有的信息不冗余
- 对信息保存做出的贡献是由它的方差来衡量的,方差越大,原始数据的信息保存的也就越多
???问题N:为什么用方差表示信息量?
答:如果一个特征方差小,代表所有的点都比较集中;如果方差大,代表所有的点分散度比较大,信息更多
???问题N: 那么为什么要经过有特征向量这一步呢?
特征向量就是变换的系数,比如有5个特征向量,那么就有5个对应的新的特征。
对应是特征值,ai 特征向量, 越大,投影的方差越大,对应的线性变化F1越大
将向量经过矩阵变换后等于给原始的向量伸缩。特征向量就是伸缩的向量, 就是伸缩的倍数,
术语
1. 特征值(eigen value)是什么
特征值对应各主成分的方差,其???相对比例可理解为方差解释度或贡献度,特征值等于协方差矩阵,因为除了对角线外其他地方都为0,所以说方差等于特征值。第一主成分解释了原始数据集中的最大方差。 经过数学上的推导的,我们就可以知道,特征值对应的特征向量就是理想中想取得正确的坐标轴,而特**征值就等于数据在旋转之后的坐标上对应维度上的方差,特征值对应变化后的协方差矩阵。 经过对角化了
2. 特征向量(eigen vector)
特征向量是主成分对于原始变量的系数(主成分得分系数)。标准化后的原始变量与特征向量的矩阵积为主成分得分。
得分(score):指主成分得分,矩阵与特征向量的积
3. 载荷(loading)
单位特征向量乘以相应特征值平方根得相关系数。 pca$rotation是单位特征向量
载荷是原始变量与主成分得分之间的相关系数,这是两句话,等于特征向量乘以特征值的平方根。从列上看,各变量对同一主成分的载荷的平方和等于其特征值(主成分的方差),理解为各变量对该主成分的贡献。从行上看,同一变量对各主成分的载荷的平方和为1(变量的方差),理解为各主成分对该变量方差的解释度。
**思考:**我们如何得到这些包含最大差异性的主成分方向呢?
答案:事实上,通过计算数据矩阵的协方差矩阵,然后得到协方差矩阵的特征值特征向量,选择特征值最大(即方差最大)的k个特征所对应的特征向量组成的矩阵。这样就可以将数据矩阵转换到新的空间当中,实现数据特征的降维。 最后我们用P的第一行乘以数据矩阵X,就得到了降维后的表示。尽管协方差可以直接算出,但是看起来还是太麻烦了。算出特征值后看起来就很清楚。
[样本需要转置的原因] (https://zhuanlan.zhihu.com/p/37777074)求样本的方差。 以样本为列,算出样本的协方差矩阵,然后从协方差矩阵分析得到特征值
../线性代数/矩阵乘法
实现 步骤
- 构建原始数据矩阵;
- 数据标准化;
??? 问题:怎么得到的 - 建立协方差矩阵(或相关系数矩阵);
- 相关系数矩阵:变量之间的相关系数;对相关系数矩阵求特征值得到主成分;特征值除以特征值之和为某一特征值所占的比例
- 求出特征值、特征向量;
- 根据方差、累计方差贡献率确定主成分个数;
- 求出综合得分,给出现实意义的解释。
-   对原始数据进行标准化处理,消除量纲
-   计算标准化数据的相关系数矩阵
-   计算标准化数据的相关系数矩阵的特征根及对应的特征向量
-   选出最大的特征根,对应的特征向量等于第一主成分的系数;选出第二大的特征根,对应的特征向量等于第二主成分的系数;以此类推
-   计算累积贡献率,选择恰当的主成分个数;
-   解释主成分:写出前k个主成分的表达式
-   确定各样本的主成分得分
-   根据主成分得分的数据,做进一步的统计分析
3 R语言实战
R中构建主成分模型的常用函数有pricipal() 和princomp(),两者不同之处在于: pricipal() 只返回最佳nfactor的子集,而princomp() 将会得到和变量个数一样多的主成分。
prinipal:需要指定主成分的个数,这个需要碎石图进行前前期判断。
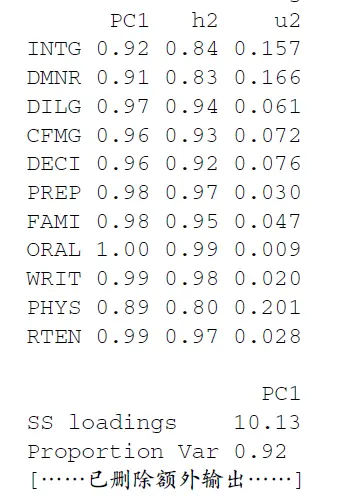
从pricipal() 可以看出PC1和每个变量都高度相关,因此可以作为一般性评价的维度。 主成分是各个变量的线性组合。如下图-0.01等是成分载荷,第一主成分(PC1)与每个变量都高度相关,也就是说,它是一个可用来进行一般性评价的维度。
h2是指成分公因子方差,即主成分对每个变量的方差解释度。eg法官正直(INT)84%的方差可以用PC1解释
SS loadings行包含了与主成分相关联的特征值。Proportion Var行表示的是每个主成分对整个数据集的解释程度。
对数据进行了Z-score归一化(均值为0,标准差为1)**
**此时相关系数矩阵等于协方差矩阵
补充信息
.数据的方差等于协方差所有特征值之和,第i个主成分的方差等于协方差矩阵的第i个特征值。实际计算时,特征值从大到小排序,然后从前到后求和就得到累积方差。所以累积方差贡献率的大小表示了当前选择的所有主成分携带原数据的信息的比例**。
方差
协方差:X-meanX * Y-meanY 两列数据
协方差矩阵:由于有很多列。所以两两之间
(x1 x2)…(x1,xn)
(xn.x1)…(xn,xn)
协方差矩阵之间的对角为方差(X-meanX) * (X-meanX)
线性变化的角度
1.PCA只是一种思想,核心就是线性变化:因为用到了变化矩阵得到了和特征值特征向量有关
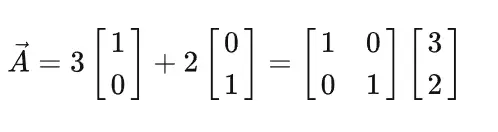
重要
PCA的核心思想:假设我们的数据有D1, D2,···,Dn个维度,PCA就是要构造一个线性变换,PCi = W1D1 + W2D2 +···+ WnDn,Wj就是第j维度在第i个PC中的权重。找PC有先后顺序,我们总是先找总方差最大的PC,方差解释度是统计里最重要的一个概念。然后我们再找与前一个PC线性无关的能解释最多方差的下一个PC,以此类推,知道得到所有的n个PC。最终的结果就是原先的n个维度通过线性变换,变成了新的n个线性无关的按方差解释度排序的PC。主成分中的“主principal”针对的就是方差解释度
R实现
scale这一步单独列出来了,大家可以看下scale的效果是什么,PCA的原始数据如果没有scale,PCA的结果就是错的,因为PCA非常看重方差占比,我们的数据的单位往往千差万别,必须scale,使得不同维度的方差可比。
主成分得分是在新坐标系的位置
特征向量是主成分对于原始变量的系数(主成分得分系数)。标准化后的原始变量与特征向量的矩阵积为主成分得分。
载荷是**原始变量**与主成分得分之间的相关系数,等于特征向量乘以特征值的平方根。
`mtcars.pca <-` `prcomp``(my_data, center = F,scale. = F)`
`summary``(mtcars.pca)`
`plot``(mtcars.pca$x, main =` `"after PCA"``)`


`Importance of components:`

                          `PC1     PC2`
`Standard deviation     1.3592 0.39045`
`Proportion of Variance 0.9238 0.07622`
`Cumulative Proportion  0.9238 1.00000`

PCA的输出,sdev、rotation、x;sdev标准差是每个PCA的方差解释度的平方根,肯定是递减的;
`sdev`是主成分的s.d,也是协方差矩阵的特征值的平方根。 特征值
`rotation`是一个矩阵,其列包含特征向量,即原始坐标系中的主分量旋转,很形象,PCA只是把原维度做了旋转而已,rotation是个矩阵里面就是原维度如何通过线性变换,得到PC的。
在主成分分析中,当您设置选项`scales = TRUE`时,它会缩放数据`decathlon.active`,而那些`center`和`scale`是用于缩放数据的居中和缩放。


standard deviation:标准差
Proportion of Variance:方差的占比    pca$importance
Cumulative Proportion:累计贡献率

样本得分 样本在新的坐标系的位置。
其实来看,原有的数据相对位置没变,只是找到了新的位置。新的位置就是新的PC
PCA里最重要的就是covariacne matrix协方差矩阵,它完美的包含了我们需要的信息,变量内的方差,变量间的相关程度协方差;
我们想要干什么呢?我们的目的是将covariacne matrix对角化,也就是变量内的方差最大,变量间的相关程度协方差为0;
特征向量的矩阵表征的就是线性变化,所以原先的数据矩阵在施加x运动后,会投射到新的PC里,这也从直觉上理解了PCA的精髓,线性投射。
从定义出发,Ax=cx:A为矩阵,c为特征值,x为特征向量。
矩阵A乘以x表示,对向量x进行一次转换(旋转或拉伸)(是一种线性转换),而该转换的效果为常数c乘以向量x(即只进行拉伸)。我们通常求特征值和特征向量即为求出该矩阵能使哪些向量(当然是特征向量)只发生拉伸,使其发生拉伸的程度如何(特征值大小)。这样做的意义在于,看清一个矩阵在那些方面能产生最大的效果(power),并根据所产生的每个特征向量
这里的基可以理解为X,Y轴
要准确描述向量,首先要确定一组基,然后给出在基所在的各个直线上的投影值,就可以了。只不过我们经常省略第一步,而默认以(1,0)和(0,1)为基。
现在(3,2)在新基上的坐标,即在两个方向上的投影矢量值,那么根据内积的几何意义,我们只要分别计算(3,2)和两个基的内积,不难得到新的坐标为(52√,−12√)(52,−12)

协方差
为什么协方差要为0?
如果我们还是单纯只选择方差最大的方向,很明显,这个方向与第一个方向应该是“几乎重合在一起”,显然这样的维度是没有用的,因此,应该有其他约束条件。从直观上说,让两个字段尽可能表示更多的原始信息,我们是不希望它们之间存在(线性)相关性的,因为相关性意味着两个字段不是完全独立,必然存在重复表示的信息。
协方差为0,字段内方差尽可能大的意思是,在新的轴上,数据可能离轴大
接下来就是是的原始矩阵的协方差为0,方差尽可能大了。
协方差矩阵对角化 原协方差矩阵到对角矩阵的变换
根据上述推导,我们发现要达到优化目前**,等价于将协方差矩阵对角化:即除对角线外的其它元素化为0**,并且在对角线上将元素按大小从上到下排列,这样我们就达到了优化目的。这样说可能还不是很明晰,我们进一步看下原矩阵与基变换后矩阵协方差矩阵的关系:
原始数据矩阵与变换后矩阵的关系
而P是一组基按行组成的矩阵,设Y=PX,则Y为X对P做基变换后的数据。设Y的协方差矩阵为D
设原始数据矩阵X对应的协方差矩阵为C,而P是一组基按行组成的矩阵,设Y=PX,则Y为X对P做基变换后的数据。设Y的协方差矩阵为D,我们推导一下D与C的关系:
现在事情很明白了!我们要找的P不是别的,而是能让原始协方差矩阵对角化的P。换句话说,优化目标变成了寻找一个矩阵P,满足PCPTPCPT是一个对角矩阵,并且对角元素按从大到小依次排列,那么P的前K行就是要寻找的基,用P的前K行组成的矩阵乘以X就使得X从N维降到了K维并满足上述优化条件“。
协方差矩阵C是一个是对称矩阵,
1)实对称矩阵不同特征值对应的特征向量必然正交。
2)设特征向量λλ重数为r,则必然存在r个线性无关的特征向量对应于λλ,因此可以将这r个特征向量单位正交化。
而对角化后得到的矩阵,其对角线上是协方差矩阵的特征值,它还有两个身份:首先,它还是各个维度上的新方差;其次,它是各个维度本身应该拥有的能量
个人理解
- PCA利用了投影的思想,投影到新的坐标系,或者新的空间。要求基相互正交,因为包含的信息需要独立,否则投影轴没有意义。
- 要求变换后的协方差矩阵称为对角矩阵,也就是协方差为0,。 因为PCA的协方差矩阵是个实对称矩阵,而实对阵矩阵的的特征值对应的特征向量正交。
- 找到特征向量也就找到了需要投影的
R实现
- log
- scale
- 去方差
PCA分析注意事项
1.一般说来,在PCA之前原始数据需要中心化(centering,数值减去平均值)。
- 除了中心化以外,定标 (Scale, 数值除以标准差) 也是数据前处理中需要考虑的一点。如果数据没有定标,则原始数据中方差大的变量对主成分的贡献会很大。数据的方差与其量级成指数关系,比如一组数据
(1,2,3,4)的方差是1.67,而(10,20,30,40)的方差就是167,数据变大10倍,方差放大了100倍. 这是对于整个基因来说的 - . 但是定标(scale)可能会有一些负面效果,因为定标后变量之间的权重就是变得相同。如果我们的变量中有噪音的话,我们就在无形中把噪音和信息的权重变得相同,但PCA本身无法区分信号和噪音。在这样的情形下,我们就不必做定标。
-
- 但是对原始数据进行标准化后更倾向于使得各个指标的作用在主成分分析构成中相等。对于数据取值范围不大或是度量单位相同的指标进行标准化处理后,其主成分分析的结果与仍由协方差矩阵出发求得的结果有较大区别。这是因为对数据标准化的过程实际上就是抹杀原有变量离散程度差异的过程,标准化后方差均为1,而实际上方差是对数据信息的重要概括形式,也就是说,对原始数据进行标准化后抹杀了一部分重要信息,因此才使得标准化后各变量在主成分构成中的作用趋于相等。因此,对同度量或是取值范围在同量级的数据还是直接使用非定标数据求解主成分为宜。
**|特征值碎石图。**前两个主成分代表了大多数方差,那么,该图开始部分很陡,其它主成分就像悬崖落下的碎石一样基本接近地面,这也表示选取主成分的一个原则。碎石图如果是一个缓斜坡,说明降维效果不好,应该剔除不能被代表的变量,重新降维。后续进行构建模型等分析时
是针对环境因子,各变量之间存在不同量纲,标准化可以较好地解决这个问题;其次,有些数据的数值比较大,标准化后可以较好地避免较大的数值对主成分的贡献过大。尽管如此,标准化也不是十全十美的。标准化会导致各变量之间的权重相等,这可能会产生一些负面结果。特别是,如果变量中有噪音的话,标准化无形中把噪音和信息的权重变得相同,但PCA是无法区分噪音和信号。因此,在这种情形下,我们就不需要标准化了。
者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
5星PCA
3.5星 PCA
3星PCA可视化的包 说明了与主坐标轴相关的变量有哪些
3.5星载荷图
3.5载荷图
主成分个数的选择
主要步骤
- 求样本均值
2.求样本协方差矩阵S
3.计算协方差矩阵的特征值和特征向量
4.将特征值排序
5.保留前N个最大的特征值对应的特征向量
6.将原始特征转换到上面得到的N个特征向量构建的新空间中 1个特征向量,1个维度
7.写出主成分的表达式