回归分析假设
- 是否是线性和可加的
- 如果使用线性模型。 画图,如果不满足1.应用变化 log 平方等
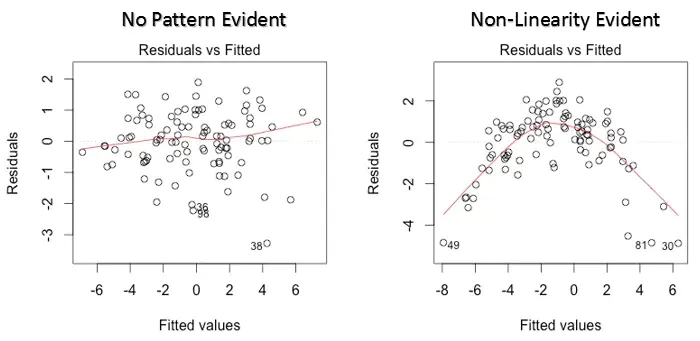
- 观察**残差-估计值图**。残差应该均匀分布,观察残差的拟合线是否水平
- 如果非线性:例如对因变量进行 log(X)、√X 或 X² 变换
- 可加性:X1对Y的影响是独立于其他自变量(如X2)的。 和交互项互斥(可以不满足)
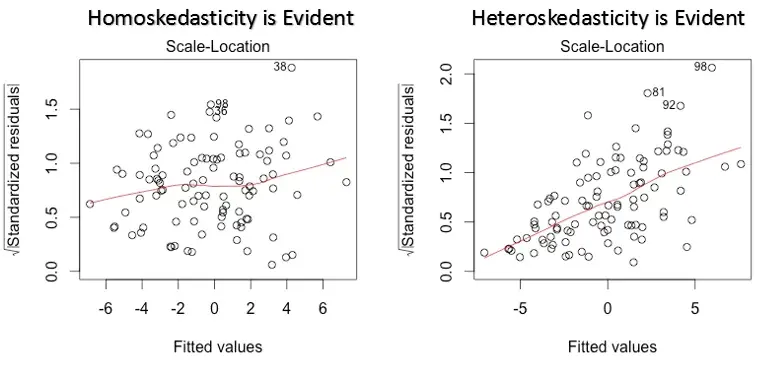
- 同方差性: 误差的方差在独立变量的所有水平上都是恒定的。
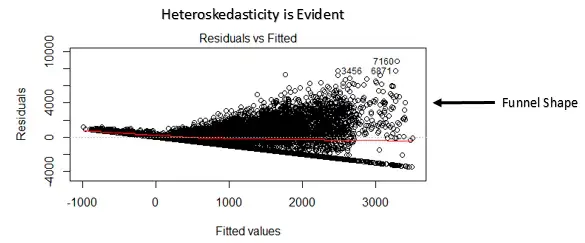
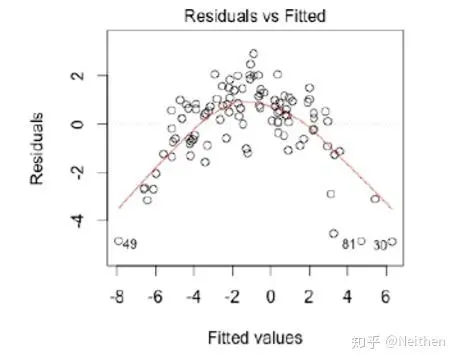
- 观察残差-估计值图。残差应该均匀分布,下图拟合线水平但是残差增大而增大
- 一种可能的方法是变换响应变量,例如对 log(Y) 或 √Y 变换。此外,还可以使用加权最小二乘法来解决异方差性。
- 观察残差-估计值图。残差应该均匀分布,下图拟合线水平但是残差增大而增大
- 误差项正态性: QQ图
- 共线性检验 VIF
- “自相关性”(Autocorrelation)通常是指一个变量自身在不同时间点之间的相关性,所以它针对的是因变量,特别是在时间序列分析中最常见。
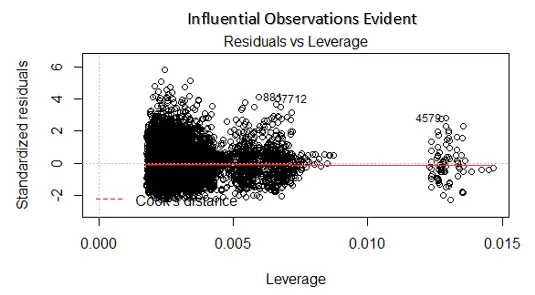
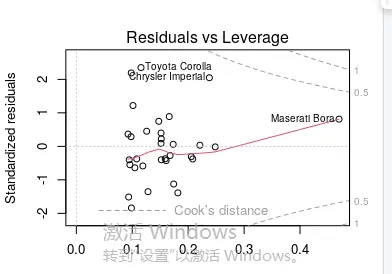
- 注意 残差和杠杆图
Assumptions of Linear Regression
1. 离群点
- 回归中 离群点是实际Y值 远离预测值的记录,可通过标准化残差(残差/残差的标准误)发现
# 使用 mtcars 数据集,用 mpg(每加仑英里数)作为因变量,wt(车重)作为自变量
data(mtcars)
model <- lm(mpg ~ wt, data = mtcars)

# 计算标准化残差(内部学生化残差)
standardized_resid <- rstandard(model)

outliers <- which(abs(standardized_resid) > 2)


# 绘制残差图
plot(fitted(model), standardized_resid,
	 xlab = "Fitted Values", ylab = "Standardized Residuals",
	 main = "Standardized Residuals vs. Fitted Values")
abline(h = c(-2, 2), col = "red", lty = 2)  # 添加阈值线

# 标注离群点
text(fitted(model)[outliers], standardized_resid[outliers],
	 labels = rownames(mtcars)[outliers], pos = 4, col = "red")

print(mtcars[outliers, c("mpg", "wt")])
强影响值
- 缺少会显著改变回归方程 会存在虽然不是一个明显的离群点但是 是回归的高杠杆值(显著改变回归方程)
- 帽子值
- COOK距离
# 标准化残差
std_resid <- rstandard(model)
# 杠杆值(Hat Values)
hat_vals <- hatvalues(model)
# 库克距离
cook_d <- cooks.distance(model)


# 设置图形参数
plot(hat_vals, std_resid,
     xlab = "Leverage (Hat Values)",
     ylab = "Standardized Residuals",
     main = "Influence Plot",
     pch = 21,
     bg = ifelse(cook_d > 0.1, "red", "gray"),  # 库克距离 > 0.1 标红
     cex = 2 * sqrt(cook_d))  # 点大小与库克距离成正比

# 添加参考线
abline(h = c(-2, 0, 2), lty = 2, col = "gray")  # 标准化残差阈值 ±2
abline(v = 2 * mean(hat_vals), lty = 2, col = "gray")  # 杠杆值阈值(2p/n)

# 标记强影响点
influential <- cook_d > 0.1 | hat_vals > 2 * mean(hat_vals) | abs(std_resid) > 2
text(hat_vals[influential], std_resid[influential],
     labels = rownames(mtcars)[influential], pos = 4, col = "red")


library(car)
influencePlot(model, id.method = "identify",
              main = "Influence Plot (car package)",
              sub = "Circle size ~ Cook's Distance")
计算方法
- 对设计矩阵 进行标准化(通常中心化+缩放)。
- 计算 的奇异值分解(SVD):
- 是奇异值对角矩阵。
- 条件指数 。
- 方差分解比例:
- 计算回归系数 的方差如何受不同奇异值影响。
- 如果两个变量的方差分解比例 > 0.5 在同一个高条件指数上,说明它们共线性强。
判断标准
- 条件指数(CI):
- CI < 10:无严重共线性。
- 10 ≤ CI < 30:中等共线性。
- CI ≥ 30:严重共线性。
- 方差分解比例:
- 如果多个变量在同一个高条件指数上的方差比例 > 0.5,说明它们之间存在共线性。
特点
✅ 优点:
- 能检测多个变量的组合共线性(VIF只能检测单个变量)。
- 适用于高阶回归(多项式、交互项),能识别复杂共线性结构。
❌ 缺点:
- 计算较复杂,需要SVD分解。
- 解释比VIF稍难,需结合条件指数和方差分解比例。
异方差
(股票)异方差性的成因总结为以下四种:
- Y和X本身存在非线性关系;
- Y本身存在显著的自相关性;
- 残差中包含和因变量X线性相关,但未被模型考虑的变量,导致残差和X相关;
- 受数据采样精度或流程所限,数据抽样时不独立,或环境发生显著变化,残差不满足独立同分布的假设。
线性回归的可加性假设是什么意思?
在线性回归模型中,**可加性(additivity)**是指:
每一个自变量对因变量的影响是独立的、线性的,并且这些影响可以简单地相加。
标准形式:
- 解释:每个 对 的影响是单独的(不依赖于其他变量),并且线性可加。
- 不存在变量之间的相互影响(交互)。
⚠️ 一旦你引入交互项,就意味着放弃了可加性假设。
如果现实问题中变量之间存在交互效应或非线性关系,那么我们可以放弃可加性假设,使用更灵活的模型,比如:
- 含交互项的线性回归 多项式回归 广义加性模型(GAM)
- 树模型(如决策树、随机森林) 非参数模型、机器学习模型等
什么时候“可加性”是需要的?
在**经典线性回归模型(OLS)**中,可加性是核心假设之一,它保证了:
- 模型简洁
- 参数可解释
- 线性叠加效应
- 推理(如置信区间、假设检验)成立
- 每个 表示:当其他变量保持不变时, 增加一个单位对 的影响。
- 所以:这个模型 假设所有变量作用是可加的。
二、什么时候“可加性”不需要?
当你面对的数据或现象具有以下特点时,可以主动放弃可加性假设:
- 有变量之间的交互作用
- 变量对因变量的影响是非线性
- 现实场景无法用简单相加来描述(比如政策互相影响、复杂生物机制等)
这个模型已经不满足可加性了,但它仍然是“线性回归”的一种扩展形式,因为它在参数上仍是线性的。
- 查看变量之间有无相关性
回归检验 重要
线性检验
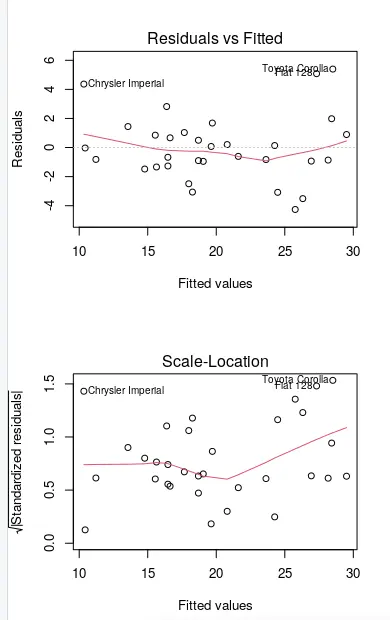
如果残差随着y值的增大而有增大或减小的趋势,或者残差的分布更近似于一个二次曲线,那么就意味着可能原本的数据并不是线性关系。这时候可以做一些求对数、求指数、求平方根等变换,然后再进行线性回归。
正态性检验 QQplot
正态性指的是对y的要求还是对x的要求?
在你做方差分析,或者一般线性回归前,要明确的是y是否符合正态分布,而不是x。
通常,我们研究某一个指标y的时候,都需要考虑某些因素x对y的影响,而不是仅仅研究y本身的随机波动。所以说,在几乎所有情况下,我们直接对y进行正态性检验是毫无意义的,因为y的变异中掺杂了x对y的影响。所以正态性检验时,我们首先要把这部分影响排除,也就是只对模型的残差进行正态性检验(这是最常用的方法),或者对x相同时对应的y进行正态性检验就可以了。
- 如果残差属于正态分布,说明观测结果的偏差由随机性导致,而不含其他因素。残差检验(X-σ)是正态分布,是否意味着样本数据本身也是正态分布?(可能不是,因为正态检验需要考虑样本量的大小,用残差检验代替样本检验通常就是因为样本量太小;所以,需要明确单因素方差分析中,为何用残差代替样本进行正态检验的根本原因,即为何用X-σ表示残差。
- QQ_plot的解释:横轴为百分位数,也就是比如-1 是x分位数,有x%的数小于-1,同时计算在实际中这个x的分位数是多少进行比较,从而得到QQplot
| 图名 | 横轴 | 纵轴 | 主要用途 | 关注点 |
|---|---|---|---|---|
| Residuals vs Fitted | 拟合值 | 残差 | 发现非线性关系、异方差、异常值 | 曲线趋势、漏斗状、离群点 |
| Scale-Location | 拟合值 | 标准化残差的平方根 | 检查残差方差是否恒定 | 异方差(更明显地看出来) |
多重共线性 VIF(方差膨胀因子)
方差膨胀因子(VIF)是用来衡量回归模型中自变量之间多重共线性程度的指标。对于第 个自变量 ,其VIF的计算公式为:
其中:
-
是将 作为因变量,对其他所有自变量进行回归时得到的决定系数(即模型的拟合优度)。
-
表示其他自变量对 的解释程度。
- 如果 很高(接近1),说明 可以被其他自变量线性表示,即存在严重的多重共线性。
-
通常认为:
- VIF < 5:共线性较弱。 5 ≤ VIF ≤ 10:存在中等共线性。VIF > 10:存在严重共线性。
为什么“两两变量的简单相关系数”可能不够?
- 但多重共线性可能是多个变量共同作用的结果。例如:
- 和 单独可能相关性不高,但 可能是 和 的线性组合(如 )。
- 此时简单相关系数无法捕捉这种复杂的共线性。 VIF通过将 对其他所有自变量回归,能够捕捉到与其他变量的组合之间的关系。因此,即使两两相关性不高,VIF仍可能检测出共线性。
回归方程中统计量服从F分布的原因
- 需要在区间内估计
- 需要模型适用性检验
数据
- 观测性的
- 回顾性的: 缺失可能不准
- 设计性的
- F分布是通过卡方分布构造的。
- F分布衡量两个独立样本的方差比率,因此其推导依赖于卡方分布的性质。
-
卡方分布在回归中的应用:
- 在回归分析中,残差平方和(RSS)是根据样本残差计算的平方和。残差平方和是若干正态分布随机变量的平方和,因此服从卡方分布。
-
F分布的构建:
- 在回归中,我们需要比较两部分平方和的方差比:
- 解释平方和(SSR):模型解释的部分平方和。
- 残差平方和(RSS):误差项的平方和。
- 通过对 SSR 和 RSS 各自的平方和归一化(除以各自的自由度),可以计算 F 统计量:
其中 是模型参数个数, 是样本大小。
- 在回归中,我们需要比较两部分平方和的方差比:
未中心化时,VIF是否可靠?
✅ VIF的计算不受中心化影响,因为:
- VIF 是基于回归模型的 ,而 仅依赖于变量之间的线性关系,与变量的均值(是否中心化)无关。
- 中心化仅调整截距,不会改变变量之间的协方差或相关性,因此VIF仍然可靠。
⚠ 但需要注意:
- 如果模型包含交互项(如 )或多项式项(如 ),未中心化可能导致严重的共线性,此时VIF可能很高,但中心化可以缓解这一问题(而不改变变量间的真实关系)。
- 如果变量本身高度相关(如 和 几乎线性相关),无论是否中心化,VIF都会很高,表明共线性问题。
| 情况 | 是否需要中心化? | VIF是否可靠? |
|---|---|---|
| 一般线性回归 | 可选(不影响VIF) | ✅ 可靠 |
| 交互项/多项式回归 | ✅ 建议中心化 | 未中心化时VIF可能高,但中心化后可降低人为共线性 |
| 标准化(如Lasso/Ridge) | ✅ 建议标准化 | VIF仍可靠(但标准化后变量尺度不同) |
- VIF的计算不受中心化影响,在未中心化时仍然可靠。
- 但如果模型包含交互项或多项式项,中心化可以降低人为共线性,使VIF解释更合理。
- 标准化主要用于变量可比性或正则化回归,但不会影响VIF的共线性诊断能力。
如何判断是否存在多重共线性:
.(1)某些自变量的相关系数值较大(比如大于0.8)等,可以利用pearson相关系数检验法一般是利用解释变量之间的线性相关程度判断,一般标准是系数大于0.8则认为可能存在多重共线性。
(2)如果增加一个变量或者删除一个变量,回归系数的观测值变化很大。
(3)如果说F检验通过,并且决定系数值也较大,但是t检验并不显著,也可能存在多重共线性。(4)回归系数的正负符号与专业知识相反或与实际分析结果不符,也会存在多重共线性的可能。以上方法可能会存在误差,更多偏向于主观,还有一种正规检验方法,观察回归分析中的VIF值(方差膨胀因子),这个检验方法更为严谨、准确。通常的判断标准是VIF值大于10即具有多重共线性,有的文献也说大于5即有共线性。
处理多重共线性经验式做法:
(1)删除不重要的共线性变量但是删除变量后可能会导致模型和原本分析的模型不一样,可能会出现决策错误等现象。
(2)增加样本容量多重共线性有可能与样本量过少有关,所以如果存在也可以加大样本量。但是加大样本量具有局限性比如实验已经结束或者其它原因
。(3)变量转换构造一个新的变量,这一新变量是多重共线性变量的函数,然后用这个新的变量代替多重共线性的变量,但是要注意组合后的数据需要有实际意义否则模型不好解释。
岭回归岭回归分析是一种修正的最小二乘估计法,当自变量系统中存在多重共线性时,它可以提供一个有偏估计量,这个估计量虽有微小偏差,但它的精度却能大大高于无偏估计。如果使用SPSSAU进行分析岭回归一般有两个步骤:岭回归通过引入k个单位阵,使得回归系数可估计;单位阵引入会导致信息丢失,但同时可换来回归模型的合理估计。针对岭回归:其研究步骤共为2步,分别是结合岭迹图寻找最佳K值;输入K值进行回归建模。逐步回归逐步回归分析方法视自变量对因变量的影响显著性大小从大到小逐个引入回归方程,从处理角度来看逐步回归比岭回归和主成分回归要好一些。逐步回归面临着检验的显著性水平的选择困难它通常得不到最优变量子集,可以利用SPSSAU进阶方法中逐步回归进行分析。
VIF 函数与 colldiag 函数对比
在回归分析中,VIF(方差膨胀因子)和 colldiag(共线性诊断) 都是用于检测多重共线性的工具,但它们的计算方法和侧重点不同。以下是两者的对比:
异常值判断
- 什么是 Leverage(杠杆值)?
- 杠杆值(Leverage)表示某个观测点的自变量(X)在整个数据中的稀有程度。
- 越靠近数据中心(平均值)→ 杠杆值小;越远离中心 → 杠杆值大。
数学上,来自帽子矩阵 ,对角线元素就是杠杆值 ,取值在 之间。
- 什么是 Residuals?残差 = 实际值 - 预测值,衡量模型在该点的拟合好坏。
| 类型 | 解释 | 危害 | 识别方式 |
|---|---|---|---|
| 高残差、低杠杆 | 模型拟合不好,但不极端 | 可能是异常点 | 位于图上方或下方 |
| 高杠杆、低残差 | 特殊点但模型拟合得不错 | 不一定危险 | 在右边但不高的区域 |
| 高杠杆、同时残差大 ✅ | 模型拟合不好,且该点离其他点远 | 危险影响点(有可能主导模型) | 在图的右上/右下角 |
通常会加一条:Cook’s Distance 曲线
- Cook’s Distance 衡量一个观测点对回归系数整体的影响程度。
- 图上常画出一两条 Cook’s distance 的轮廓线(半圆形/抛物线)作为影响阈值。
Cook’s D > 0.5 通常说明该点对模型有一定影响
Cook’s D > 1 通常认为是严重影响点
- 看右上或右下角:高杠杆又有大残差 ➜ 这些点可能是影响模型的极端点。
- 落在 Cook’s D 曲线外的点:说明这些点对整体模型有较大影响。
- 中间区域的大残差点:模型拟合不好,可能数据录入有误,也要检查。
| 能发现什么? | 意义 |
|---|---|
| 高杠杆点 | 自变量X极端,可能主导拟合 |
| 高残差点 | 模型预测不准的点 |
| 同时高杠杆+高残差点 | 最危险,对模型有强烈影响(Influential Point) |
| Cook’s Distance 超过阈值 | 影响整个回归模型,需要审查或剔除 |
线性回归的离群值的判断:
- 数据中存在少量的离群值是合理的。例如,当我们产生1000个服从标准正态分布的随机数,以距离均值大于两个标准差作为离群值判断标准,因为数据落在两个标准差之外的概率约为4.5%,意味这1000个抽样中大约会有45个离群值。此时如果我们去除这45个离群值来估计分布的方差,将会得到小于1的结论。因此,在删去离群值前应慎重考虑,除了因为存在少量离群值是合理的以外,离群值可能包含抽样或者数据的特征或者存在的问题。因此,如果数据中存在相当数量的离群值,应分析其成因,而非简单将其删去。
简单线性回归
MS残为残差均方,有时候称 回归标准误差
为什么可以使用t检验检测系数是否为0?
因为误差服从正态分布,所以Y服从正态分布,进而因为 是y的线性组合 所以 服从正态分布,所以可以用Z检验去检测,因为总体的误差未知,所以使用样本MS残代替使用t检验。
称为斜率的估计标准误差
为什么可以用方差检验回归的显著性?
交互作用:一个变量变化产生的效应取决于其他的变量
残差
- 标准化残差
- 学生化残差
- PRESS残差:PRESS残差:就是剔除1个点建立的回归方程的预测是 和所有点的预测值的差值
1. 标准化残差(Standardized Residual)
-
定义:
普通残差除以残差的标准误,即:
其中:- 是普通残差(观测值-预测值),
- 是残差的标准差估计,
- 是杠杆值(杠杆矩阵的对角元素,反映数据点对回归的影响)。
-
作用:
消除残差的量纲,使其服从标准正态分布(均值为0,标准差为1)。
异常值判断:
若标准化残差的绝对值 > 2 或 3,可能为异常值(分别对应约5%和0.1%的显著性水平)。
2. 学生化残差(Studentized Residual)
-
定义:
进一步改进标准化残差,使用剔除当前点后的标准差估计(避免异常点自身影响方差估计):
其中 是剔除第 个点后重新拟合模型的标准误。 -
作用:
更准确地反映异常点的影响,尤其适用于方差齐性假设不成立时。
异常值判断:
学生化残差服从 分布,绝对值大于临界值(如2或3)时视为异常。
3. PRESS残差(Prediction Error Sum of Squares Residual)
-
定义:
第 个点的PRESS残差是实际值 与用剔除该点后拟合的模型得到的预测值 的差值:
所有PRESS残差的平方和称为PRESS统计量,用于模型选择。 -
作用:
直接衡量一个点对模型预测的影响,避免“自我欺骗”的预测误差。
异常值判断:- PRESS残差较大的点可能是异常值或强影响点。
- 可通过比较PRESS残差与普通残差来识别异常值(若差异大,说明该点对模型影响显著)。
| 残差类型 | 核心思想 | 优点 | 局限性 |
|---|---|---|---|
| 标准化残差 | 统一量纲,简单标准化 | 计算简单 | 受异常点方差估计影响 |
| 学生化残差 | 剔除自身点后估计方差 | 更稳健,适合方差非齐性 | 计算复杂度略高 |
| PRESS残差 | 基于“留一法”交叉验证 | 直接反映预测能力 | 需重新拟合模型 次 |
如何选择?
- 初步筛查:先用标准化残差快速定位潜在异常值。
- 精确诊断:用学生化残差或PRESS残差验证,尤其是高杠杆点或强影响点。
- 模型优化:若PRESS残差显著高,需检查该点是否为异常值或模型是否需要调整。
# 拟合线性模型
model <- lm(y ~ x, data = df)

# 标准化残差
standardized_resid <- rstandard(model)

# 学生化残差
studentized_resid <- rstudent(model)

# PRESS残差(需手动计算)
press_resid <- resid(model) / (1 - hatvalues(model))
通过综合这三种残差,可以更全面地识别异常值并评估模型稳健性。
在统计学和回归分析中,**离群点(Outlier)、杠杆点(Leverage Point)和强影响点(Influential Point)**是三个相关但不同的概念,它们对回归模型的影响方式和程度各不相同。以下是它们的区别和联系:
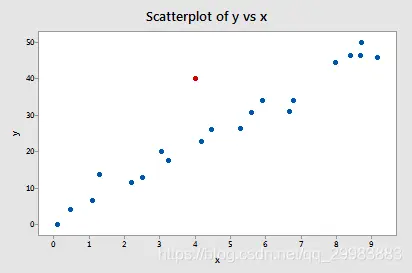
1. 离群点(Outlier)
- 定义:离群点是指与大多数数据点明显不同的观测值,其在**响应变量(Y)**上的值与模型预测值差异较大。
- 特点:
- 通常通过**残差(Residual)**大小识别(残差 = 观测值 - 预测值)。
- 可能是由于测量误差、数据录入错误或真实存在的极端值。
- 影响:
- 离群点不一定会显著影响回归线的斜率,但会增大误差方差(如均方误差 MSE)。
- 如果离群点在自变量(X)上并不极端,可能只是“垂直方向”的异常。
示例:
在回归线附近的大多数点中,有一个点的Y值明显高于或低于预测值。
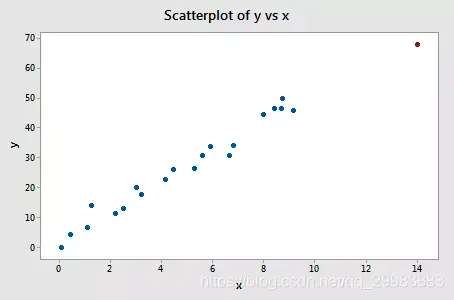
2. 杠杆点(Leverage Point)
- 定义:杠杆点是指**自变量(X)**上极端的观测值,即X值与大多数数据点显著不同。
- 特点:
- 通过**杠杆值(Leverage Statistic)**量化(如帽子矩阵的对角线元素)。
- 高杠杆点可能对回归系数的估计有较大影响,但不一定导致模型预测偏差。
- 影响:
- 如果杠杆点不是离群点(即Y值符合模型趋势),它可能帮助拉直回归线,改善模型拟合。
- 如果杠杆点同时是离群点(即Y值也异常),则可能严重扭曲回归结果。
示例:
在散点图中,有一个点的X值远远大于其他数据点,但Y值可能符合或偏离回归线。
3. 强影响点(Influential Point)
- 定义:强影响点是指对回归模型参数估计或预测有显著影响的观测点,通常同时具备高杠杆和离群特性。
- 特点:
- 通过**影响度量(如Cook距离、DFFITS)**识别。
- 删除该点会显著改变回归系数或模型拟合结果。
- 影响:
- 强影响点可能扭曲回归线的斜率和截距,导致错误的结论。
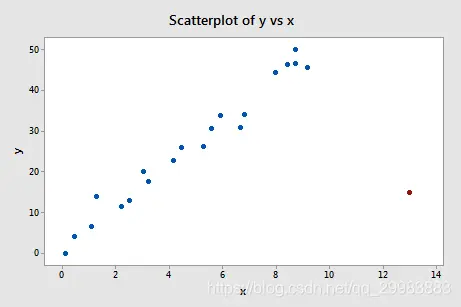
示例:
一个点在X和Y方向均极端,且删除后回归线方向发生明显变化。
- 强影响点可能扭曲回归线的斜率和截距,导致错误的结论。
三者的关系总结
| 概念 | 关注方向 | 识别方法 | 对模型的影响 |
|---|---|---|---|
| 离群点 | Y值异常 | 大残差 | 可能增加误差,但不一定影响斜率。 |
| 杠杆点 | X值极端 | 高杠杆值 | 可能影响斜率,取决于Y值是否异常。 |
| 强影响点 | X和Y均极端 | Cook距离、DFFITS | 显著改变回归系数或模型拟合。 |
关键区别
- 离群点:Y异常,但X可能正常。
- 杠杆点:X极端,但Y可能正常。
- 强影响点:X和Y均极端,且对模型影响显著。
如何检测?
- 离群点:标准化残差(如学生化残差)> 2或3。
- 杠杆点:杠杆值 > 2×(预测变量数+1)/样本量。
- 强影响点:Cook距离 > 4/样本量,或DFFITS > 2√(p/n)。
cook距离是一种剔除方法,通过剔除第 i个点 比较 之间的距离
多项式回归
样条回归是分段回归的一种
要求每段4-5点,每段不应该多余1个强影响点和极值点。
- 首先看残差图
非参数回归
- loess回归
- 核回归
1. VIF(Variance Inflation Factor,方差膨胀因子)
功能
- 衡量单个自变量由于与其他自变量相关而导致的方差膨胀程度。
- 适用于一般线性回归,检测是否存在严重的多重共线性。
✅ 优点:
- 计算简单,适用于任何回归模型。
- 直接量化每个变量的共线性程度。
❌ 缺点:
- 只能检测单个变量的共线性,无法识别**变量组合**的共线性。
- 在高阶交互项或多项式回归中,VIF可能误判(如 和 天然相关,但不一定影响模型)。
2. colldiag(Collinearity Diagnostics,共线性诊断)
功能
- 提供更全面的共线性分析,包括:
- 条件指数(Condition Index, CI)
- 方差分解比例(Variance Decomposition Proportions)
3. 何时使用 VIF vs. colldiag?
| 场景 | 推荐方法 | 原因 |
|---|---|---|
| 一般线性回归(无交互项) | VIF | 简单直观,计算快 |
| 含交互项/多项式回归 | colldiag | 能识别变量组合的共线性 |
| 高维数据(变量多) | colldiag | VIF可能无法发现隐藏共线性 |
| 需要详细共线性来源分析 | colldiag | 提供条件指数和方差分解比例 |
| 计算 VIF** |
library(car)
model <- lm(y ~ x1 + x2 + x3, data = mydata)
vif(model) # 计算VIFcolldiag**
library(perturb)  # 需要安装
colldiag(model, scale = TRUE)  # 标准化后计算共线性诊断
输出包括:
- 条件指数(Condition Index)
- 方差分解比例(Variance Decomposition Proportions)
| 方法 | 适用场景 | 检测目标 | 判断标准 |
|---|---|---|---|
| VIF | 一般线性回归 | 单个变量的共线性 | VIF ≥ 5(中等),VIF ≥ 10(严重) |
colldiag | 复杂回归(交互项/多项式) | 变量组合的共线性 | CI ≥ 30 + 方差分解比例 > 0.5 |
推荐做法:
- 先用 VIF 快速检查,如果某些变量 VIF 很高,再使用
colldiag深入分析。 - 如果模型含交互项或多项式,优先用
colldiag,因为 VIF 可能误判。
回归分析中的“有偏但方差小” vs. “误差方差大”
在回归模型中,我们通常希望估计的回归系数(如 )具有:
- 无偏性(Unbiasedness):估计值的期望等于真实参数,即 。
- 小方差(Low Variance):估计值在不同样本中的波动较小。
1. “有偏但方差小”的估计
含义
- 有偏(Biased):估计值 的期望与真实值 不同,即 。
- 方差小(Low Variance): 在不同样本中的波动较小。
典型例子
- 岭回归(Ridge Regression):
- 通过引入 惩罚项,牺牲无偏性以降低方差。
- 适用于高共线性数据,虽然估计有偏,但预测更稳定。
- LASSO 回归:
- 类似地,通过 惩罚产生有偏估计,但能进行变量选择。
为什么接受有偏估计?
- 当数据存在多重共线性或样本量较小时,无偏估计(如OLS)可能方差极大,导致预测不稳定。
- 通过引入正则化(Regularization),牺牲少量偏差以大幅降低方差,提升模型的泛化能力。
2. “误差方差大”的含义
误差方差(Error Variance, )
- 回归模型中,误差项 的方差 。
- 它衡量模型未解释的随机波动(如测量误差、遗漏变量等)。
误差方差大的影响
- 估计精度下降:
- OLS 估计的方差 正比于 (公式:)。
- 越大, 的置信区间越宽,估计越不精确。
- 预测性能变差:
- 误差方差大意味着数据噪声强,模型的 会较低。
解决方法
- 增加样本量:降低 。
- 改进模型:加入更多相关变量,或使用正则化方法(如 Ridge/LASSO)。
3. 两者的关系与区别
| 概念 | 数学表达 | 影响 |
|---|---|---|
| 有偏但方差小 | ,但 小 | 牺牲无偏性以提升稳定性,适用于高维数据或共线性场景(如 Ridge 回归)。 |
| 误差方差大( 大) | 导致回归系数估计不精确、预测误差大,需通过增加数据或改进模型解决。 |
关键区别
- “有偏但方差小” 是人为选择的估计策略(如正则化),目的是优化模型性能。
- “误差方差大” 是数据本身的噪声问题,需通过数据或模型改进来缓解。
4. 实际案例
场景1:高共线性数据
- 问题:OLS 估计方差大,虽然无偏但不稳定。
- 解决:使用 Ridge 回归,接受小偏差以大幅降低方差。
场景2:高噪声数据(误差方差大)
- 问题:模型 低,预测误差大。
- 解决:
- 收集更多数据以减少估计方差。
- 检查是否遗漏重要变量,或使用更复杂的模型(如非线性回归)。
5. 总结
- “有偏但方差小”:是模型设计的选择(如正则化),用偏差换方差,提升泛化能力。
- “误差方差大”:是数据噪声问题,需通过增加样本或改进模型解决。
- 在回归分析中:
- 如果共线性严重,优先考虑有偏但低方差的方法(如 Ridge/LASSO)。
- 如果误差方差大,优先优化数据质量或模型复杂度。
- 先看相关性是否多重共线性,这一步不一定充足,如果和多个变量相关,就算两两低,可能也有相关性
- 看散点图,看看什么模型可能适合
- 建立方程
- 是否需要样条
- 选择子集
- 看残差图 方差是否合适
- 如果残差有趋势 对某个变量进行log等后 重新拟合 ?
- 离群点 强制点 杠杆点
- 看残差图 方差是否合适
faov 函数的内核使用了lm算法。
aov() 默认结果是基于Type I 平方和,而 lm() 默认(summary)的结果是Type III平方和。aov()分析的结果受自变量输入顺序的影响,而lm()与自变量输入顺序无关。当然这种差异是针对非平衡数据而言。对于平衡全处理的数据结构,二者分析的结果是一致的。
等组设计:每个因素的样本相同
Ⅲ型平方和与Ⅰ型平方和
如果是等组设计,这几种平方和没有任何区别。不同类型的平方和是针对非等组设计提出的。
I型平方和也叫顺序平方和,需要考虑各主效应的进入顺序。但I型平方和不正交,顺序不同计算出的结果也不同,不推荐使用。
II型平方和叫偏序平方和,不考虑主效应顺序,但在计算主效应时不考虑交互作用。如果各效应之间不存在交互作用,II型平方和效力较高
III型平方和也叫正交平方和,不考虑顺序,但不能将总平方和完全分解。目前非等组设计中推荐使用的是III型平方和
1. 各指标的核心特点
(1) 调整后的 (Adjusted )
- 公式:
- :样本量,:变量数。
- 优点:
- 对无关变量引入惩罚,比普通 更稳健。
- 解释直观(拟合优度的调整值)。
- 缺点:
- 仍可能偏向略复杂的模型(尤其当样本量小时)。
- 不适用于比较不同数据集或非线性模型。
- 适用场景:
- 初步筛选变量,快速排除明显无关变量。
(2) MSE(残差均方)
- 公式:
- 优点:
- 直接衡量预测误差,无标度限制。
- 适用于同数据集的模型比较。
- 缺点:
- 需结合自由度调整,否则会偏好复杂模型。
- 对异常值敏感。
- 适用场景:
- 配合交叉验证使用,评估预测性能。
(3) 统计量(Mallows’ )
- 公式:
- :全模型(包含所有变量)的误差方差估计。
- 优点:
- 专门针对线性回归设计,平衡偏差与方差。
- 目标明确:选择 的模型。
- 缺点:
- 依赖全模型的误差估计(若全模型很差, 不可靠)。
- 仅适用于线性模型。
- 适用场景:
- 线性回归的变量子集选择(如逐步回归)。
(4) AIC(赤池信息准则)
- 公式:
- 优点:
- 基于信息论,适用于广义模型(线性、非线性、混合效应等)。
- 强调简约性,惩罚复杂模型。
- 缺点:
- 样本量小时可能过拟合(此时可用 AICc 校正)。
- 适用场景:
- 通用模型选择(尤其是变量数较多或非线性场景)。
2. 指标对比与选择建议
| 指标 | 目标 | 惩罚机制 | 适用模型 | 推荐场景 |
|---|---|---|---|---|
| 调整 | 拟合优度 | 自由度调整 | 线性回归 | 初步筛选变量 |
| MSE | 预测误差 | 无直接惩罚 | 所有回归模型 | 需配合交叉验证使用 |
| 偏差-方差权衡 | 依赖全模型误差 | 线性回归 | 线性模型的变量选择 | |
| AIC | 信息损失最小化 | 惩罚项 | 广义模型 | 通用模型选择(首选) |
如何选择?
-
如果目标是预测且模型为线性:
- 优先 或 AIC,二者均能平衡复杂度与拟合。
- 更专一,AIC 更灵活。
-
如果模型包含非线性或广义结构(如逻辑回归、GLM):
- 只用 AIC( 不适用)。
-
如果样本量小(如 ):
- 使用 AICc(校正版AIC)或 BIC(更强惩罚)。
-
初步快速筛选:
- 用 调整 排除明显无关变量,但最终选择需依赖 AIC/。
(1) 计算所有指标
library(leaps)
data(mtcars)
model <- lm(mpg ~ ., data = mtcars)

# 计算调整R2、MSE、Cp、AIC
adj_r2 <- summary(model)$adj.r.squared
mse <- mean(residuals(model)^2)
cp <- olsrr::ols_mallows_cp(model, model_full = lm(mpg ~ ., data = mtcars))
aic <- AIC(model)

cat("Adjusted R2:", adj_r2, "\nMSE:", mse, "\nCp:", cp, "\nAIC:", aic)
(2) 自动选择最优子模型(基于AIC)
library(MASS)
step_model <- stepAIC(model, direction = "both")
summary(step_model)- 首选 AIC:通用性强,适用于大多数场景(线性/非线性)。
- 线性模型专用: 更直观,但需全模型支持。
- 调整 和 MSE:辅助参考,不宜单独用于决策。
- 样本量小:改用 AICc 或 BIC。
最终建议流程:
.
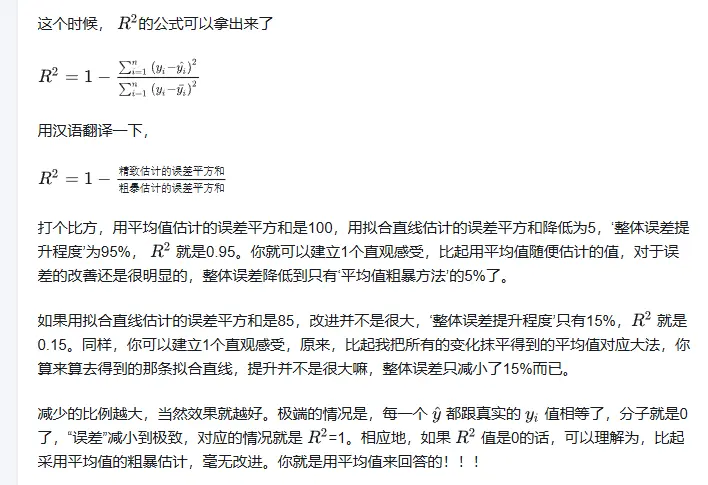
在得到回归方程后,需要通过交叉验证或测试集来评估模型的拟合效果和预测性能。常用的评估指标包括:

- **决定系数 R2:用来衡量模型的拟合效果,表示预测值与实际值之间的相关性。
- 均方误差(MSE):评估预测误差。
- 交叉验证:通过交叉验证来避免模型过拟合,并评估其泛化能力。
#1. 先观察是否直接使用线性拟合
library(ggplot2)
ggplot(mtcars, aes(x = wt, y = mpg)) +
    geom_point() +
    geom_smooth(method = "lm")

#2.拟合
model <- lm(mpg ~ wt + hp + factor(cyl), data = mtcars)
summary(model)

#3. 拟合诊断
par(mfrow = c(2, 2))
plot(model)  # 四图诊断(残差、QQ图等

#4.输出
library(gtsummary)
tbl_regression(model) %>%  # 生成出版级表格
    add_global_p() %>%       # 添加全局P值
    bold_p()

broom::tidy(model)

library (MASS)
library(broom)
model <- lm(hp ~ mpg + wt + drat + qsec, data=mtcars)
step.fit <- stepAIC(model, direction="both")


tidy(step(model, direction="both"))
tidy(stepAIC(model, direction="both"))
drop1(step.fit)  #如果还有不显著的,剔除单个变量后的AIC的变化,然后重新拟合
多个模型同时拟合
## 1. 加载必要包 ----
library(tidyverse)    # 数据处理与可视化
library(mgcv)        # GAM模型
library(rpart)       # 决策树
library(patchwork)   # 图形拼接
library(gtsummary)   # 模型结果表格
library(gt)         # 表格美化

## 2. 数据准备 ----
data(mtcars)
df <- mtcars %>% mutate(cyl = factor(cyl))  # 将气缸数转为因子

## 3. 拟合多个模型 ----

# 线性回归
fit_lm <- lm(mpg ~ wt + hp + cyl, data = df)

# 多项式回归(2阶)
fit_poly <- lm(mpg ~ poly(wt, 2) + hp + cyl, data = df)

# 广义可加模型
fit_gam <- mgcv::gam(mpg ~ s(wt) + s(hp) + cyl, data = df)

# 决策树
fit_tree <- rpart(mpg ~ wt + hp + cyl, data = df,
                  control = rpart.control(minsplit = 5))

## 4. 生成预测数据 ----
new_data <- expand.grid(
    wt = seq(min(df$wt), max(df$wt), length = 100),
    hp = median(df$hp),
    cyl = levels(df$cyl)
)

# 各模型预测
predictions <- new_data %>%
    mutate(
        LM = predict(fit_lm, newdata = new_data),
        Poly = predict(fit_poly, newdata = new_data),
        GAM = predict(fit_gam, newdata = new_data),
        Tree = predict(fit_tree, newdata = new_data)
    ) %>%
    pivot_longer(cols = c(LM, Poly, GAM, Tree),
                 names_to = "Model",
                 values_to = "Prediction")

## 5. 可视化 ----

# 5.1 拟合曲线对比
p_fit <- ggplot() +
    geom_point(data = df, aes(wt, mpg, color = cyl), size = 3, alpha = 0.7) +
    geom_line(data = predictions,
              aes(wt, Prediction, color = cyl, linetype = Model),
              linewidth = 1.2) +
    scale_linetype_manual(values = c("solid", "dashed", "dotdash", "twodash")) +
    labs(title = "不同模型对油耗(mpg)的拟合效果",
         subtitle = "按气缸数(cyl)分组",
         x = "车重 (wt)",
         y = "每加仑英里数 (mpg)",
         color = "气缸数",
         linetype = "模型") +
    theme_bw(base_size = 14) +
    theme(legend.position = "bottom")

# 5.2 残差对比
residuals <- df %>%
    mutate(
        LM = residuals(fit_lm),
        Poly = residuals(fit_poly),
        GAM = residuals(fit_gam),
        Tree = predict(fit_tree) - mpg
    ) %>%
    pivot_longer(cols = c(LM, Poly, GAM, Tree),
                 names_to = "Model",
                 values_to = "Residual")

p_resid <- ggplot(residuals, aes(wt, Residual, color = Model)) +
    geom_point(size = 3, alpha = 0.6) +
    geom_hline(yintercept = 0, linetype = "dashed", color = "red") +
    geom_smooth(se = FALSE, method = "loess", formula = y ~ x) +
    labs(title = "各模型残差分布",
         x = "车重 (wt)",
         y = "残差") +
    theme_bw(base_size = 14) +
    theme(legend.position = "bottom")

# 5.3 模型指标表格
model_metrics <- tibble(
    Model = c("线性回归", "多项式回归", "GAM", "决策树"),
    R2 = c(
        summary(fit_lm)$r.squared,
        summary(fit_poly)$r.squared,
        summary(fit_gam)$r.squared,
        cor(predict(fit_tree), df$mpg)^2
    ),
    RMSE = c(
        sqrt(mean(residuals(fit_lm)^2)),
        sqrt(mean(residuals(fit_poly)^2)),
        sqrt(mean(residuals(fit_gam)^2)),
        sqrt(mean((predict(fit_tree) - df$mpg)^2))
    ),
    AIC = c(
        AIC(fit_lm),
        AIC(fit_poly),
        AIC(fit_gam),
        NA  # 决策树不适用AIC
    )
)

tbl_metrics <- model_metrics %>%
    mutate(across(where(is.numeric), ~ round(., 3))) %>%
    gt() %>%
    tab_header(
        title = "模型性能对比",
        subtitle = "基于mtcars数据集"
    ) %>%
    fmt_missing(columns = everything(), missing_text = "-") %>%
    cols_label(
        Model = "模型",
        R2 = "R平方",
        RMSE = "均方根误差",
        AIC = "AIC值"
    ) %>%
    tab_style(
        style = cell_text(weight = "bold"),
        locations = cells_column_labels()
    )

## 6. 结果展示 ----

# 图形组合
(p_fit / p_resid) +
    plot_layout(guides = "collect") &
    theme(legend.position = "bottom")

# 显示性能指标表格
print(tbl_metrics)

## 7. 模型诊断图 ----
par(mfrow = c(2, 2))
plot(fit_lm, main = "线性回归诊断图")
plot(fit_poly, main = "多项式回归诊断图")
plot(fit_gam, main = "GAM诊断图", pages = 1)
rpart.plot::rpart.plot(fit_tree, main = "决策树结构")加权回归:比如历史早的数据,分配权重低一点
置换检验与回归系数
- 抽样 2.回归 3. 重复 4.90%的知晓区间,找出第5个和第95个百分位数的置信区间
回归方程中的共线性来源
- 变量重复多次
- 变量之间高度相关
- 因子变量加入P个而不是P-1个
混淆变量:缺少这个变量
交互项:1个变量的作用依赖于另一个变量