分段回归:因为确实在不同的范围有不同的走势
加权回归:wi(y-yi)
1. 稳健回归和加权线性回归都是要乘以 ,有什么不同?
是的,稳健回归(Robust Regression) 和 加权最小二乘回归(WLS, Weighted Least Squares) 都引入了权重 ,但两者权重的来源和目的不同:
| 项目 | 稳健回归 | 加权最小二乘回归 |
|---|---|---|
| 权重来源 | 根据残差大小自适应计算,如 Huber 或 Bisquare 函数 | 预先已知或基于异方差模型推导出的权重 |
| 目的 | 降低异常值(outliers)对回归结果的影响 | 纠正误差项的异方差性(非恒定方差) |
| 是否自适应 | 是,根据每次迭代残差更新权重 | 否,权重通常预先指定或基于模型估计 |
| 应用场景 | 数据中可能存在离群点 | 数据中存在异方差,但无明显异常值 |
2. 为什么稳健回归不需要关注 ?
稳健回归的目标是提高模型在存在异常值情况下的可靠性,而 是基于最小二乘残差定义的,用于衡量模型解释变异的能力,但在稳健回归中:
-
稳健残差不是平方误差,无法直接用于计算传统的 ;
-
对异常值非常敏感,反而可能误导你,以为模型拟合变好了;
-
更适合使用替代指标,如:
- 加权残差平方和(WRSS)
- 调整后的 MAD(Median Absolute Deviation)
- 交叉验证误差(CV error)
3. 稳健回归前如何提前判断异常点?
你可以通过以下方法在做稳健回归之前识别潜在异常值:
-
残差分析(Residual Plot)
- 标准化残差大于 ±2 或 ±3 可能是异常点;
-
杠杆值(Leverage)
- 利用 hat 矩阵 ,高杠杆点可能对模型影响大;
-
Cook’s Distance(库克距离)
- 衡量每个观测对回归系数的影响,常用阈值:;
-
DFBETAS、DFITS、COVRATIO 等诊断图
- 这些都可以直观地看出某些点的“影响力”;
-
箱线图/离群点检测
- 对于输入特征或响应变量,用箱线图等做统计分析辅助判断;
结论:先通过这些诊断手段识别潜在异常点,再决定是否采用稳健回归。
4. 有必要先做线性回归然后根据诊断图做稳健回归吗?
是的,这是推荐流程,原因如下:
-
标准线性回归提供诊断基础,用于绘制残差图、杠杆点图、Cook’s Distance 等;
-
可以判断是否存在:
- 异常值;
- 高杠杆点;
- 非正态分布残差;
- 异方差性;
-
如果诊断图显示问题不大,可能没必要做稳健回归;
-
如果发现异常点确实影响模型,可以改用稳健回归(如 Huber、MM、Bisquare 等)来减弱其影响;
| 问题 | 简要回答 |
|---|---|
| 1 | 都有权重,但稳健回归的权重是自适应调整的,目标是减小异常点影响;WLS 是处理异方差 |
| 2 | 稳健回归不适用 ,因为其基于非平方残差,不适合用作拟合优度指标 |
| 3 | 可用残差、杠杆值、Cook 距离等提前诊断异常点 |
| 4 | 推荐先做普通线性回归并画诊断图,发现异常情况后再做稳健回归 |
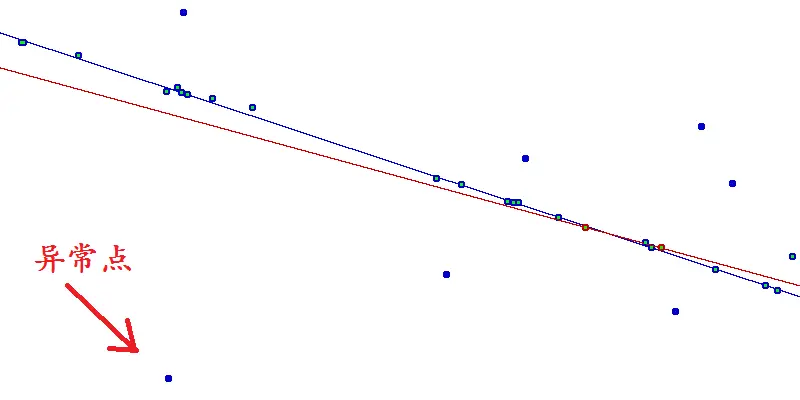 异常点并不能很好的确定,并没有一个很好的标准用于确定哪些点是异常点
即便确定了异常点,但这些被确定为异常的点,真的是错误的数据吗?很有可能这看似异常的点,就是原始模型的数据,如果是这样的话,那么这些异常的点就会带有大量的原始模型的信息,剔除之后就会丢失大量的信息。
再比如下面这幅图,其中红色的都是异常点,但是很难从数据中剔除出去。
Outlier: 存在大残差的观测值
Leverage: 自变量偏离均值的程度
Influential observation: 删除后会改变回归参数的估计值(Influence=leverage*outlier)
Cook’s Distance: 一种将leverage和residue结合的统计量
RANSAC随机采样一致性算法
RANSAC算法的输入是一组观测数据(往往含有较大的噪声或无效点),它是一种重采样技术(resampling technique),通过估计模型参数所需的最小的样本点数,来得到备选模型集合,然后在不断的对集合进行扩充,其算法步骤为:
随机的选择估计模型参数所需的最少的样本点。
估计出模型的参数。
找出在误差 ϵ 内,有多少点适合当前这个模型,并将这些点标记为模型内点
如果内点的数目占总样本点的比例达到了事先设定的阈值 τ ,那么基于这些内点重新估计模型的参数,并以此为最终模型, 终止程序。
否则重复执行1到4步。
RANSAC算法是从输入样本集合的内点的随机子集中学习模型。